
MySQL / 系统课时
判断 Nested Loop 与 Hash Join
判断 Nested Loop 与 Hash Join
看到 JOIN 计划时,先识别执行器是在“逐行探测另一张表”,还是“先构建哈希表再批量探测”。本课通过同一类等值连接对比 Nested Loop 与 Hash Join 的成本来源,并给出从 EXPLAIN FORMAT=TREE 判断算法的实用方法。
学习目标
- 说清 Nested Loop 与 Hash Join 的执行过程和主要成本
- 从 MySQL 8.0 的树形执行计划识别连接算法
- 根据索引、输入规模和过滤结果判断哪类算法更合理
两种算法在做不同的事
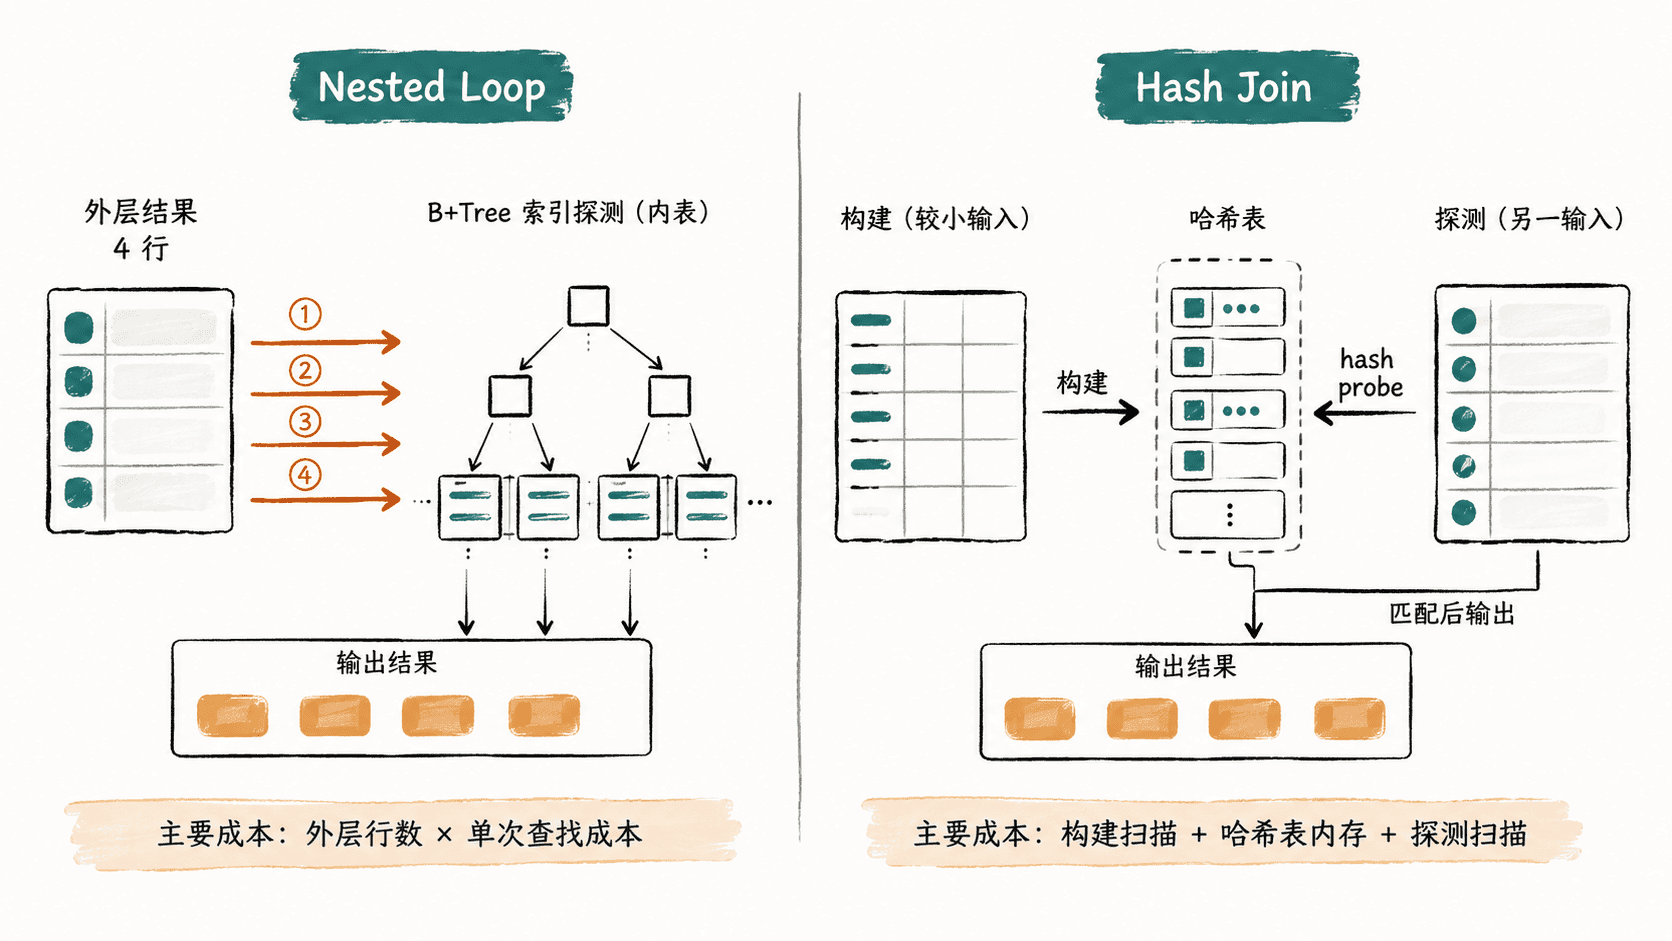
Nested Loop 把外层结果逐行拿出来,再对内层执行一次查找。若内层连接列有高效索引,单次查找成本很低,它尤其适合外层结果较小、内层可做主键或索引查找的场景。
Hash Join 则先选择一侧作为构建端,把连接键放入内存哈希表,再扫描另一侧作为探测端并计算哈希值寻找匹配。它省掉了大量重复索引查找,常见于等值连接且缺少有效索引、两侧都需要扫描较多行的情况。
用计划识别 Nested Loop
下面的示例让 customers.id 作为主键,orders.customer_id 有索引。查询先通过唯一邮箱定位一个客户,再按 customer_id 查订单,典型计划会呈现 Nested Loop 加 Index lookup。
DROP TABLE IF EXISTS orders;
DROP TABLE IF EXISTS customers;

CREATE TABLE customers (
  id BIGINT PRIMARY KEY,
  email VARCHAR(100) NOT NULL,
  UNIQUE KEY uk_customers_email (email)
);

CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  KEY idx_orders_customer (customer_id)
);

INSERT INTO customers VALUES
(1, 'a@example.com'),
(2, 'b@example.com');

INSERT INTO orders VALUES
(101, 1, 99.00),
(102, 1, 199.00),
(103, 2, 299.00);

EXPLAIN FORMAT=TREE
SELECT o.id, o.amount
FROM customers AS c
JOIN orders AS o
  ON o.customer_id = c.id
WHERE c.email = 'a@example.com';
预期输出的关键字是 Nested loop 与 Index lookup。成本和行数估算会因版本与统计信息不同而变化。
-> Nested loop inner join
    -> Index lookup on c using uk_customers_email (email='a@example.com')
    -> Index lookup on o using idx_orders_customer (customer_id=c.id)
这里外层通常只有 1 行,因此即使执行器采用逐行循环,也只需触发很少的内层索引查找。此时为连接键准备索引,比改成 Hash Join 更符合成本结构。
用计划识别 Hash Join
为了观察 Hash Join,可以使用两个没有连接键索引的临时测试表。MySQL 8.0.18 及以上版本在适用场景中可能选择哈希连接;实际计划仍由优化器根据数据规模和统计信息决定。
DROP TABLE IF EXISTS left_events;
DROP TABLE IF EXISTS right_events;

CREATE TABLE left_events (
  id BIGINT PRIMARY KEY,
  group_id INT NOT NULL
);

CREATE TABLE right_events (
  id BIGINT PRIMARY KEY,
  group_id INT NOT NULL
);

INSERT INTO left_events VALUES
(1, 10), (2, 20), (3, 30), (4, 40);

INSERT INTO right_events VALUES
(101, 10), (102, 10), (103, 30), (104, 50);

EXPLAIN FORMAT=TREE
SELECT l.id, r.id
FROM left_events AS l
JOIN right_events AS r
  ON l.group_id = r.group_id;
当优化器选择 Hash Join 时,计划关键形态会出现 Hash join 和 Hash;不同 MySQL 8.0 小版本可能调整节点文字或选择其他合法计划。
-> Inner hash join (r.group_id = l.group_id)
    -> Table scan on r
    -> Hash
        -> Table scan on l
如果你的实例没有出现 Hash Join,不要把这当成错误。小表、统计信息、内存成本或版本差异都可能让优化器选择 Nested Loop;判断算法应以实际 EXPLAIN FORMAT=TREE 输出为准。
比较成本时看三个量
Nested Loop 的近似思路是:外层输出行数 × 内层单次访问成本。只要外层很小且内层索引高度选择性,乘积通常也很小。若外层输出几十万行,即使每次索引查找都不算慢,累计随机访问也可能变得昂贵。
Hash Join 的主要成本是构建端扫描、哈希表占用与探测端扫描。它不依赖连接键 B+Tree 索引完成逐行探测,但构建端过大时会增加内存压力,内存不足还可能引入额外代价。因此不能只看到 Hash join 就认为一定更快。
| 判断信号 | Nested Loop 更有利 | Hash Join 更有利 |
|---|---|---|
| 外层结果 | 很小 | 较大 |
| 内层连接键索引 | 有高选择性索引 | 无有效索引 |
| 访问模式 | 少量精准查找 | 大量扫描后匹配 |
| 主要风险 | 重复探测次数过多 | 构建哈希表过大 |
优化时先改数据访问条件
如果 Nested Loop 慢,先确认外层是否被过滤到足够小、内层连接键是否有正确索引,以及估算行数是否明显失真。如果 Hash Join 慢,则要检查构建端是否过大、过滤条件是否能提前生效,以及是否本应通过索引避免全量扫描。
实际排查时,把 EXPLAIN FORMAT=TREE 中的算法节点与每个子节点的访问方式一起读:Nested loop + Index lookup 往往是一组合理组合,Hash join + Table scan 也可能是另一组合理组合。只有把连接算法和输入规模放在一起,计划才有可解释的性能含义。