
MySQL / 系统课时
判断子查询改写与半连接
判断子查询改写与半连接
面对 IN、EXISTS 或相关子查询,真正要判断的不是“有没有子查询”,而是优化器能否把它改造成一次连接式执行,以及是否仍会按外层行重复运行。本课用可复现实验和执行计划,建立判断 semijoin、手工改写与保留子查询的顺序。
学习目标
- 判断
IN、EXISTS是否具备 semijoin 改写条件 - 从执行计划识别去重、物化或提前命中的执行思路
- 识别相关子查询重复执行与
NOT IN的空值风险
先分清语义再谈改写
半连接只回答一个问题:外层行在内层是否存在匹配。即使内层有多条匹配记录,外层行也只能返回一次。因此,IN 或 EXISTS 不能机械地改成普通 JOIN;普通连接可能把外层行复制多次。
MySQL 8.x 会对符合条件的 IN、EXISTS 等子查询尝试 semijoin 优化。优化器仍要根据基数、索引和成本选择具体策略,例如提前停止匹配、先把内层结果物化并去重,或对重复匹配做 weedout。计划最后长得像普通连接并不代表语义变成了普通连接。
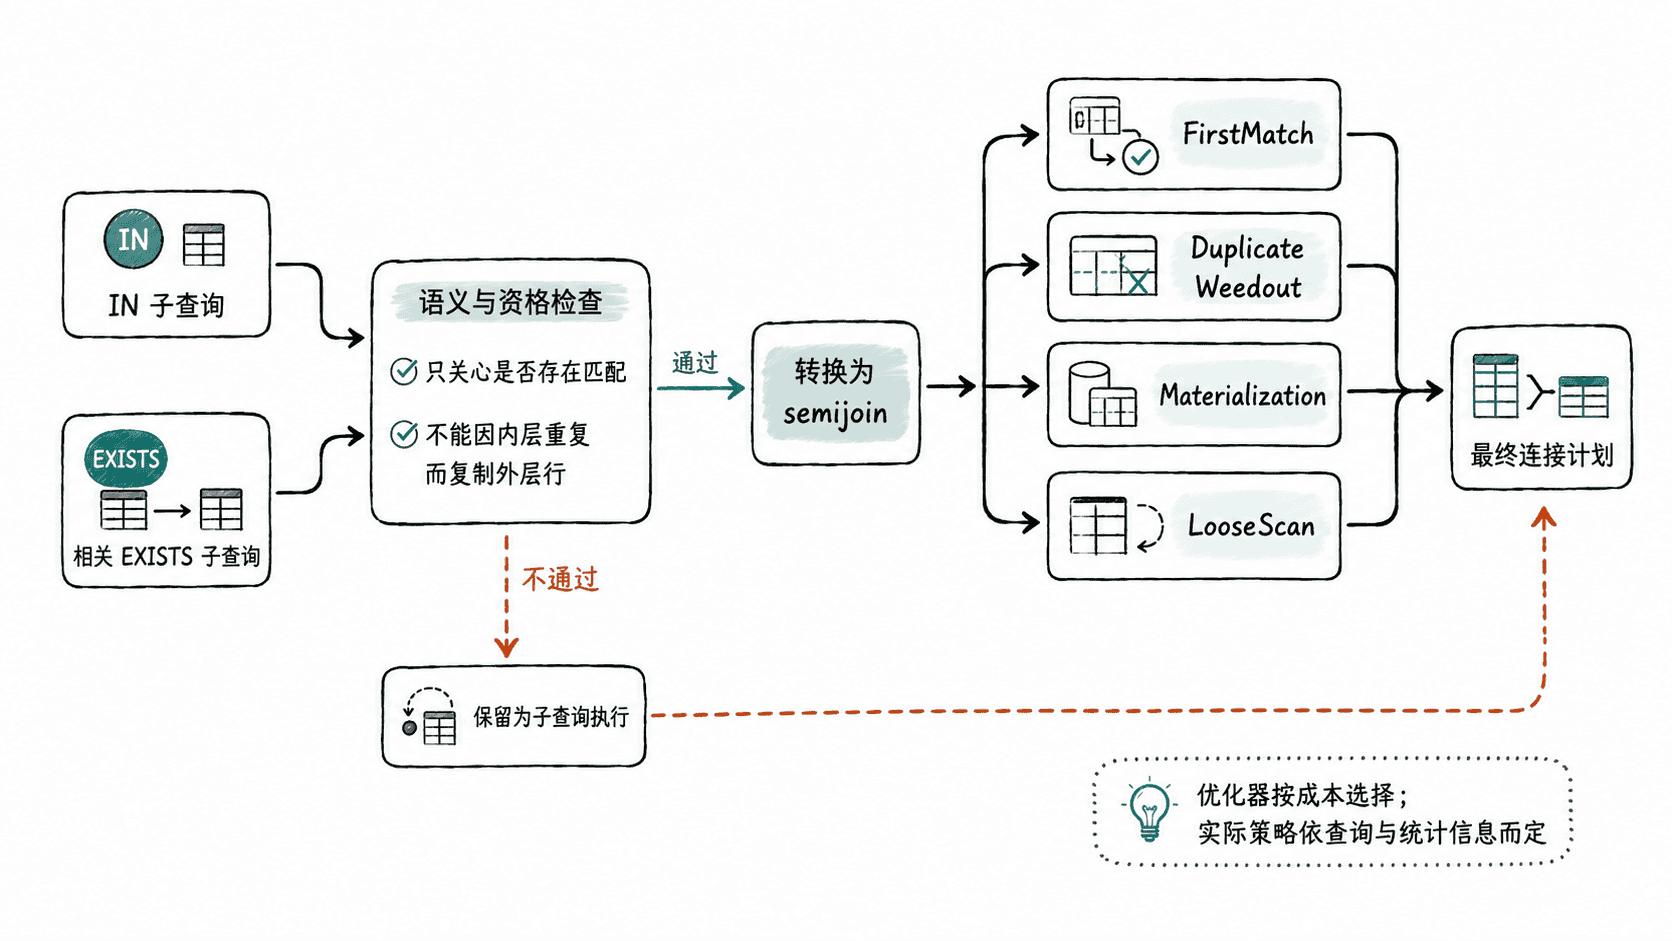
用执行计划验证 semijoin
下面建立一个允许同一客户出现重复 vip 标签的表。这样能直接观察半连接为何必须保留“只返回一次外层行”的语义。
DROP TABLE IF EXISTS customer_tags;
DROP TABLE IF EXISTS orders;

CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  KEY idx_customer_id (customer_id)
);

CREATE TABLE customer_tags (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  tag VARCHAR(20) NOT NULL,
  KEY idx_tag_customer (tag, customer_id)
);

INSERT INTO orders VALUES
  (1, 101, 120.00),
  (2, 102, 80.00),
  (3, 103, 200.00);

INSERT INTO customer_tags VALUES
  (1, 101, 'vip'),
  (2, 101, 'vip'),
  (3, 103, 'vip');

EXPLAIN FORMAT=TREE
SELECT o.id, o.customer_id
FROM orders AS o
WHERE o.customer_id IN (
  SELECT ct.customer_id
  FROM customer_tags AS ct
  WHERE ct.tag = 'vip'
);

SELECT o.id, o.customer_id
FROM orders AS o
WHERE o.customer_id IN (
  SELECT ct.customer_id
  FROM customer_tags AS ct
  WHERE ct.tag = 'vip'
);
预期结果
EXPLAIN 的具体节点、成本和行数会随 MySQL 版本与统计信息变化,但应体现“只判断是否存在匹配”的连接式执行,而不是把 customer_tags 的两条 101 记录复制成两条订单结果。

查询结果:
id  customer_id
1   101
3   103
如果把最后一条查询直接改成 JOIN customer_tags,订单 1 会因为两条 vip 记录出现两次。只有在内层连接键本身唯一,或你显式先去重时,普通 JOIN 才与半连接语义等价。
判断相关子查询是否重复执行
“相关”并不自动等于“每行执行一次”,因为优化器可能把部分相关 EXISTS 去相关并转成 semijoin。判断时不要只读 SQL 形状,应使用 EXPLAIN ANALYZE 查看真实循环次数。
EXPLAIN ANALYZE
SELECT o.id
FROM orders AS o
WHERE EXISTS (
  SELECT 1
  FROM customer_tags AS ct
  WHERE ct.customer_id = o.customer_id
    AND ct.tag = 'vip'
);
预期结果
关注实际计划中的 loops、rows 与连接节点。若 EXISTS 已被改造成 semijoin,通常会看到内外表处于同一连接执行路径;若计划保留独立相关子查询节点,并且该节点 loops 接近外层输入行数,就说明存在重复执行成本。具体节点名称和数值可能不同。真正需要警惕的是无法半连接化的相关标量子查询,例如外层每行都计算一次聚合值。此时应重点比较“重复探测内层索引”的总代价,与“先聚合成派生结果再连接”的代价,而不是看到相关子查询就立即重写。
处理边界与反例
NOT IN 最容易因为 NULL 产生语义差异:只要内层结果可能含 NULL,判断就可能变成 UNKNOWN,和直觉中的“没有匹配就返回”不同。需要反连接语义时,优先确认列是否 NOT NULL,或者改写为能明确表达空值规则的 NOT EXISTS。
手工改写前按这个顺序判断:先确认存在性语义,再看 EXPLAIN 是否已经 semijoin 化;只有计划仍存在高循环次数、内层代价显著,或索引无法支撑时,再考虑去重后连接、预聚合或补索引。这样避免为了“消灭子查询”反而制造重复行和更大的中间结果。