
MySQL / 系统课时
按等值与范围条件设计联合索引
按等值与范围条件设计联合索引
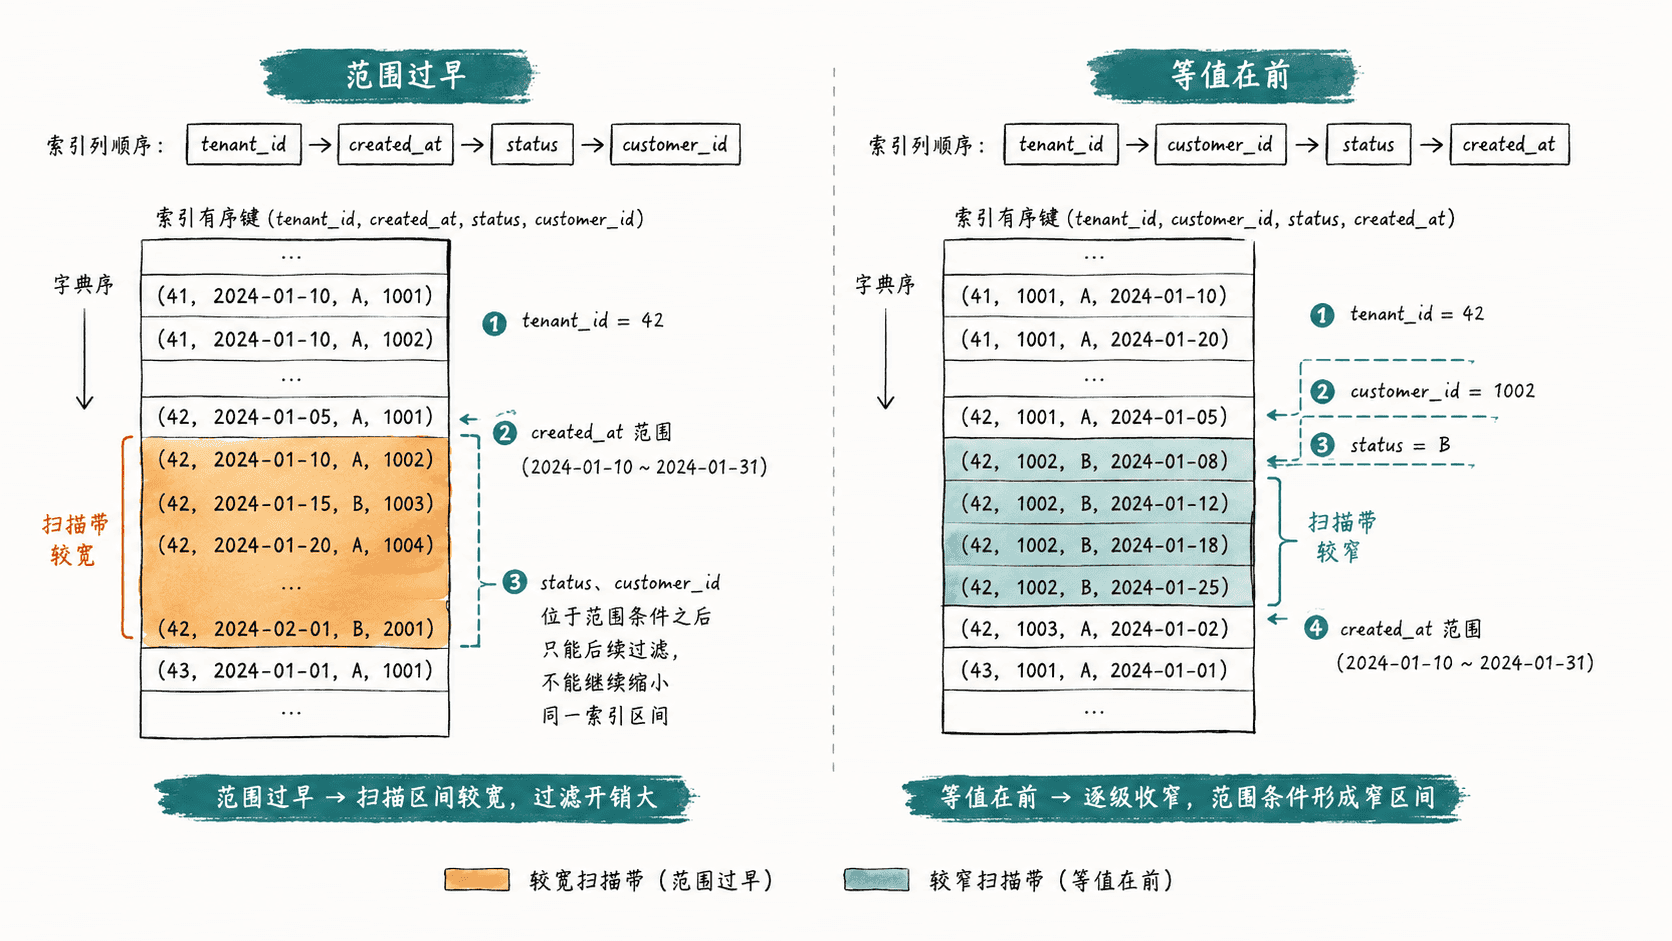
联合索引不是把 WHERE 中出现的列全部按“选择性从高到低”排列。真正要控制的是 B-Tree 的左侧连续前缀:先让常用等值条件确定尽可能窄的前缀,再把首个范围条件接在后面,并明确范围之后的列通常不能继续缩小同一个扫描区间。
学习目标
- 能把查询条件拆成等值条件与范围条件,并据此安排联合索引
- 能解释为什么首个范围条件会截断后续键部件的区间定位能力
- 能结合选择性和主查询模式,而不是机械套用“高选择性优先”
先把条件分成等值与范围
考虑订单列表查询:tenant_id = 42、customer_id = 9001、status = 'PAID' 都是等值条件,created_at >= ... AND created_at < ... 是范围条件。对 B-Tree 联合索引,键值按列顺序做字典序排列;当前键部件保持等值时,优化器还能继续使用下一键部件收窄区间,一旦遇到 >、<、BETWEEN 等范围比较,后续键部件通常不再参与这个扫描区间的边界构造。
这并不等于范围后的列“完全没用”。如果这些列仍在索引中,它们可能用于 Index Condition Pushdown、覆盖查询或其他优化;只是不能再把前面已经形成的范围继续切成更窄的连续索引区间。
用同一查询比较两种列顺序
下面同时创建一个“范围过早”的索引和一个“等值在前”的索引。示例数据只用于让 SQL 可直接运行,执行计划中的 cost 和估算行数会随版本与统计信息变化。
DROP TABLE IF EXISTS index_orders;

CREATE TABLE index_orders (
    id BIGINT PRIMARY KEY,
    tenant_id INT NOT NULL,
    customer_id BIGINT NOT NULL,
    status VARCHAR(16) NOT NULL,
    created_at DATETIME NOT NULL,
    amount DECIMAL(10,2) NOT NULL,
    KEY idx_bad (tenant_id, created_at, status, customer_id),
    KEY idx_good (tenant_id, customer_id, status, created_at)
) ENGINE=InnoDB;

INSERT INTO index_orders
    (id, tenant_id, customer_id, status, created_at, amount)
VALUES
    (1, 42, 9001, 'PAID', '2026-09-02 09:00:00', 100.00),
    (2, 42, 9001, 'PAID', '2026-09-12 10:00:00', 120.00),
    (3, 42, 9002, 'PAID', '2026-09-14 11:00:00', 80.00),
    (4, 42, 9001, 'NEW',  '2026-09-16 12:00:00', 90.00),
    (5, 42, 9001, 'PAID', '2026-10-02 13:00:00', 70.00),
    (6, 7,  9001, 'PAID', '2026-09-18 14:00:00', 60.00),
    (7, 42, 9003, 'NEW',  '2026-09-20 15:00:00', 50.00),
    (8, 42, 9001, 'PAID', '2026-09-28 16:00:00', 110.00);

SELECT COUNT(*) AS row_count FROM index_orders;
预期结果(前置 DDL/DML 均成功,最后一个 SELECT 返回)
+-----------+
| row_count |
+-----------+
|         8 |
+-----------+
再对同一查询分别强制两种索引,观察 TREE 计划中用于构造范围的键部件。FORCE INDEX 仅用于稳定教学对比。
EXPLAIN FORMAT=TREE
SELECT id, amount
FROM index_orders FORCE INDEX (idx_bad)
WHERE tenant_id = 42
  AND customer_id = 9001
  AND status = 'PAID'
  AND created_at >= '2026-09-01 00:00:00'
  AND created_at <  '2026-10-01 00:00:00';

EXPLAIN FORMAT=TREE
SELECT id, amount
FROM index_orders FORCE INDEX (idx_good)
WHERE tenant_id = 42
  AND customer_id = 9001
  AND status = 'PAID'
  AND created_at >= '2026-09-01 00:00:00'
  AND created_at <  '2026-10-01 00:00:00';
预期结果
idx_bad:
-> Index range scan on index_orders using idx_bad over (tenant_id equality + created_at range) ... (cost=<VALUE> rows=<VALUE>)

idx_good:
-> Index range scan on index_orders using idx_good over (tenant_id + customer_id + status equalities + created_at range) ... (cost=<VALUE> rows=<VALUE>)
不同版本的 TREE 文本可能略有差异,重点看 over (...) 或等价的范围描述:idx_bad 在 created_at 处已经进入范围,后面的 status、customer_id 不能继续构造边界;idx_good 则先用三个等值条件确定更窄前缀,再进入时间范围。
选择性要服从主查询模式
“等值列放前、范围列放后”是起点,不是完整答案。若多个等值条件总是同时出现,它们都可以组成连续等值前缀;此时列顺序更应考虑哪些查询会省略某些条件、每列的选择性以及索引复用价值。
例如 customer_id 在租户内通常比 status 更有选择性,而且主查询始终带客户条件,那么把 customer_id 放在时间范围之前可以更早缩小候选集合。但如果大量核心查询只按 tenant_id + status + created_at 拉取租户订单,而并不提供 customer_id,把 customer_id 固定在第二位反而会破坏这类查询对后续列的左前缀利用。
一个更可靠的设计顺序是:先列出最高频、最重要的查询模式;保证它们能从索引最左侧连续使用必要的等值条件;把第一个不可避免的范围条件放在这段等值前缀之后;最后再评估是否追加列用于过滤或覆盖。
验证时区分定位、过滤与覆盖
判断联合索引是否合理,不要只看“用了哪个 key”。真正要问的是:索引扫描区间由哪些键部件构成、预计扫描多少行、范围后的谓词只是过滤还是仍能避免回表。TREE 计划中的范围描述最适合确认“定位边界”,传统 EXPLAIN 的 key_len 可以辅助判断该访问路径可使用的键前缀最大长度。
最终应把“列顺序”理解成对扫描空间的设计:等值前缀负责把搜索位置压窄,首个范围条件负责确定连续区间,范围后的列则主要承担进一步过滤或覆盖职责。