
MySQL / 系统课时
用 optimizer_trace 解释计划选择
用 optimizer_trace 解释计划选择
EXPLAIN 能告诉你优化器最后选了什么,却不一定说明“为什么没选另一个索引或连接顺序”。本节用 optimizer_trace 把候选访问路径、估算行数、成本与连接顺序串起来,形成可复用的计划解释方法。
学习目标
- 正确启用、读取并关闭当前会话的
optimizer_trace。 - 从 trace 中定位候选索引、访问方式、成本和淘汰原因。
- 把
considered_execution_plans与最终EXPLAIN计划对应起来。
准备一条存在竞争路径的查询
实验用两张小表,并在订单表上准备两个不同方向的索引:一个偏向连接键,一个偏向状态过滤与时间顺序。这样优化器至少需要比较“谁先驱动”和“订单表走哪条访问路径”。
DROP TABLE IF EXISTS trace_orders;
DROP TABLE IF EXISTS trace_customers;

CREATE TABLE trace_customers (
    id INT PRIMARY KEY,
    region VARCHAR(16) NOT NULL,
    INDEX idx_region (region)
);

CREATE TABLE trace_orders (
    id BIGINT PRIMARY KEY,
    customer_id INT NOT NULL,
    status VARCHAR(16) NOT NULL,
    created_at DATETIME NOT NULL,
    INDEX idx_customer_status (customer_id, status),
    INDEX idx_status_created (status, created_at)
);

INSERT INTO trace_customers VALUES
(1, 'EAST'), (2, 'EAST'), (3, 'WEST'),
(4, 'WEST'), (5, 'WEST'), (6, 'WEST');

INSERT INTO trace_orders VALUES
(101, 1, 'PAID', '2026-01-01 10:00:00'),
(102, 1, 'NEW',  '2026-01-02 10:00:00'),
(103, 1, 'PAID', '2026-01-03 10:00:00'),
(104, 2, 'PAID', '2026-01-04 10:00:00'),
(105, 2, 'NEW',  '2026-01-05 10:00:00'),
(106, 3, 'PAID', '2026-01-06 10:00:00'),
(107, 3, 'NEW',  '2026-01-07 10:00:00'),
(108, 4, 'PAID', '2026-01-08 10:00:00'),
(109, 4, 'NEW',  '2026-01-09 10:00:00'),
(110, 5, 'PAID', '2026-01-10 10:00:00'),
(111, 5, 'NEW',  '2026-01-11 10:00:00'),
(112, 6, 'PAID', '2026-01-12 10:00:00');

SELECT
    (SELECT COUNT(*) FROM trace_customers) AS customers,
    (SELECT COUNT(*) FROM trace_orders) AS orders_count;
预期结果
customers  orders_count
6          12
按正确顺序抓取 trace
trace 只记录当前会话内被跟踪的语句。最稳妥的流程是:启用跟踪,执行目标 EXPLAIN,立刻读取 INFORMATION_SCHEMA.OPTIMIZER_TRACE,最后关闭跟踪,避免后续操作干扰本次定位。
SET optimizer_trace = 'enabled=on,one_line=off';
SET optimizer_trace_max_mem_size = 1048576;

EXPLAIN
SELECT o.id, c.region, o.created_at
FROM trace_customers AS c
JOIN trace_orders AS o
  ON o.customer_id = c.id
WHERE c.region = 'EAST'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 20;

SELECT
    JSON_PRETTY(TRACE) AS trace_json,
    MISSING_BYTES_BEYOND_MAX_MEM_SIZE,
    INSUFFICIENT_PRIVILEGES
FROM INFORMATION_SCHEMA.OPTIMIZER_TRACE;

SET optimizer_trace = 'enabled=off';
预期结果
EXPLAIN 返回当前优化器选择的访问顺序与索引。
trace_json 中包含 steps 等优化过程结构。
MISSING_BYTES_BEYOND_MAX_MEM_SIZE = 0 表示本次 trace 未因内存上限被截断。
INSUFFICIENT_PRIVILEGES = 0 表示当前用户有权看到完整 trace。
具体索引、rows 与 cost 以本机输出 <VALUE> 为准。
如果 MISSING_BYTES_BEYOND_MAX_MEM_SIZE 大于 0,先提高会话级 optimizer_trace_max_mem_size 再复现;否则你看到的“原因”可能只是被截断后的残片。
从候选访问路径读到连接顺序
不要从 JSON 顶部逐行硬读。解释计划时重点追踪 join_optimization 下与行数、范围分析和计划枚举有关的节点,再把候选压缩成“路径—行数—成本—是否选中”四件事。
| trace 位置或字段 | 主要回答的问题 |
|---|---|
rows_estimation、range_analysis |
条件能把表缩到多少行,哪些索引具备范围访问资格 |
potential_range_indexes |
哪些索引被范围优化器视为候选,哪些不可用 |
considered_access_paths |
对当前表比较了 scan、ref、range 等哪些访问方式 |
cost、records |
单条候选路径的估算成本与行数 |
considered_execution_plans |
不同连接前缀、下一张表和访问方式如何组合 |
cost_for_plan、records_for_plan |
当前连接前缀累计到这里的总成本与总行数 |
chosen、cause |
某候选是否被选中,以及未选中的直接原因 |
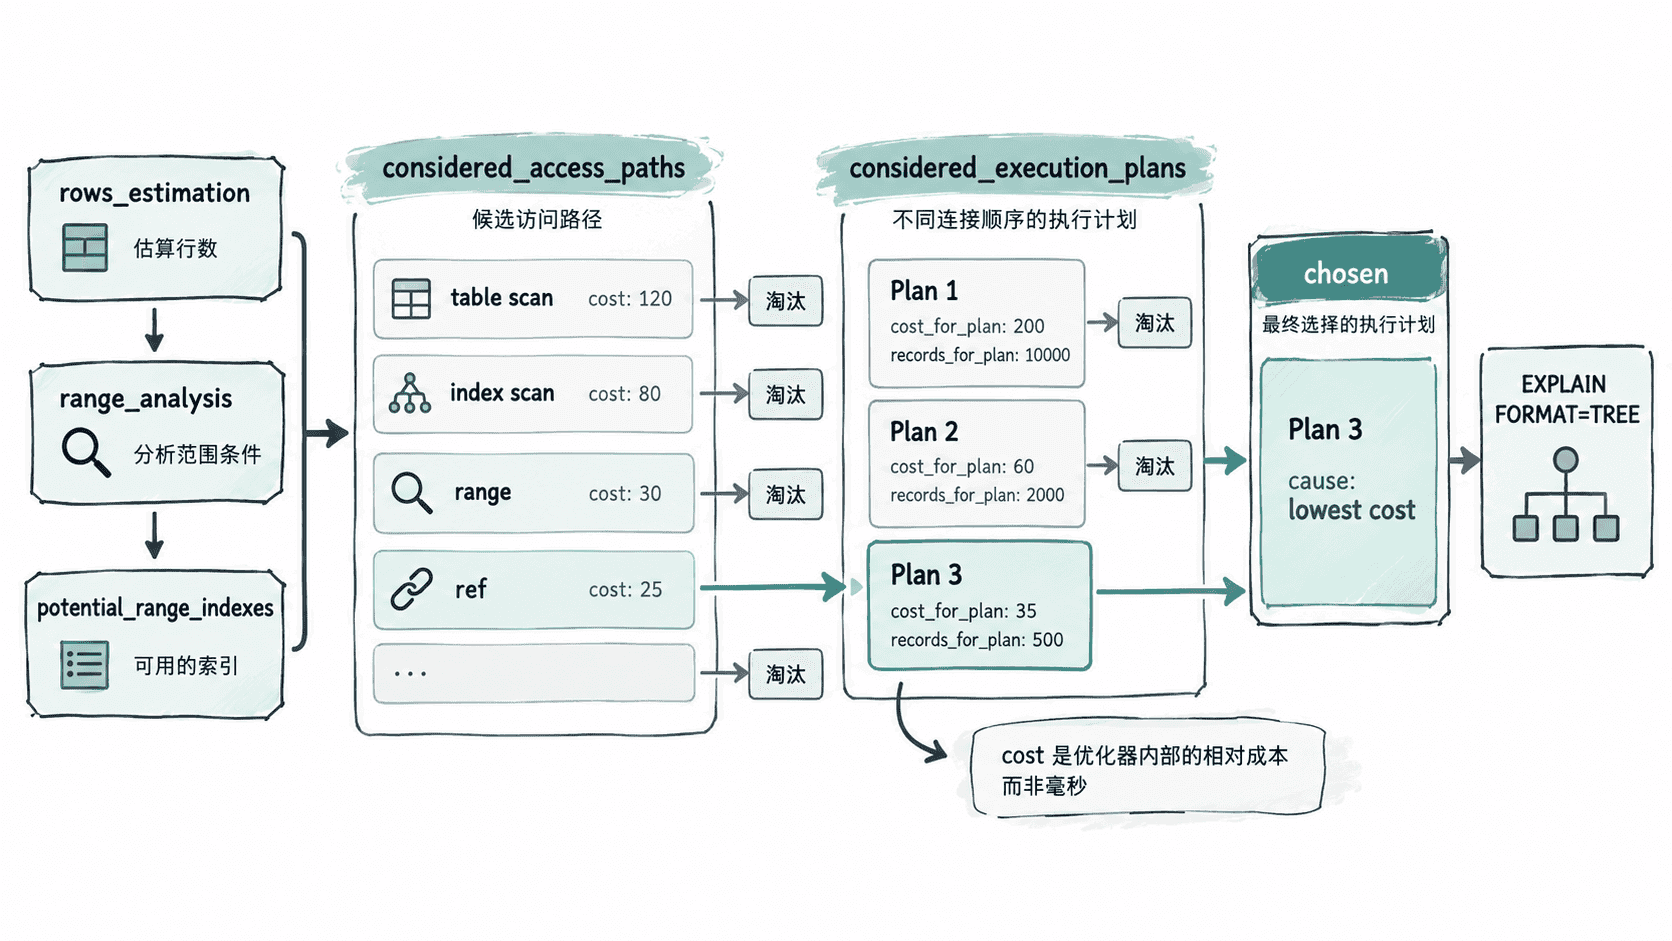
这里的 cost 是优化器内部成本模型用于比较方案的相对值,不等于毫秒。也不要只盯某张表最便宜的单次访问:连接顺序改变后,外层输出行数会放大或缩小后续访问次数,因此最终要比较的是整个连接前缀的累计成本。
把 trace 与 EXPLAIN 对上
读完 trace 后,再用同一条 SQL 查看更直观的树形计划。目标不是让两个输出逐字相同,而是确认 trace 中最终选中的驱动顺序、访问方式和索引,能在 EXPLAIN FORMAT=TREE 中找到对应结果。
EXPLAIN FORMAT=TREE
SELECT o.id, c.region, o.created_at
FROM trace_customers AS c
JOIN trace_orders AS o
  ON o.customer_id = c.id
WHERE c.region = 'EAST'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 20;
预期结果
输出为树形执行计划。
首张访问表、后续表的 lookup/scan 方式及使用的索引,应与 optimizer_trace 最终 chosen 的计划一致。
具体 cost、rows 与是否需要 sort 由本机统计信息决定,记为 <VALUE>。
如果 EXPLAIN 里出现了你不理解的索引选择,优先回到 trace 检查三件事:候选索引是否进入 potential_range_indexes,候选路径的 records 是否估得异常,以及更便宜的局部路径是否因为连接前缀累计成本或排序需求而被淘汰。
生产排查时别把 trace 当运行时剖析
optimizer_trace 解释的是优化阶段如何做决定,不是查询实际在哪个算子耗时。要判断估算与真实执行的偏差,应把它与 EXPLAIN ANALYZE、慢查询指标和运行时等待信息配合使用。
当你能把“候选为什么能进入比较、估算了多少行、成本如何累计、为什么被淘汰”连成一条链时,optimizer_trace 才真正补上了 EXPLAIN 缺失的决策过程。