
MySQL / 系统课时
理解 B+Tree 搜索与回表
理解 B+Tree 搜索与回表
索引命中并不意味着一次查找就结束。本课从 InnoDB 的 B+Tree 定位过程出发,跟踪等值查询、范围查询以及二级索引命中后的数据读取路径,并据此判断一次查询是否需要回表。
学习目标
- 说明等值查找与范围查找如何沿 B+Tree 定位叶子记录
- 区分聚簇索引与二级索引叶子节点保存的内容
- 根据查询列判断是否发生回表,以及覆盖索引何时能够避免回表
从 B+Tree 定位叶子记录
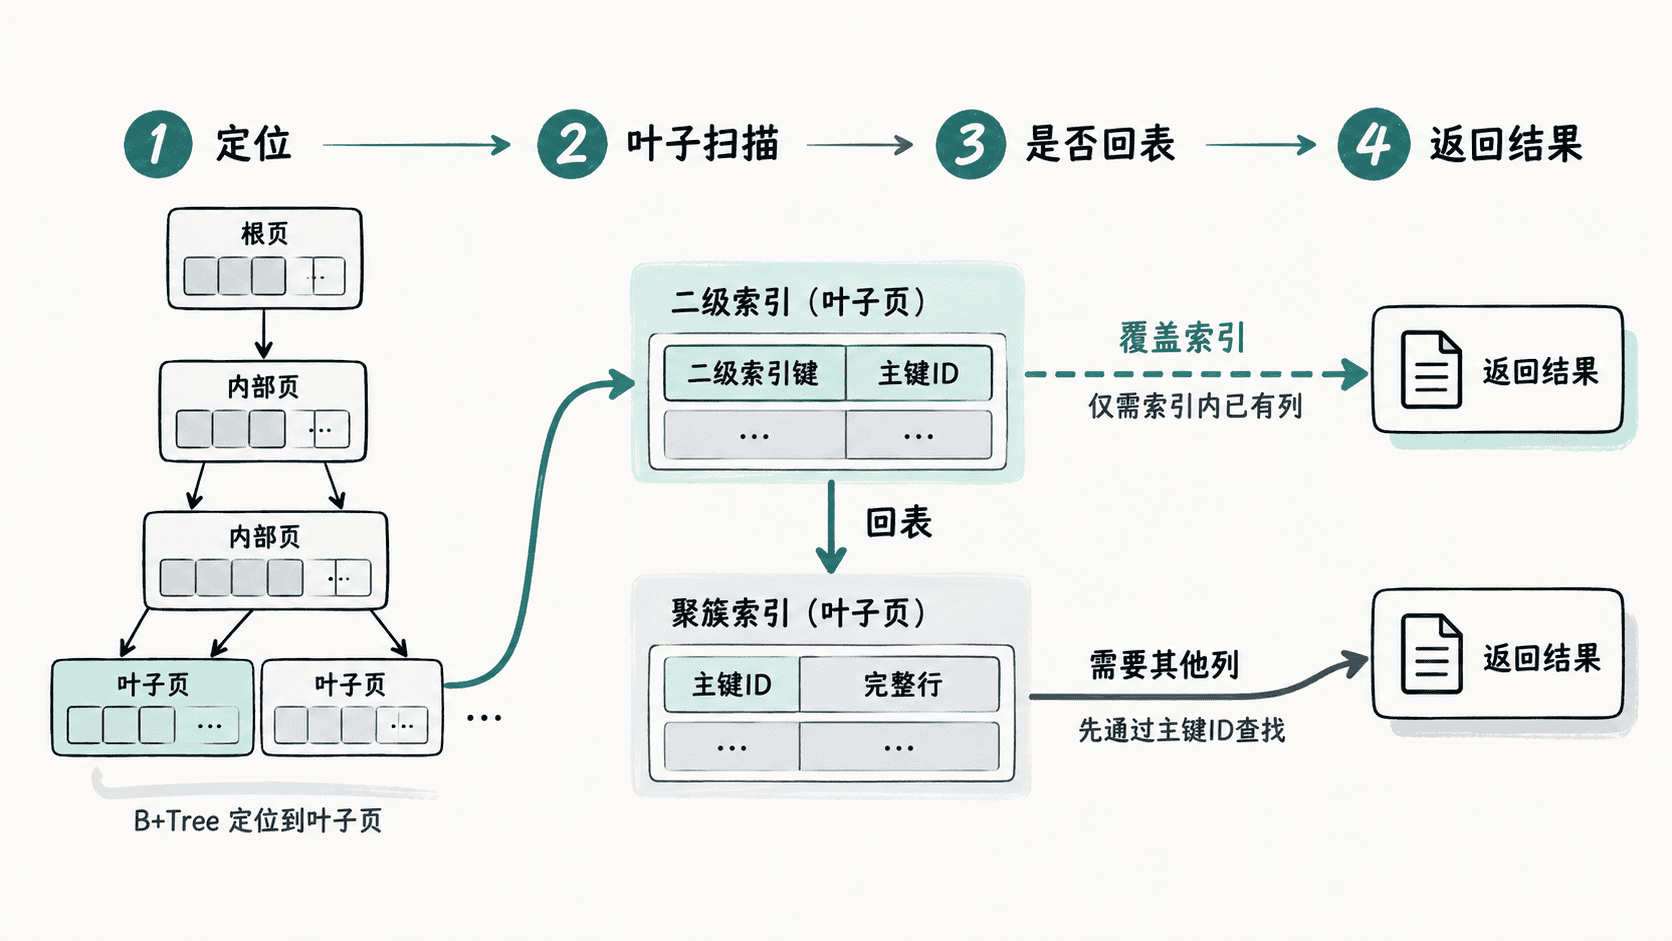
InnoDB 的索引使用 B+Tree 组织有序键值。查找从根页开始,根据目标键落入的区间选择子页,经过若干内部页后到达叶子页。树高通常较低,因此定位单个键通常只需要访问少量索引页。
等值查询到达目标叶子页后即可确定匹配记录;范围查询则先定位范围下界,再沿有序叶子页继续扫描,直到遇到超过上界的键。因此范围越宽,需要检查的叶子记录通常越多。
二级索引为什么还要回表
InnoDB 表的主键索引同时是聚簇索引,它的叶子记录保存完整行。普通二级索引的叶子记录保存二级索引键,并携带对应行的主键值,而不会再复制整行数据。
| 访问对象 | 叶子记录主要保存内容 | 能否直接取得完整行 |
|---|---|---|
| 主键聚簇索引 | 主键与完整行 | 可以 |
| 二级索引 | 二级索引键与主键值 | 通常不可以 |
下面建立一个最小示例,强制使用 idx_city,观察同一个过滤条件在查询不同列时的区别。
DROP TABLE IF EXISTS demo_users;

CREATE TABLE demo_users (
    id BIGINT PRIMARY KEY,
    email VARCHAR(128) NOT NULL,
    city VARCHAR(32) NOT NULL,
    display_name VARCHAR(64) NOT NULL,
    KEY idx_city (city)
) ENGINE = InnoDB;

INSERT INTO demo_users (id, email, city, display_name) VALUES
    (1, 'a@example.com', 'Shanghai', 'Alice'),
    (2, 'b@example.com', 'Shanghai', 'Bob'),
    (3, 'c@example.com', 'Beijing', 'Carol'),
    (4, 'd@example.com', 'Shenzhen', 'David');

-- 非覆盖查询:display_name 不在二级索引中,需要继续访问聚簇索引
EXPLAIN
SELECT id, display_name
FROM demo_users FORCE INDEX (idx_city)
WHERE city = 'Shanghai';

-- 覆盖查询:city 与二级索引叶子中的主键 id 都可直接取得
EXPLAIN
SELECT id, city
FROM demo_users FORCE INDEX (idx_city)
WHERE city = 'Shanghai';
预期结果
第一条 EXPLAIN:key 为 idx_city。二级索引能够找到 city 和主键 id,但 display_name 不在该索引中,因此执行阶段还需要按 id 读取聚簇索引记录。
第二条 EXPLAIN:key 为 idx_city,Extra 中可看到 Using index。查询只需要 city 和隐含保存于二级索引叶子中的主键 id,可以直接由索引返回。
EXPLAIN 中的行数估计可能随统计信息变化,但两条查询是否覆盖索引的差异不会因此改变。
回表次数为什么会影响成本
如果二级索引只匹配一两行,额外读取聚簇索引的代价通常很小。问题出现在低选择性条件或较宽范围上:二级索引扫描得到大量主键后,还要继续读取大量聚簇索引记录,随机访问和页面读取成本都会累积。
例如查询 city = 'Shanghai' 时,如果表中大部分记录都属于 Shanghai,即使存在 idx_city,通过二级索引找到大量主键再逐行回表,也可能比顺序扫描更贵。优化器因此不会因为 WHERE 条件存在索引就必然选择该索引。
范围查询同样如此。对于 city >= 'Beijing' AND city < 'Shenzhen',执行器先在 idx_city 中定位下界,再连续扫描范围内的索引记录;如果还要读取 display_name,每个满足条件的主键都可能产生后续的聚簇索引访问。
用覆盖索引消除必要的回表
所谓覆盖索引,不是一种独立索引类型,而是当前查询需要的列恰好都能从某个索引中取得。前面的 SELECT id, city 就已经被 idx_city 覆盖,因为 InnoDB 二级索引叶子中同时保存了主键 id。
如果高频查询固定为按城市取得名称,可以考虑把名称加入索引,例如 (city, display_name)。这样能够减少回表,但索引本身会变宽,写入、页分裂、缓存占用和维护成本也会增加,因此不能为了消除所有回表而无限扩展索引列。
判断一次查询的访问成本时,应同时问三个问题:索引能够把候选记录缩小到多少行、每个候选记录是否需要回表、最终返回的列是否值得通过覆盖索引优化。少量回表通常无需处理,大量扫描再大量回表才是更值得关注的信号。