
HTTP 与 Web 标准 / 系统课时
HTTP/2 还有哪些队头阻塞
HTTP/2 还有哪些队头阻塞
HTTP/2 用多路复用解决了 HTTP/1.1 在应用层排队等待的问题,但它并没有消除 TCP 的有序交付约束。本节会把两种队头阻塞拆开看,并说明为什么一条 TCP 连接上的丢包仍可能让多个 HTTP/2 流同时停住。
学习目标
- 区分 HTTP/1.1 请求队头阻塞与 HTTP/2 的 TCP 层队头阻塞
- 理解多路复用为什么能提升并发效率,又为什么不能绕过 TCP 有序交付
- 能根据现象判断瓶颈更接近应用层排队还是传输层丢包
两种队头阻塞发生在不同层
HTTP/1.1 的典型问题发生在请求与响应的组织方式上。一个连接里如果前面的请求或响应长时间没有完成,后面的工作容易被它挡住;即使使用流水线,也必须按顺序返回响应,因此实际部署中很少依赖流水线提升并发。
HTTP/2 把一个连接拆成多个独立的流,再把每个流的数据切成帧交错传输。某个流的响应很慢时,其他流的帧仍可以继续发送,所以“慢请求占住整条 HTTP 请求队列”的问题被显著缓解。
多路复用消除了什么
多路复用解决的是 HTTP 层的排队问题。浏览器不必为了并发请求建立大量 TCP 连接,也不必等一个响应完整结束后才处理下一个流。只要连接仍能传输字节,多个流就可以交错推进。
这也是 HTTP/2 相比 HTTP/1.1 的关键收益边界:它改善了同一连接里请求之间的调度与利用率,但底层仍是一条 TCP 字节流,HTTP/2 无法直接改变 TCP 的可靠、有序交付语义。
TCP 丢包为什么会挡住多个流
TCP 会按照字节序列把数据交给上层。如果较早的 TCP 段丢失,即使后续段已经到达,接收端也要等缺失数据恢复后,才能继续向应用层交付连续的字节序列。于是,后续字节中原本属于不同 HTTP/2 流的帧都会一起等待。
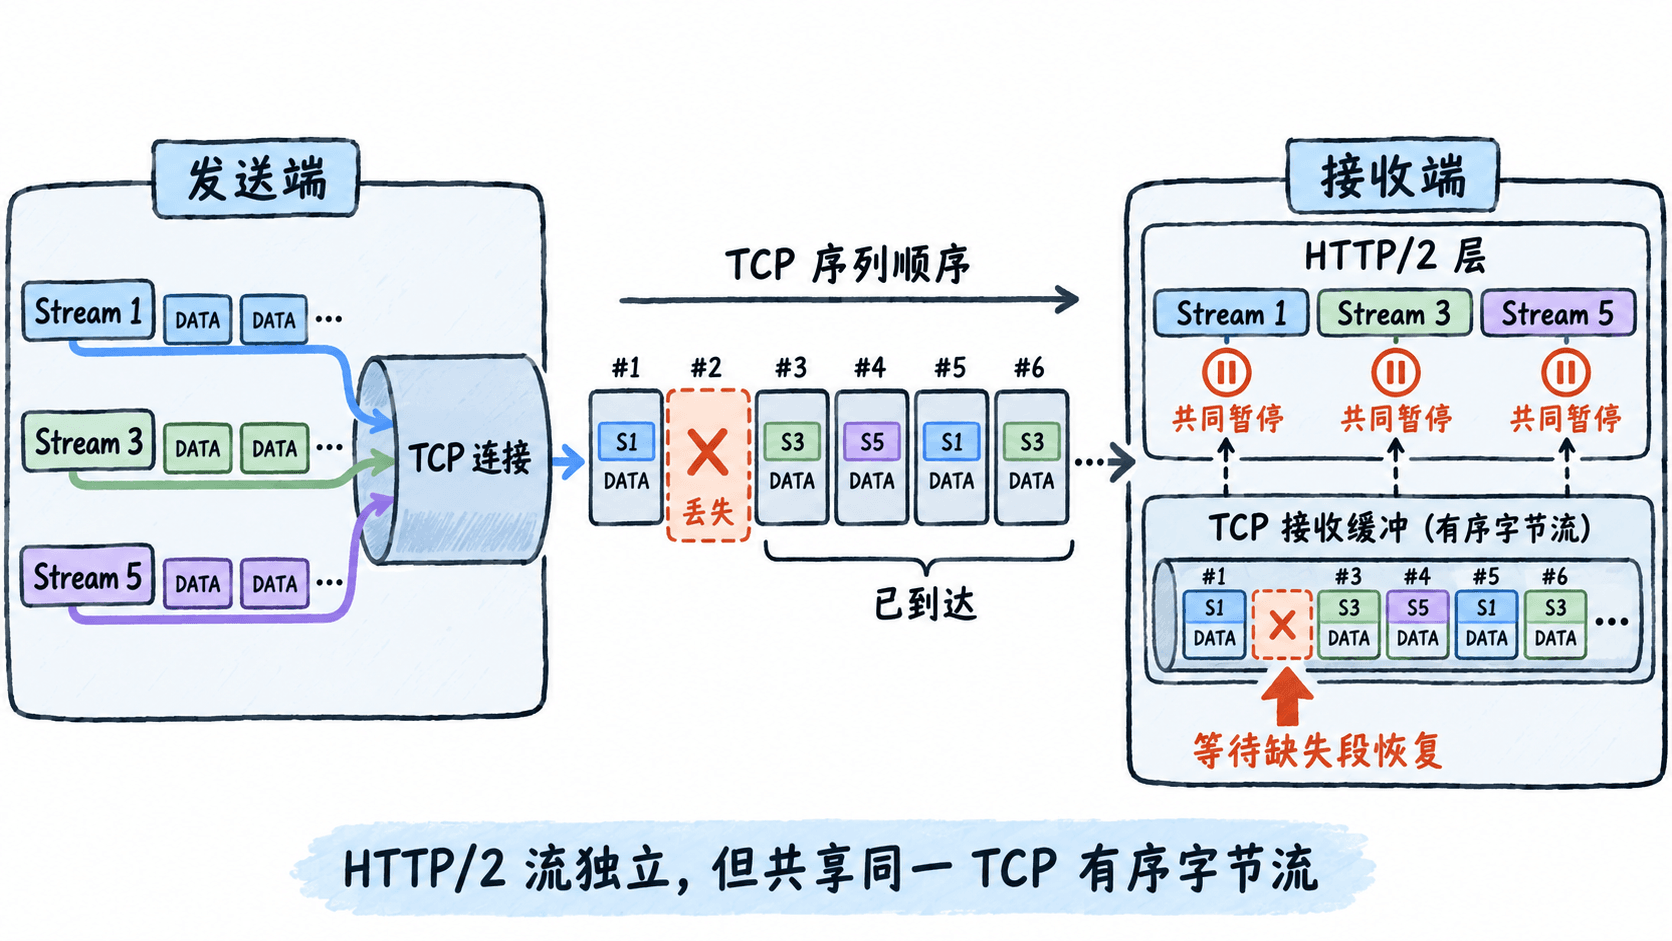
这里的“队头”已经不是某个 HTTP 请求,而是 TCP 字节序列中缺失的那一段。丢包恢复完成后,HTTP/2 层才能继续获得连续数据并解析各个流,因此共享同一 TCP 连接的活跃流会一起受到影响。
多路复用的收益边界
在低丢包、网络稳定的环境里,一条连接承载更多并发流通常能减少连接建立开销,并让链路利用更充分。但当 RTT 较高或存在持续丢包时,单条 TCP 连接上的丢包可能同时影响很多活跃流,尾延迟因此被放大。
增加 TCP 连接数可以把请求分散到不同的拥塞控制和重传上下文中,降低一次丢包影响全部请求的范围,但也会重新带来更多握手、拥塞窗口和连接管理成本。它不是默认优化手段,而是分析复杂网络性能时需要理解的一项权衡。
怎样判断遇到的是哪一种阻塞
| 观察现象 | 更可能的原因 | 重点检查 |
|---|---|---|
| 一个慢响应后,其他请求也按顺序等待 | HTTP/1.1 请求层排队 | 是否复用同一连接、是否存在串行响应 |
| HTTP/2 中多个流可交错推进 | 多路复用正常生效 | 流并发与服务端处理能力 |
| 多个 HTTP/2 流同时短暂停顿,随后一起恢复 | TCP 丢包或重传 | RTT、丢包率、重传与拥塞 |
| 提高单连接流并发后尾延迟明显恶化 | 共享连接上的传输或服务端瓶颈 | TCP 重传、流控窗口、服务端排队 |
判断 HTTP/2 性能问题时,先确认阻塞发生在哪一层。多路复用解决的是 HTTP 层请求之间的相互等待,而 TCP 层的丢包恢复仍可能同时影响一条连接上的所有活跃流,这也是理解 HTTP/2 性能边界以及后续 HTTP/3 设计动机的关键。