
架构与系统设计 / 系统课时
生产故障排查
生产故障排查
本课建立一套适用于支付生产环境的排查方法,覆盖重复订单、状态不一致、消息积压、连接异常和通道超时。完成学习后,你能够先控制影响范围,再沿订单号与追踪标识收集证据,定位根因并验证修复结果。
学习目标
- 掌握生产故障从止损、取证到修复验证的标准顺序
- 能够识别五类典型支付故障的关键证据与常见根因
- 能够使用日志和网络检查命令完成一次基础现场排查
按固定顺序处理生产故障
生产故障不能从修改代码开始。正确顺序是先确认影响范围并止损,再保存日志、指标和消息现场,随后缩小问题边界,最后实施修复并观察恢复情况。跳过取证直接重启服务,往往会清除连接、线程和消费状态,使根因更难确认。
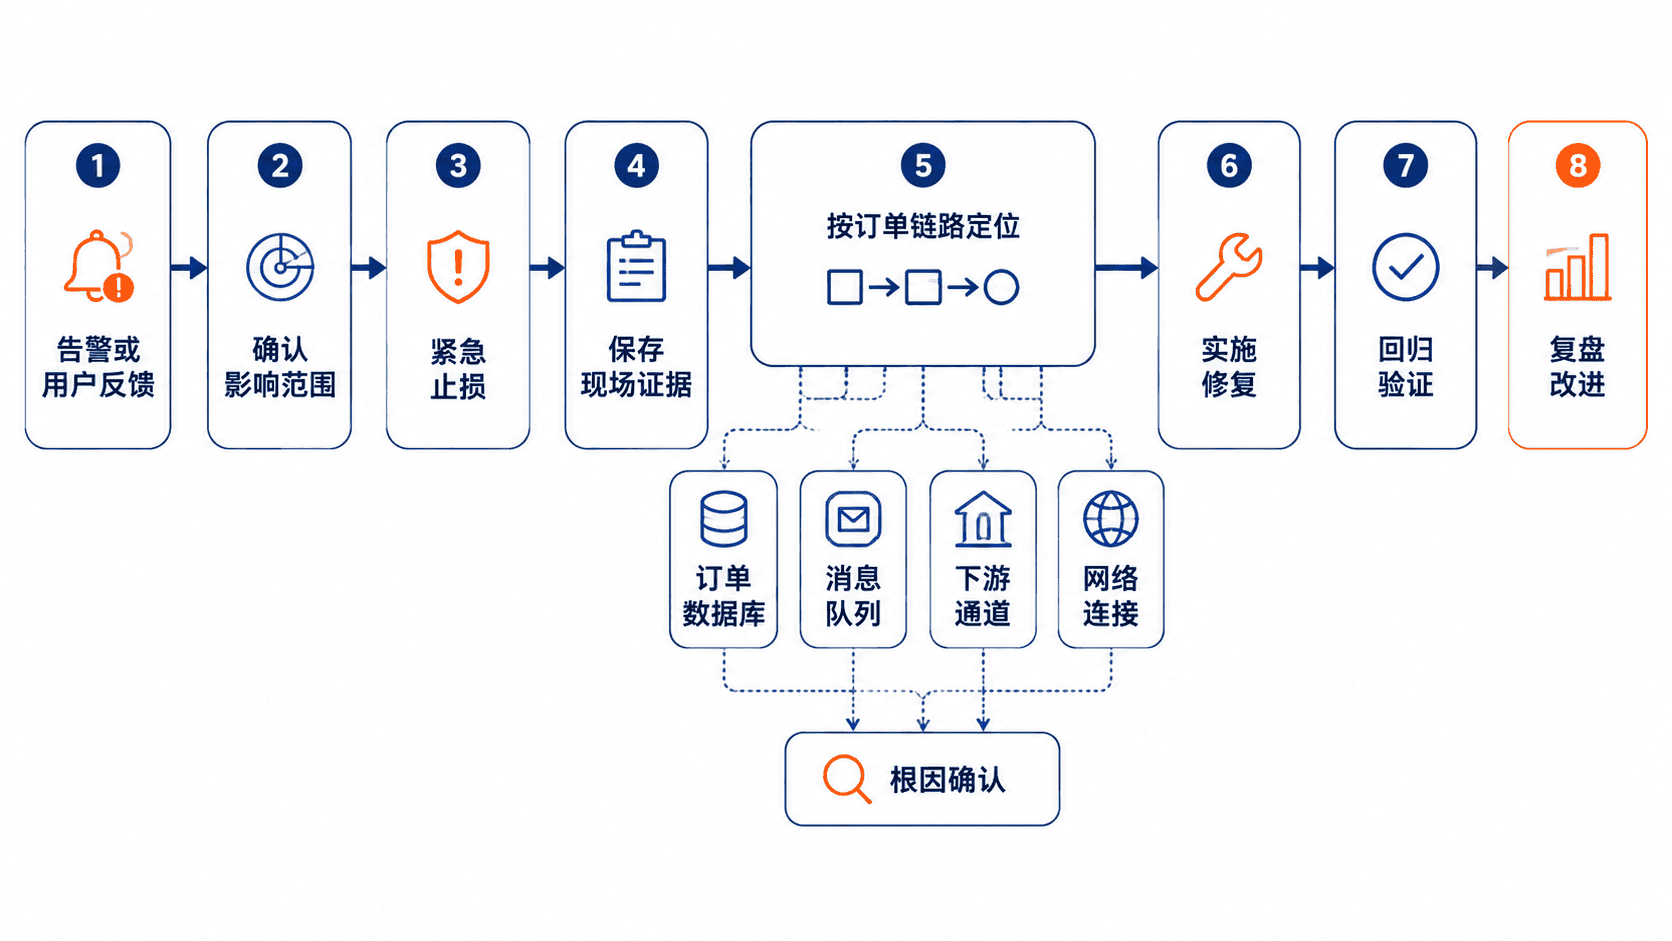
止损动作必须与故障类型匹配。重复扣款风险应暂停有问题的重试入口;消息积压应限制上游流量并隔离异常消息;通道超时则应将订单保持为处理中,而不是直接判定失败。止损期间不要批量修改订单状态,也不要删除队列中的未知消息。
五类典型故障的定位重点
| 故障现象 | 优先检查的证据 | 常见根因 | 修复方向 |
|---|---|---|---|
| 重复订单或重复扣款 | 商户订单号、请求标识、数据库唯一约束、重试日志 | 幂等键未落库、锁提前失效、超时后重复创建订单 | 使用数据库唯一约束兜底,相同幂等键返回原订单结果 |
| 平台与通道状态不一致 | 状态变更时间、回调日志、主动查询记录、对账结果 | 回调乱序、状态被覆盖、事务未提交、补偿任务缺失 | 限制状态只能单向推进,对回调和补偿任务执行幂等更新 |
| 消息队列持续积压 | 待消费数、消费速率、未确认消息、死信数量 | 下游变慢、异常消息反复重试、消费者不足 | 隔离毒消息,扩容消费者,并为重试设置次数与退避时间 |
| 数据库或缓存连接异常 | 连接池活跃数、等待数、连接重置日志、服务端超时配置 | 空闲连接被服务端关闭、连接池生命周期过长、网络抖动 | 让连接最大生命周期短于服务端超时,并配置连接检测与有限重试 |
| 支付通道调用超时 | 连接耗时、读取耗时、通道响应日志、订单查询结果 | 通道处理缓慢、DNS 或网络异常、超时层级不合理 | 区分连接与读取超时,将未知结果置为处理中并异步查询收敛 |
重复订单与状态不一致
重复订单应先判断是同一请求被重复接收,还是平台生成了不同订单号。前者重点检查幂等键是否稳定,后者重点检查订单号生成、事务边界和数据库唯一约束。已经发生重复扣款时,应先冻结自动退款或补偿脚本,确认主订单后再处理重复交易。
状态不一致不能通过直接更新数据库解决。应按“创建订单、请求通道、接收响应、处理回调、主动查询、对账补偿”的时间顺序还原事件,找出第一次出现分歧的位置。终态订单通常不得被更早的回调重新改为处理中。
消息积压、连接异常与通道超时
消息积压要同时比较生产速率与消费速率。单纯增加消费者只能解决容量不足,无法解决毒消息、数据库慢查询或通道限流。若某条消息持续失败,应转入隔离队列并记录失败原因,避免它占满重试线程。
连接异常应区分“无法建立连接”和“已建立连接被重置”。前者多与地址、端口、DNS或网络策略有关;后者常见于空闲连接失效、服务端主动关闭或连接池参数不匹配。只有具备幂等保证的查询和写入操作,才适合自动重试。
通道超时表示平台尚未获得确定结果,不等于支付失败。平台应保留通道请求号,将订单置为处理中,通过主动查询、异步回调或对账任务最终收敛,避免用户重复支付后产生多笔成功交易。
使用日志和网络检查保存现场
下面的脚本适用于使用 systemd 部署的 Linux 服务。执行前需要设置订单号、追踪标识、通道主机和服务名称;<ORDER_NO>、<TRACE_ID> 等值应替换为故障现场的实际信息。
#!/usr/bin/env bash
set -euo pipefail

SERVICE="${SERVICE:-payhub-trade.service}"
ORDER_NO="${ORDER_NO:?请设置 ORDER_NO}"
TRACE_ID="${TRACE_ID:?请设置 TRACE_ID}"
CHANNEL_HOST="${CHANNEL_HOST:?请设置 CHANNEL_HOST}"
CHANNEL_PORT="${CHANNEL_PORT:-443}"

echo "== matching service logs =="
if journalctl -u "$SERVICE" --since "30 minutes ago" --no-pager \
  | grep -E "$ORDER_NO|$TRACE_ID|timeout|Connection reset|ERROR" \
  | tail -n 80; then
  echo "matching logs found"
else
  echo "no matching logs found"
fi

echo "== channel tcp check =="
if timeout 5 bash -c "</dev/tcp/$CHANNEL_HOST/$CHANNEL_PORT"; then
  echo "channel tcp reachable"
else
  echo "channel tcp unreachable"
fi
预期输出以日志命中且通道端口可连接为例;真实日志时间、主机名和内容会随现场不同而变化。
== matching service logs ==
<TIME> <HOST> <SERVICE_LOG_LINE>
matching logs found
== channel tcp check ==
channel tcp reachable
日志未命中时,应扩大查询时间范围,并确认订单号是否经过脱敏或转换。TCP 可连接只说明目标端口可达,不能证明 TLS 握手、证书校验、HTTP 请求和通道业务处理均正常,还需要结合应用日志中的分阶段耗时继续判断。
修复后完成闭环验证
修复完成后,应先用单笔测试订单验证创建、通道调用、回调、消息消费和状态更新,再逐步恢复流量。验证期间重点观察错误率、超时率、队列深度、连接池等待数和订单终态比例,不能只确认接口返回成功。
历史异常数据应通过可审计的补偿任务处理。补偿程序需要记录原状态、目标状态、处理依据和执行结果,并支持按订单号重复执行而不产生二次影响。确认系统稳定后,再补充告警阈值、唯一约束、超时策略或容量预案,避免同类故障再次发生。