
架构与系统设计 / 系统课时
监控与告警
监控与告警
支付平台的监控不能只看 CPU 和接口耗时,还要回答“订单是否成功、资金是否一致、故障影响了谁”。本课将把业务指标、应用指标、日志、链路追踪和分级告警连接成一套可落地的观测体系。
学习目标
- 能按业务、应用和基础设施三个层次设计监控指标
- 能通过统一字段串联指标、日志与调用链
- 能制定有优先级、可执行且不过度打扰的告警规则
从业务结果倒推监控
监控设计应从用户和资金结果开始,而不是从机器资源开始。支付链路至少要回答四个问题:请求有没有进入、订单有没有完成、渠道有没有异常、账务有没有保持一致。
| 层次 | 关键指标 | 典型问题 |
|---|---|---|
| 业务 | 支付成功率、退款成功率、订单收敛率、对账差错数 | 用户是否能完成支付,资金结果是否正确 |
| 应用 | 请求量、错误率、P95/P99 延迟、线程池与连接池使用率 | 哪个服务正在退化 |
| 基础设施 | CPU、内存、磁盘、网络、数据库与消息队列状态 | 运行环境是否成为瓶颈 |
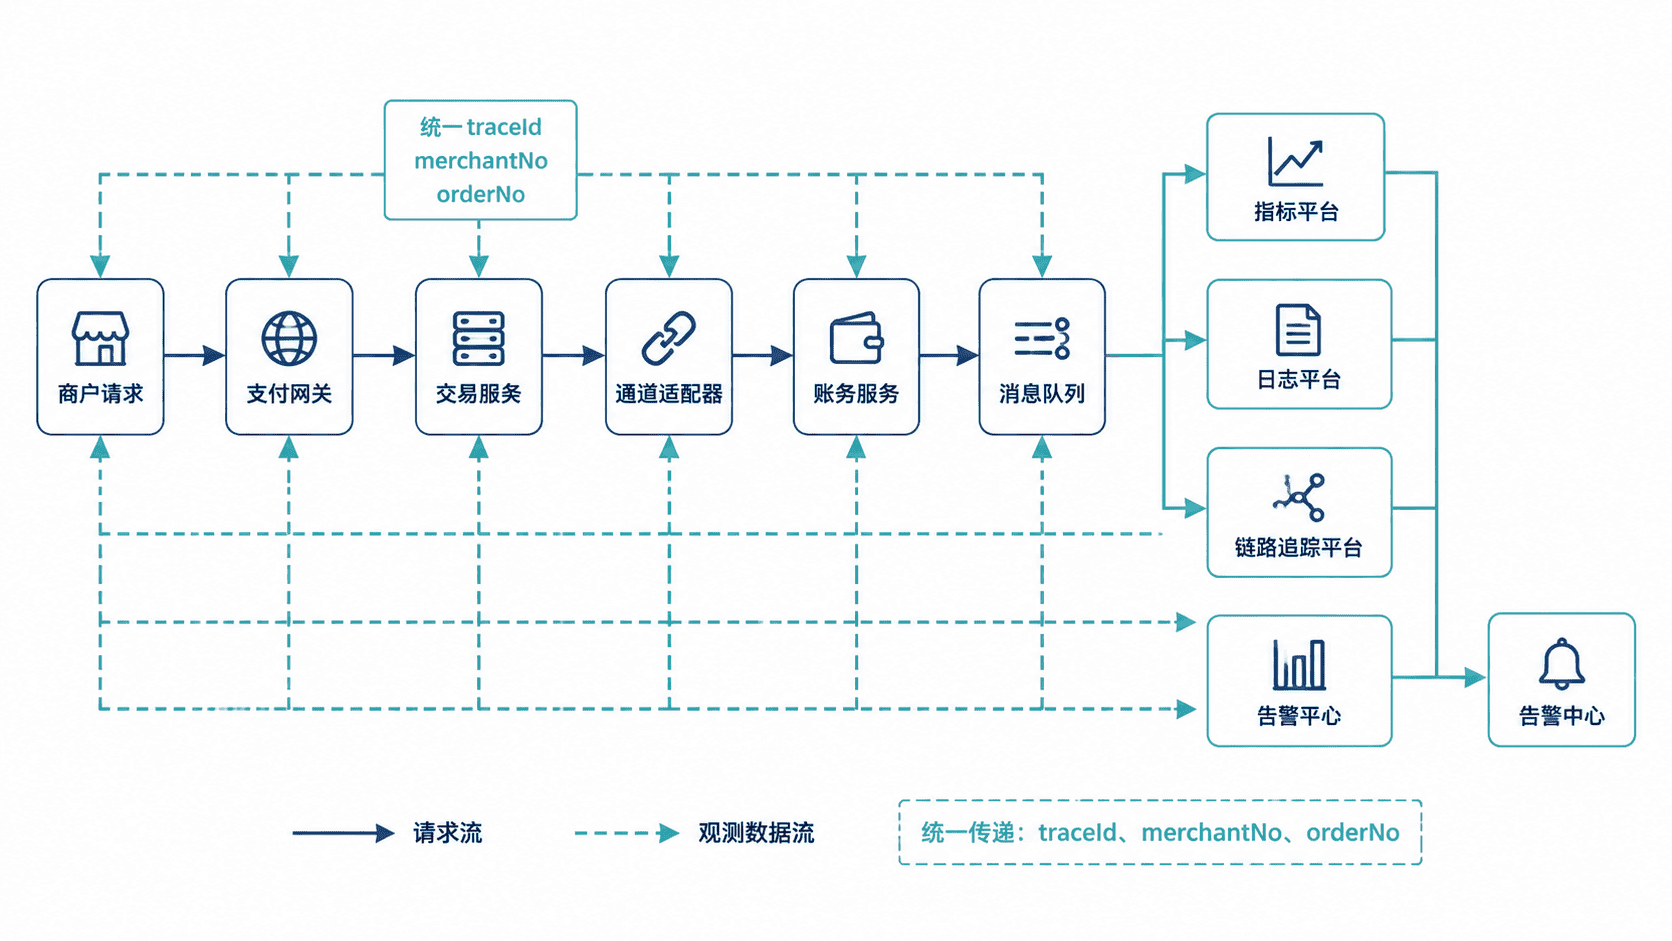
业务指标必须按合理维度拆分,例如支付成功率既看全局,也看通道、支付方式、地区和商户。维度过少会掩盖局部故障,维度过多则会造成高基数和存储膨胀,因此订单号、请求号等唯一值不应作为指标标签。
指标埋点与验证
Spring Boot 项目可使用 Micrometer 记录业务计数器和耗时。下面是片段示例,依赖 spring-boot-starter-actuator 与 Prometheus Registry,由交易服务在收到最终支付结果时调用。
package com.example.payment.monitoring;

import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.Timer;

import java.time.Duration;

public final class PaymentMetrics {

    private final MeterRegistry registry;

    public PaymentMetrics(MeterRegistry registry) {
        this.registry = registry;
    }

    public void recordResult(String channel, String payMethod, boolean success, Duration latency) {
        String result = success ? "success" : "failure";

        Counter.builder("payment_result_total")
                .tag("channel", channel)
                .tag("pay_method", payMethod)
                .tag("result", result)
                .register(registry)
                .increment();

        Timer.builder("payment_latency")
                .tag("channel", channel)
                .tag("pay_method", payMethod)
                .register(registry)
                .record(latency);
    }
}
应用暴露 /actuator/prometheus 后,可使用以下命令验证。实际端口可能不同,应将 <PORT> 替换为服务端口。
curl -s http://127.0.0.1:<PORT>/actuator/prometheus | grep payment_result_total预期输出
payment_result_total{channel="channel-a",pay_method="CARD",result="success"} 1.0计数器用于累计结果,Timer 用于统计延迟分布。告警通常不要直接盯单次失败,而应基于时间窗口计算失败率,并同时设置最小请求量,避免低流量时被少量失败放大。
日志与链路追踪
日志应采用结构化输出,并在网关生成或透传 traceId。支付链路建议统一记录 traceId、requestId、merchantNo、orderNo、channelOrderNo、service、result 和 costMs,同时对卡号、证件号、密钥和完整手机号脱敏。
排查时先从业务异常找到订单号,再检索日志定位失败服务,最后打开调用链查看耗时和错误节点。指标负责发现问题,日志负责解释上下文,Trace 负责还原跨服务路径,三者不能互相替代。
Tips:不要把完整请求体无条件写入日志。支付报文可能包含敏感数据,应通过字段白名单、脱敏和采样控制风险。
分级告警与降噪
告警必须包含严重级别、触发条件、持续时间、影响范围、处理人和排查入口。没有明确动作的告警只是噪声。
| 级别 | 示例 | 通知与处理 |
|---|---|---|
| P0 | 全局支付成功率持续 5 分钟低于 60% | 电话加即时消息,立即响应并启动应急流程 |
| P1 | 单一主通道错误率持续 10 分钟高于 20% | 即时消息通知值班人员,评估切换通道 |
| P2 | 非核心接口 P95 延迟持续升高 | 工单或群消息,工作时段处理 |
规则应同时配置持续时间、恢复通知、告警抑制和聚合。例如数据库故障已触发 P0 时,可抑制由它引发的多个下游超时告警;同一通道、同一故障类型应聚合成一条事件,避免值班人员被重复通知淹没。
验收清单
上线前至少完成一次故障演练:人为制造通道超时或依赖不可用,确认业务指标下降、日志能按订单号检索、Trace 能看到失败节点、告警能到达正确人员,并在恢复后自动发送恢复通知。
还应检查仪表盘是否覆盖正常基线、峰值和异常区间。只有知道“正常是什么样”,异常曲线才有判断价值。