
架构与系统设计 / 系统课时
消息积压治理
消息积压治理
消息积压不是简单地“多开几个消费者”。本课将从队列指标、消费者状态和下游依赖入手,建立固定的定位顺序,并给出重复消费、死信、消费延迟和积压恢复的处理方法,避免扩容后把数据库或第三方接口进一步压垮。
学习目标
- 根据关键指标判断积压发生位置
- 区分重复消费、死信和消费延迟的根因
- 制定安全的扩容、回放与恢复方案
先判断消息卡在哪一段
排查时先画出完整链路:生产者发送、交换机路由、队列等待、消费者领取、业务处理、确认消息。积压只表示某一段的输入速度长期大于输出速度,必须结合 ready、unacked、消费者数量和确认速率判断位置。
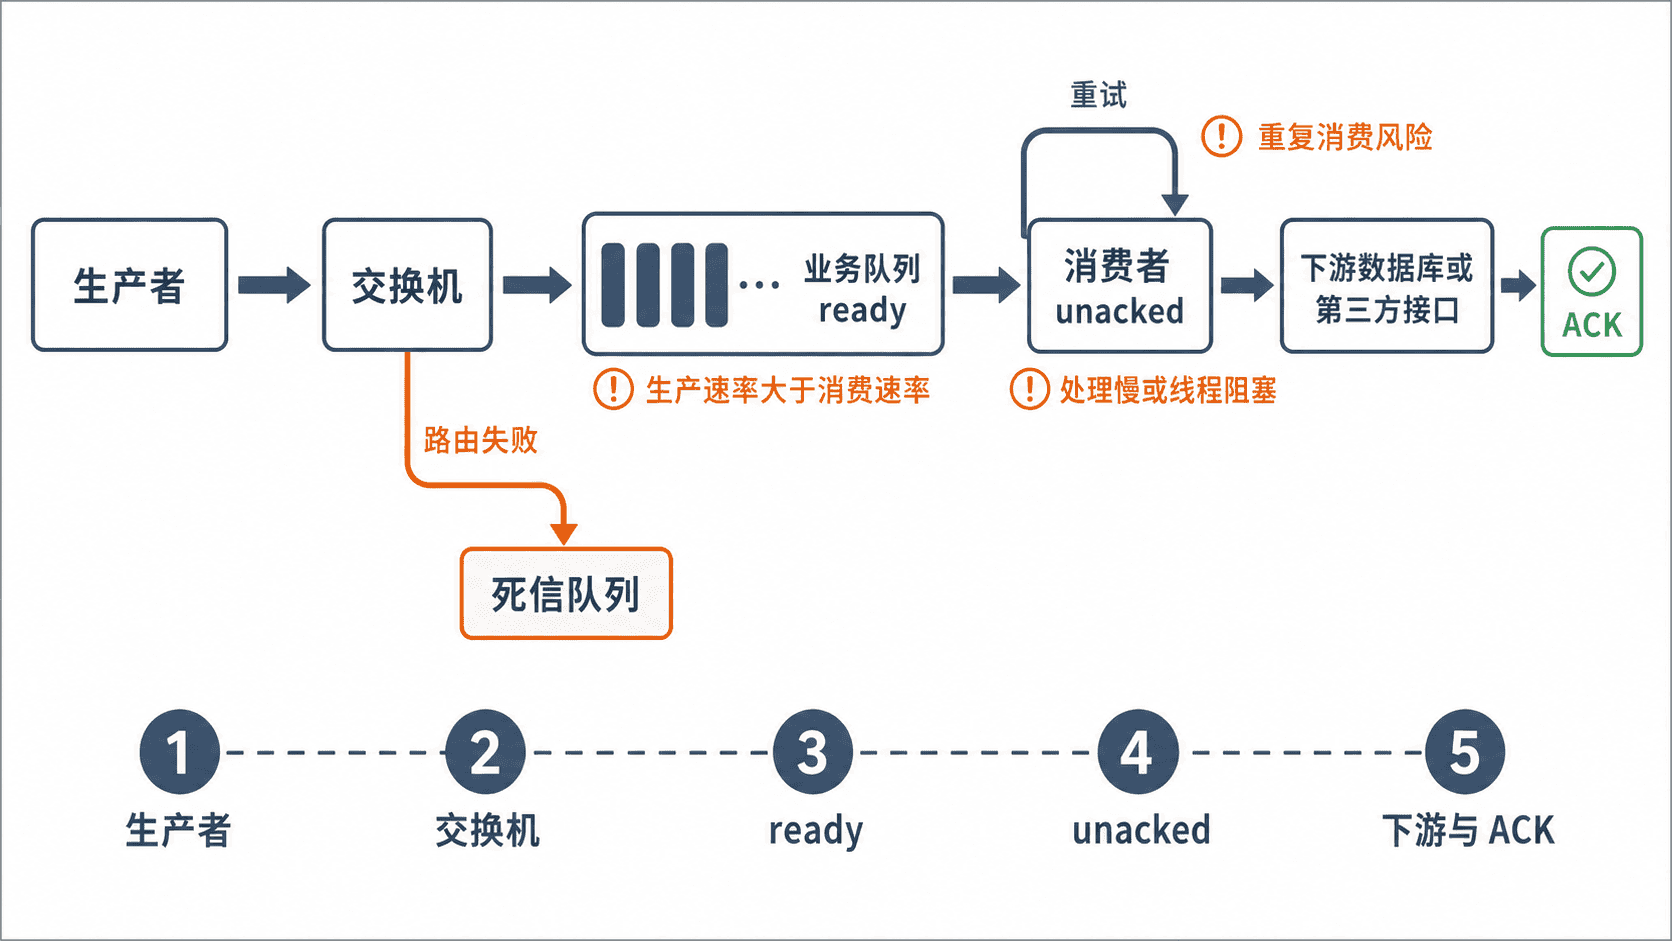
RabbitMQ 可先执行以下命令查看队列状态。命令中的数值会随环境变化,重点是比较各指标的趋势。
sudo rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers arguments预期输出结构:
name                 messages_ready  messages_unacknowledged  consumers  arguments
pay.notify           <READY>         <UNACKED>                <COUNT>    <ARGUMENTS>
pay.notify.dlq       <DLQ_READY>      0                        0          <DLQ_ARGUMENTS>
messages_ready 持续增长,说明消息尚未被领取;messages_unacknowledged 很高,说明消费者已领取但迟迟没有确认;消费者为 0,则先检查实例、连接、权限和监听配置,而不是立即扩容。
按指标组合缩小根因
| 现象 | 更可能的原因 | 优先动作 |
|---|---|---|
ready 上升、unacked 低 |
消费能力不足或消费者离线 | 检查实例数量、消费速率和路由 |
unacked 长时间很高 |
业务处理慢、线程阻塞、预取过大 | 查看线程栈、下游耗时和超时 |
| 队列不积压但业务延迟高 | 消息在重试、延迟队列或下游等待 | 对比生产时间、领取时间和完成时间 |
| 死信持续增长 | 消费拒绝、过期、队列超长或路由配置错误 | 按死信原因分类,不要直接全量回放 |
定位顺序应保持稳定:先确认生产速率,再看消费者是否在线,然后看单条处理耗时,最后检查下游数据库、缓存和第三方接口。只有确认瓶颈在消费者本身,增加并发才有意义。
用幂等约束处理重复消费
消息系统通常保证“至少一次”投递,消费者必须允许同一消息再次到达。推荐使用稳定的 message_id 建唯一约束,在同一数据库事务中写入消费记录和业务结果。
下面的 SQL 演示同一消息写入两次时只保留一条消费记录。
CREATE TABLE message_consume_record (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    message_id VARCHAR(64) NOT NULL,
    consumer_name VARCHAR(64) NOT NULL,
    consumed_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
    UNIQUE KEY uk_message_consumer (message_id, consumer_name)
);

INSERT IGNORE INTO message_consume_record (message_id, consumer_name)
VALUES ('MSG-20260803-001', 'payment-notify-consumer');

INSERT IGNORE INTO message_consume_record (message_id, consumer_name)
VALUES ('MSG-20260803-001', 'payment-notify-consumer');

SELECT message_id, consumer_name
FROM message_consume_record
WHERE message_id = 'MSG-20260803-001';
预期结果:
message_id          consumer_name
MSG-20260803-001    payment-notify-consumer
仅有去重表还不够。业务更新必须与消费记录处于同一事务,否则可能出现“记录已存在但业务未完成”的假成功。对于跨库或外部接口场景,应再配合业务状态机、幂等请求号或本地消息表。
分类处理死信和消费延迟
死信需要先按原因分组。格式错误、缺少必要字段等永久性错误应隔离并人工修复;数据库超时、第三方限流等暂时性错误可进入带上限的延迟重试;代码缺陷导致的批量失败应先停止消费,修复后再回放。
消费延迟应记录至少四个时间点:消息创建、进入队列、消费者领取、业务完成。这样才能区分排队时间和处理时间。只看队列长度会漏掉“队列很短但单条处理数分钟”的情况。
安全恢复积压
恢复时先限制风险,再提升吞吐。确认下游容量后逐步增加消费者,控制每个消费者的预取数量,并观察数据库连接池、CPU、接口限流和失败率。必要时临时降低非核心生产流量,避免恢复速度仍小于新增速度。
死信回放应按小批次执行,保留原 message_id,写入回放批次和操作者。每批回放后检查成功率、重复率和下游负载;若错误率上升,立即暂停,而不是一次性把全部死信重新投入主队列。
验证治理结果
治理完成后,ready 应持续下降并最终稳定,unacked 不应长期贴近预取上限,死信增长率应回到零或可解释范围。端到端延迟要恢复到服务目标,同时确认没有因为扩容引入数据库锁等待、接口限流或重复业务结果。
Tips:积压清零只是恢复完成的一个信号。真正的验收标准是生产速率、消费速率、错误率和端到端延迟重新进入稳定区间。