
游戏 AI / 系统课时
大量 NPC 同时变卡怎么查
大量 NPC 同时变卡怎么查
单个敌人运行正常,不代表几十个 NPC 同时激活后仍然流畅。真正需要定位的是:每帧究竟把时间花在行为树 Tick、Service、感知、路径计算还是日志上。本节建立一条可重复的性能排查链路,最终把“NPC 多了就卡”缩小到具体阶段。
学习目标
- 能把 NPC AI 的每帧成本拆成可测量的几个阶段
- 能通过数量、频率和单次耗时判断真正的性能热点
- 能用采样数据验证优化是否有效,而不是凭感觉修改行为树
先确认卡顿是否真的来自 AI
大量 NPC 出现时,第一步不是立即删节点,而是确认主线程时间是否随着 AI 数量增长。把测试场景固定下来,例如分别生成 10、50、100 个敌人,并保持摄像机、地图和战斗状态尽量一致。
重点观察两组数据:一组是整帧耗时与帧率,另一组是 AI 相关阶段耗时。如果 NPC 数量增加后帧时间明显增长,而 AI 阶段同步上涨,才继续向行为树内部拆解。如果渲染、动画或物理才是主要增量,就不要在行为树上浪费时间。
把一帧 AI 成本拆开
行为树集群通常不是“树本身太慢”,而是树触发了昂贵工作。可以把一次 AI 更新拆成五类成本:Behavior Tree Tick 负责节点遍历与条件判断;Service 做周期更新;Perception 查询视野、距离或碰撞;Pathfinding 请求导航路径;Logging 输出调试信息。
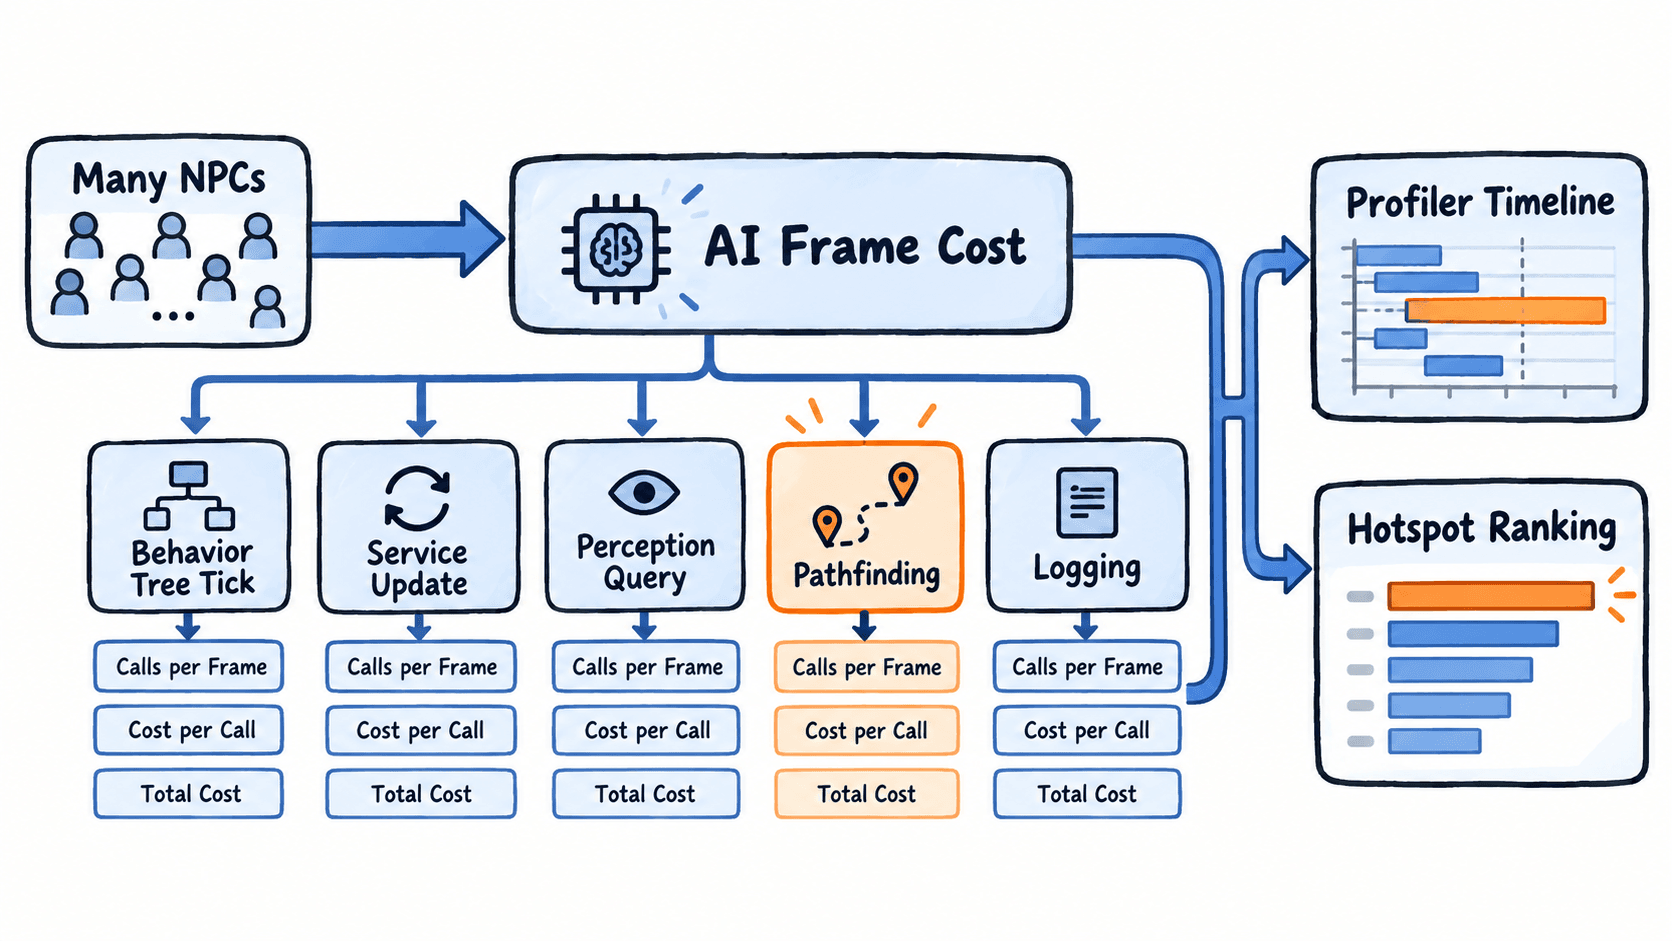
最值得关注的不是某一次调用是否慢,而是总成本。一个只需要 0.05 ms 的查询,如果每帧被 100 个 NPC 各执行 4 次,就会形成约 20 ms 的理论调用成本。相反,一个 1 ms 的路径计算若每秒只触发几次,未必是首要问题。
可以用下面的关系判断优先级:总成本 = 调用次数 × 单次成本。因此排查时同时记录次数和耗时,不能只盯着最慢的一次调用。
用采样数据找出热点
实际项目应优先使用引擎自带 Profiler、Trace 或采样工具。如果还需要快速分析导出的阶段耗时,可以用一个简单脚本按阶段累计时间。下面示例模拟一帧采样数据,并计算每个阶段占 AI 总耗时的比例。
from collections import defaultdict

samples = [
    ("BehaviorTreeTick", 1.8),
    ("ServiceUpdate", 2.4),
    ("PerceptionQuery", 6.7),
    ("Pathfinding", 4.1),
    ("Logging", 0.9),
    ("PerceptionQuery", 2.1),
]

totals = defaultdict(float)
for stage, milliseconds in samples:
    totals[stage] += milliseconds

grand_total = sum(totals.values())
for stage, milliseconds in sorted(totals.items(), key=lambda item: item[1], reverse=True):
    ratio = milliseconds / grand_total * 100
    print(f"{stage:20s} {milliseconds:4.1f} ms  {ratio:5.1f}%")
预期输出:
PerceptionQuery       8.8 ms   48.9%
Pathfinding           4.1 ms   22.8%
ServiceUpdate         2.4 ms   13.3%
BehaviorTreeTick      1.8 ms   10.0%
Logging               0.9 ms    5.0%
这个结果说明继续微调普通节点遍历意义有限,因为感知查询已经占到接近一半的 AI 时间。真实项目中应把示例里的数据替换为 Profiler 或埋点采样结果,并至少比较多个连续帧,避免被单帧尖峰误导。
按热点类型处理
如果 Behavior Tree Tick 本身占用最高,先检查是否所有 NPC 都在每帧完整 Tick,以及高优先级分支是否重复执行昂贵条件。远离玩家、不可见或处于低活跃状态的 NPC,通常可以降低更新频率,而不是让整棵树持续满速运行。
如果 Service 成本高,重点检查执行周期。把“不需要每帧更新”的目标扫描、距离刷新和环境查询分散到不同频率,通常比删除 Service 更合理。还要避免多个节点各自计算同一份数据,应由明确的数据生产者更新共享结果。
感知查询高时,要检查射线、范围检测、候选目标过滤以及查询频率。先用廉价条件缩小候选集,再执行昂贵的遮挡检测,通常比对所有 NPC 两两查询有效得多。
路径计算高时,关注重新寻路频率,而不是只看一次寻路耗时。目标位置轻微变化就立即重新请求路径,会在大量 NPC 场景中形成请求风暴。可以增加距离阈值、时间间隔或路径失效条件,让重新规划只在确实需要时发生。
日志成本高时尤其容易被忽略。每个节点每帧打印状态,在几十个 NPC 下会产生大量字符串格式化和 I/O。性能测试阶段应关闭高频详细日志,只保留异常事件、聚合计数或可按 NPC 开启的诊断信息。
用数量曲线验证修复
优化完成后仍然使用相同场景重复 10、50、100 个 NPC 的测试,并比较 AI 总耗时与各阶段占比。有效优化不仅应该让某个函数看起来更快,还应让整体帧时间下降,并降低 NPC 数量增长时的成本斜率。
大量 NPC 变卡时,最短路径始终是先确认 AI 是否为瓶颈,再按 Tick、Service、感知、寻路和日志拆分总成本,最后针对“调用次数 × 单次成本”最大的阶段处理。这样得到的优化结论才能随着 NPC 数量扩大继续成立。