
游戏 AI / 系统课时
检测频率过高会带来什么
检测频率过高会带来什么
Service 如果每帧都做视线检测、距离计算或空间查询,单个 NPC 看起来可能没问题,但数量一多就会把重复查询放大成明显的 CPU 开销。本节用可计算的方式估算成本,并据此选择足够及时、又不过度频繁的更新周期。
学习目标
- 用 NPC 数量、检测频率和单次查询成本估算总体负载
- 判断哪些感知数据需要高频刷新,哪些可以降频
- 为 Service 选择可验证的更新周期,而不是凭感觉设置
先把每秒查询次数算出来
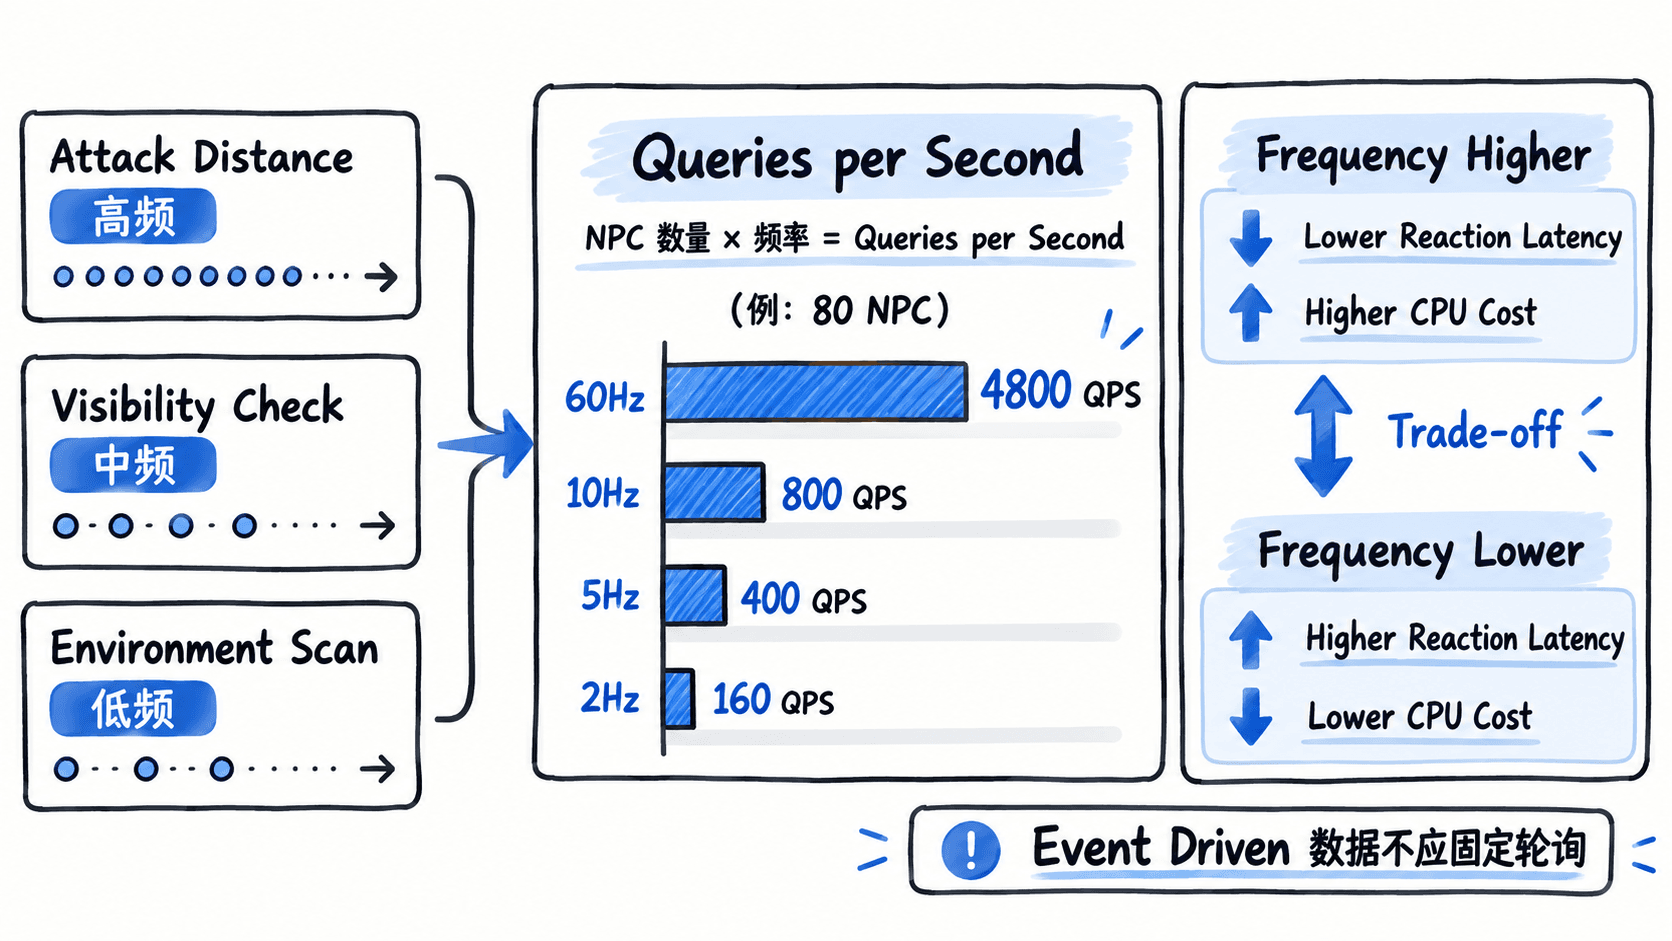
假设有 N 个 NPC,每个 Service 每秒执行 F 次检测,那么每秒总查询数就是 N × F。如果一次查询平均耗时 C 毫秒,则理论 CPU 时间约为 N × F × C 毫秒每秒。
例如 80 个 NPC 以 60 Hz 做一次 0.04 ms 的空间查询,一秒会产生 4800 次查询,理论上消耗约 192 ms CPU 时间。这个数字不是“每帧 192 ms”,而是整整一秒累计的查询时间;换算到平均每帧约为 3.2 ms,已经足以挤压动画、导航和游戏逻辑预算。
下面的脚本可以快速比较不同频率。
def estimate_cost(npc_count: int, frequency_hz: float, cost_ms: float) -> tuple[float, float]:
    queries_per_second = npc_count * frequency_hz
    cpu_ms_per_second = queries_per_second * cost_ms
    return queries_per_second, cpu_ms_per_second

for hz in (60, 10, 5, 2):
    qps, cpu_ms = estimate_cost(80, hz, 0.04)
    print(f"{hz:>2} Hz -> {qps:>6.0f} queries/s, {cpu_ms:>6.1f} ms CPU/s")
预期输出:
60 Hz ->   4800 queries/s,  192.0 ms CPU/s
10 Hz ->    800 queries/s,   32.0 ms CPU/s
 5 Hz ->    400 queries/s,   16.0 ms CPU/s
 2 Hz ->    160 queries/s,    6.4 ms CPU/s
实际成本会受缓存命中、物理场景复杂度、线程调度和查询类型影响,所以这个计算用于做第一轮预算,最终仍要以性能分析器里的真实数据为准。
更新周期要按信息变化速度分层
不是所有黑板键都值得同频更新。攻击距离可能需要较快响应,而“附近是否存在兴趣点”往往可以更慢。
| 数据 | 常见更新需求 | 设计思路 |
|---|---|---|
| 近身攻击距离 | 较高 | 角色移动快,过慢会造成明显迟滞 |
| 目标可见性 | 中等 | 100~250 ms 一次通常已足够自然,具体由玩法验证 |
| 搜索点或环境信息 | 较低 | 0.5~2 秒一次通常更合适 |
| 只在事件发生时变化的数据 | 事件驱动 | 不应固定轮询 |
不要把这些数值当成通用标准。高速动作游戏、潜行游戏和大规模 RTS 的可接受延迟完全不同,正确周期应从“玩家能否感知到反应变慢”和“性能预算是否稳定”两个方向一起验证。
再用错峰避免同一帧尖峰
即使平均频率合理,如果 100 个 NPC 的 Service 都在同一帧触发,仍可能出现周期性尖峰。更稳妥的做法是给实例分散初始相位,或由统一调度器把检测任务摊到多个帧里。
例如 10 Hz 的 Service 并不意味着所有 NPC 必须每 100 ms 同时执行。只要单个 NPC 仍维持约 100 ms 的更新间隔,就可以把不同 NPC 的执行时刻均匀错开,从而降低单帧最坏耗时。
用场景压测决定最终周期
验证时应使用接近最坏情况的 NPC 数量,并同时记录 Service 自身耗时、每帧调用次数和行为响应延迟。先从保守的低频开始,例如 5~10 Hz,再逐步提高,直到行为反应足够自然;如果继续提高频率已经看不出体验差异,就没有必要继续增加查询次数。
合理的 Service 周期不是越快越好,而是“刚好快到玩家感觉不到迟钝”。先计算上限,再分层更新、错峰执行,最后用真实场景测量,才能把感知系统的实时性和 CPU 预算同时控制住。