
机器人 / 系统课时
观测模型如何评价位姿假设
观测模型如何评价位姿假设
机器人在地图上可能存在多个候选位姿,但不是每个位置都能解释当前传感器读数。观测模型通过预测传感器在候选位姿下应该看到什么,再比较真实观测与预测值,计算各位姿的观测似然。本篇用二维激光雷达和一面墙建立最小模型,并用 Python 验证评分结果。
学习目标
- 理解候选位姿、地图、预测观测和真实观测之间的关系。
- 使用观测残差与高斯噪声模型计算位姿的观测似然。
- 通过可运行示例比较位姿假设,并识别多束激光评分中的常见问题。
从地图和位姿预测传感器读数
二维激光 SLAM 中,机器人位姿通常表示为 ,其中 是地图坐标系下的位置, 是朝向。已知地图 和候选位姿 后,可以通过射线投射预测激光雷达的距离读数 。
预测值和真实读数有明确区别:
- 真实观测 :激光雷达实际返回的距离,保持不变。
- 预测观测 :假设机器人处于某个候选位姿,射线从该位置出发与地图中的障碍物相交,计算得到的距离。
- 观测残差 :真实观测减去预测观测,即 。
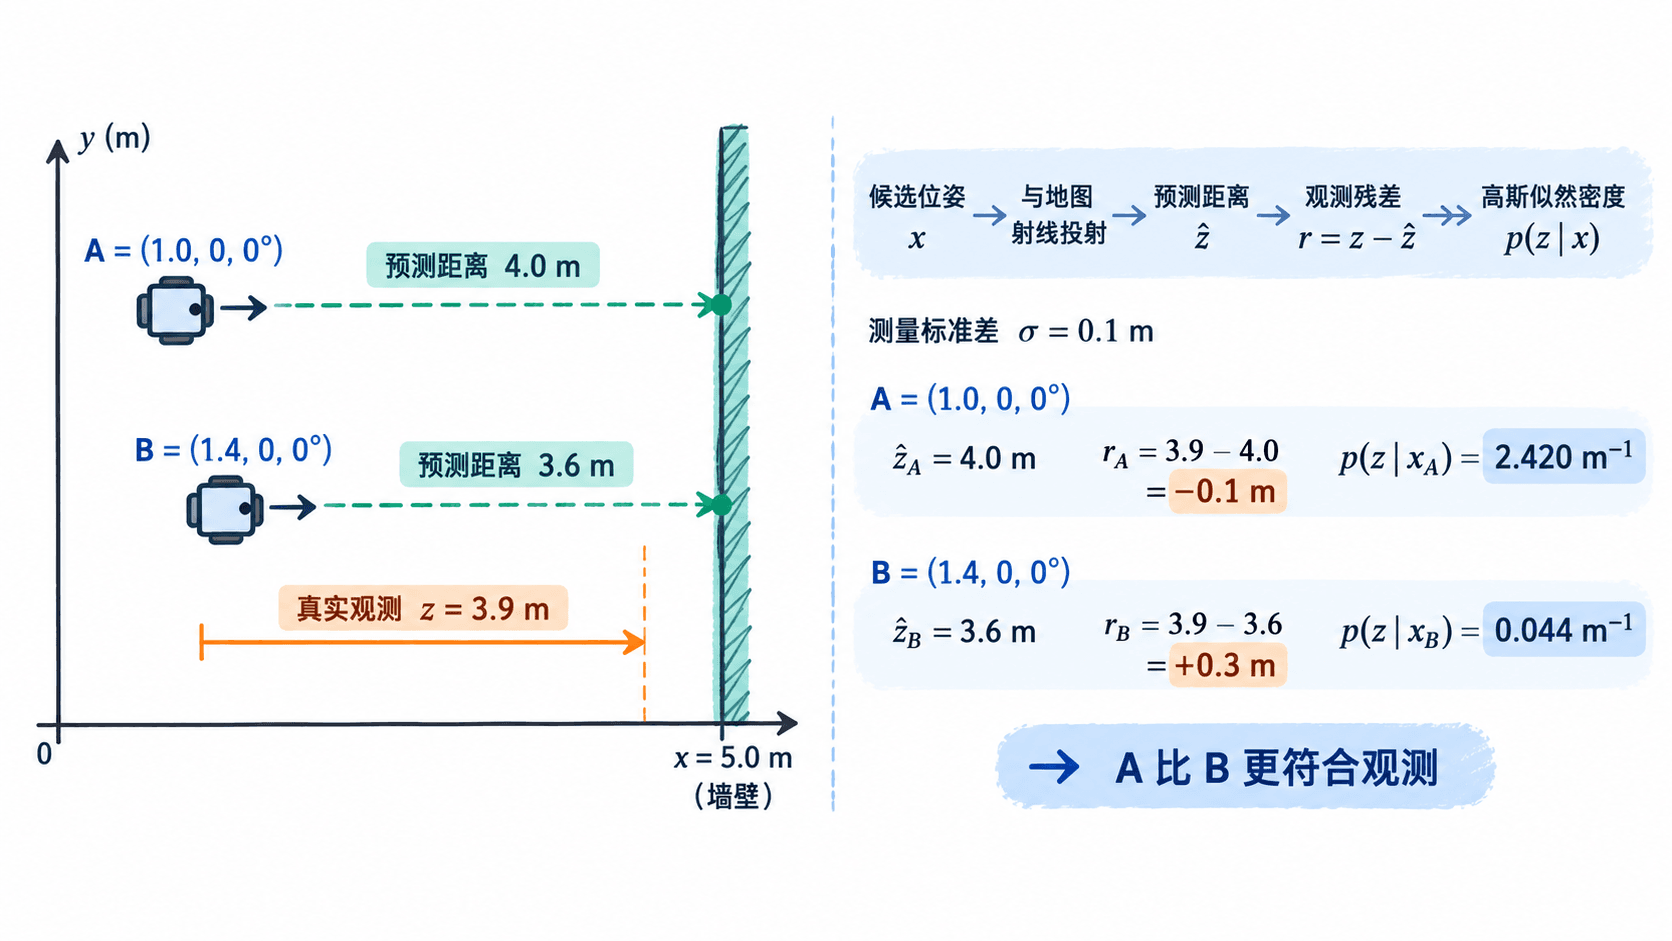
考虑一张只有一面垂直墙壁的简化地图,墙位于 m。激光雷达与机器人位姿原点重合,机器人面向 方向,只使用正前方的一束激光。真实观测距离为 m。
现在比较两个候选位姿:
| 候选位姿 | 位置与朝向 | 地图预测距离 | 观测残差 |
|---|---|---|---|
| A | 4.0 m | -0.1 m | |
| B | 3.6 m | +0.3 m |
候选 A 的预测值更接近真实读数,因此它更符合这一次观测。但要判断两者可信度相差多少,还需要考虑激光测量误差的大小。
在真实 ROS 2 系统中,距离通常来自 sensor_msgs/msg/LaserScan 消息的 ranges 字段。每条射线的方向由 angle_min 和 angle_increment 确定;预测时还必须通过 TF 将雷达坐标系中的射线变换到地图坐标系,不能直接把机器人中心当作所有传感器的实际安装位置。
用高斯噪声计算观测似然
同样是 0.1 m 的残差,对精度约为厘米级的传感器可能值得怀疑,对噪声较大的传感器则可能完全正常。因此,残差不能单独当作位姿得分。
假设测量误差服从零均值高斯分布,标准差为 ,单束激光的观测似然密度可以写成:
其中 。该公式表示:在给定地图和位姿假设的条件下,出现当前距离读数的概率密度有多大。
为演示计算,设 m,得到:
| 指标 | 候选 A | 候选 B |
|---|---|---|
| 预测距离 | 4.0 m | 3.6 m |
| 残差 | -0.1 m | +0.3 m |
| 标准化残差 | -1 | +3 |
| 似然密度 | 2.420 | 0.044 |
两个候选的似然密度之比约为 。在当前高斯模型下,观测对 A 的支持明显强于 B。
噪声参数直接影响评分的区分能力。如果把 从 0.10 m 调大到 0.30 m,A 与 B 的似然比会从约 54.6 降到 1.56。噪声越大,相同残差差异通常越难区分。
实际系统应依据传感器标定、测距距离和现场条件确定噪声模型,而不是将演示中的 0.10 m 直接作为所有雷达的固定参数。
用 Python 比较两个候选位姿
下面使用 Python 3.9 或更新版本运行一个仅依赖标准库的示例。地图被简化为 m 的墙面,因此预测距离就是墙面横坐标减去候选位姿的横坐标。这里固定 、,不涉及旋转或复杂地图射线追踪。
import math

wall_x = 5.0
z = 3.9
sigma = 0.1
candidates = {"A": 1.0, "B": 1.4}
scores = {}

for name, x in candidates.items():
    # 仅适用于雷达朝+x且射线首先碰到x=5墙面的简化场景
    predicted = wall_x - x
    residual = z - predicted

    # 高斯观测似然密度,sigma表示测距误差标准差
    score = math.exp(-0.5 * (residual / sigma) ** 2) / (
        math.sqrt(2 * math.pi) * sigma
    )
    scores[name] = score
    print(f"{name}: zhat={predicted:.1f}m, r={residual:+.1f}m, pdf={score:.3f}")

print(f"A/B likelihood ratio={scores['A'] / scores['B']:.1f}")
预期输出:
A: zhat=4.0m, r=-0.1m, pdf=2.420
B: zhat=3.6m, r=+0.3m, pdf=0.044
A/B likelihood ratio=54.6
可以把 sigma 改成 0.3 再运行。预期结果是 A/B 似然比约为 1.6,而不是 54.6。这验证了测量噪声决定评分对残差的敏感程度。
程序只计算观测似然,没有加入运动模型或先验位姿概率。完整的贝叶斯定位还会结合先验或预测分布:
也就是说,某个位姿既要能够解释当前观测,也要结合已有定位信息判断其是否合理。
多束激光和异常观测如何处理
真实激光雷达通常一次返回数百甚至数千束距离。给定候选位姿和地图,需要分别预测各束距离,并将它们的观测似然合成为候选位姿的评分。
如果暂时假设各束测量误差在给定位姿和地图后条件独立,就可以将各束似然相乘。由于连续相乘容易产生浮点下溢,实际实现通常累加对数似然:
其中 是参与评分的有效射线数量。该条件独立假设只是计算近似,相邻激光束受同一障碍物和环境因素影响时可能存在相关性。
例如,一帧扫描有 360 束,可以先均匀抽取 36 束进行初步评分,再根据运算预算提高采样密度。这样能减少射线投射开销,但需要检查采样是否遗漏狭窄障碍物或重要几何特征。
处理 ROS 2 LaserScan 数据时,建议依次检查:
- 确认
header.frame_id对应的雷达坐标系能够通过有效时间戳的 TF 变换连接到地图坐标系。 - 读取
range_min、range_max,按传感器消息约定识别无效读数;对NaN、无穷值和超出有效范围的数值分别处理。 - 对有效测距射线执行地图射线投射,取得预测距离;无回波、最大量程和地图未知区域应按所选模型单独处理。
- 计算每束残差及对数似然,再合成候选位姿分数;比较候选时保持射线选择规则一致。
还必须处理地图与现实不一致的情况。例如地图中的走廊为空,但行人刚好挡住激光,真实测距会比地图预测距离短。此时直接使用单一且很窄的高斯分布,可能把正确位姿错误地判为低可信度。
一种简单的改进是建立混合观测模型:让 95% 的权重来自正常命中模型,其余 5% 来自表示异常测量的随机分布。更完整的激光束模型还可区分意外遮挡、最大量程返回和随机测量,相关权重需要基于真实数据验证。
观测模型评价的是候选位姿能在多大程度上解释传感器读数,并不直接给出唯一真实位置。只有将地图预测、合理的测量噪声、历史位姿信息和异常观测处理结合起来,才能得到可用于 SLAM 定位更新的可信评分。