
Redis 与缓存 / 系统课时
理解内存分配器与 RSS
理解内存分配器与 RSS
删除大量 Key 后,Redis 的 used_memory 可能明显下降,但操作系统看到的进程 RSS 却仍然很高。这并不一定是内存泄漏。本课从 Redis、内存分配器和操作系统三个层次解释这种差异,并给出判断碎片与保留内存的基本方法。
学习目标
- 区分 Redis 已使用内存、分配器驻留内存和进程 RSS
- 理解释放对象后内存为什么可能暂时留在分配器或进程地址空间中
- 使用
INFO memory判断 RSS 偏高是否值得继续排查
三层指标看到的不是同一件事
Redis 创建对象时,并不是每次都直接向操作系统申请与对象大小完全一致的一段物理内存。Redis 通常通过内存分配器管理申请、复用与释放,分配器再与操作系统的虚拟内存和物理页机制交互。
因此至少要区分三个观察层次:Redis 认为自己当前分配了多少内存,分配器当前持有或驻留了多少内存,以及操作系统最终把多少页面计入 Redis 进程的 RSS。它们的统计边界不同,数值不要求相等。
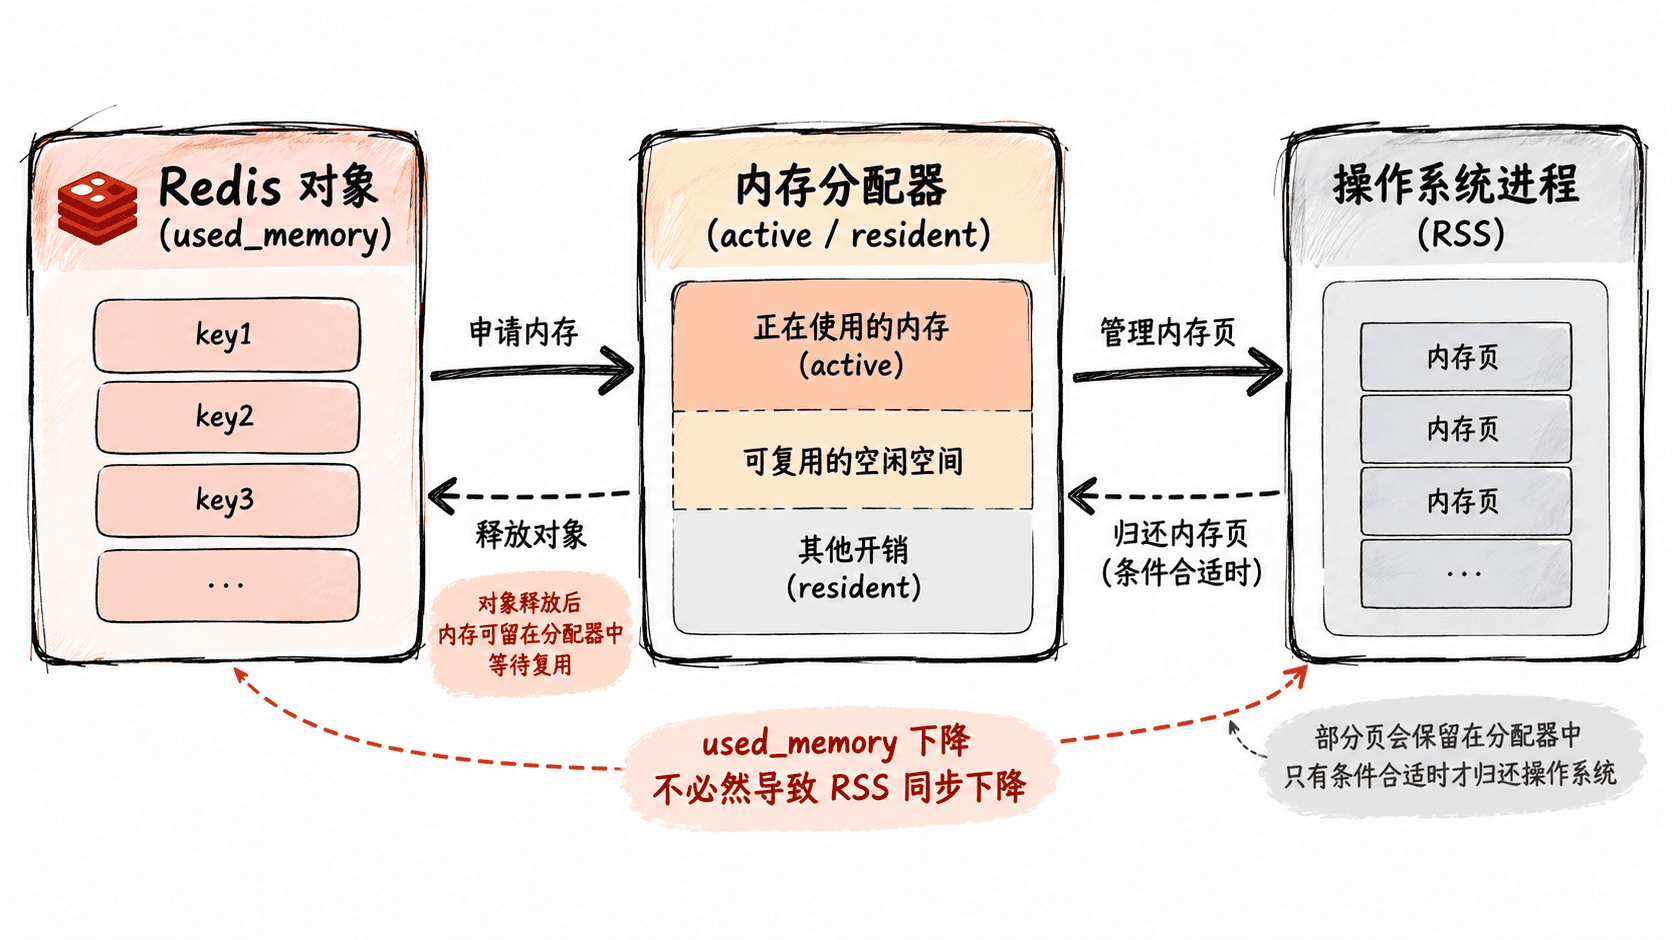
删除数据后为什么 RSS 不立即下降
当 Redis 删除对象时,相应内存会先回到分配器的可复用空间。后续新对象可能直接复用这些空间,而不必再次向操作系统申请,因此保留一部分空闲内存本身可以减少频繁申请和释放的成本。
问题在于,分配器管理内存的粒度与 Redis 对象并不一致。某个内存页或更大的分配区域里可能只释放了一部分对象,但仍有其他活跃对象占用。只要整个区域尚未满足归还条件,分配器就很难把其中零散的空洞直接交还操作系统。
这就是内存碎片的典型来源之一:Redis 逻辑上已经不再使用那些对象,但释放后的空间分散在仍然活跃的内存区域中。此时 used_memory 可以下降,而 RSS 下降得慢,甚至在一段时间内几乎不变。
读取 used_memory 与 RSS
首先读取 Redis 的内存统计:
redis-cli INFO memory预期输出
# Memory
used_memory:<VALUE>
used_memory_rss:<VALUE>
used_memory_rss_human:<VALUE>
mem_fragmentation_ratio:<VALUE>
mem_fragmentation_bytes:<VALUE>
allocator_allocated:<VALUE>
allocator_active:<VALUE>
allocator_resident:<VALUE>
<OTHER_MEMORY_FIELDS>
不同 Redis 版本、构建方式和分配器可能返回不同字段,因此实际排障时不要假定所有环境都有完全相同的字段集合。
used_memory 主要反映 Redis 经分配器分配并计入自身统计的内存;used_memory_rss 是操作系统观察到的 Redis 进程 RSS。allocator_allocated、allocator_active 与 allocator_resident 则用于继续观察分配器内部从已分配对象到活跃页、驻留页之间的差距。
不要只看碎片率一个数字
mem_fragmentation_ratio 常被直接理解为 used_memory_rss / used_memory 的近似关系,但单独使用这个比值很容易误判。实例数据量很小时,即便只有少量固定进程开销,也可能让比例显得很高;而一个大型实例即使比例只高出一点,对应的绝对字节数仍可能非常可观。
因此应同时查看 mem_fragmentation_bytes 以及分配器指标。例如 allocator_active 明显高于 allocator_allocated,通常说明分配器活跃区域内部存在不能被有效利用的空间;allocator_resident 又明显高于 allocator_active,则说明分配器仍保留了较多驻留页。
可以只提取关键字段,避免在现场被大量指标干扰:
redis-cli INFO memory | grep -E '^(used_memory:|used_memory_rss:|mem_fragmentation_ratio:|mem_fragmentation_bytes:|allocator_allocated:|allocator_active:|allocator_resident:)'预期输出
used_memory:<VALUE>
used_memory_rss:<VALUE>
mem_fragmentation_ratio:<VALUE>
mem_fragmentation_bytes:<VALUE>
allocator_allocated:<VALUE>
allocator_active:<VALUE>
allocator_resident:<VALUE>
如果当前系统没有 grep,可以直接查看完整的 INFO memory 输出。动态数值会随写入、删除和后台任务持续变化,应关注相对关系和趋势,而不是某一次采样的最后几位数字。
用删除实验观察两种内存变化
在测试环境中可以写入一批数据,记录内存,再删除后重新观察。下面的命令只适合实验实例,不要对生产数据执行 FLUSHDB:
redis-cli SET memory:test "$(printf 'x%.0s' {1..10000})"
redis-cli INFO memory | grep -E '^(used_memory:|used_memory_rss:)'
redis-cli DEL memory:test
redis-cli INFO memory | grep -E '^(used_memory:|used_memory_rss:)'
预期输出
OK
used_memory:<VALUE>
used_memory_rss:<VALUE>
(integer) 1
used_memory:<LOWER_OR_SIMILAR_VALUE>
used_memory_rss:<VALUE>
删除单个 10 KB 左右的键未必足以让指标出现肉眼可见的变化,因为 Redis 和分配器还有其他固定开销。真实实验通常需要更多数据才能观察趋势。关键现象是:删除对象后 used_memory 的变化通常比 RSS 更直接,而 RSS 是否下降取决于空闲空间能否形成可归还的页以及分配器后续的回收行为。
什么时候值得把 RSS 偏高当成问题
如果 used_memory 与业务数据一起持续增长,首先应排查数据规模、Key 模型和非数据集内存,而不是把责任归给分配器。如果 used_memory 已显著下降,但 RSS 长时间保持在高位,并且绝对差值已经影响容器限制或主机可用内存,就应进一步分析碎片与分配器驻留情况。
Redis 在支持的构建与配置下可以使用主动碎片整理功能,但它会消耗额外 CPU,不能把它当作“看到碎片率高就开启”的固定动作。是否处理应基于绝对浪费字节、持续时间、实例负载以及 OOM 风险综合判断。
真正重要的是建立正确的观察边界:used_memory 回答 Redis 当前分配了多少,分配器指标解释这些内存如何被组织和保留,RSS 则说明操作系统当前看到多少物理页驻留。只有把三层放在一起看,才能区分正常的分配器保留、碎片问题和真正需要处理的异常增长。