
Redis 与缓存 / 系统课时
识别 fork 与写时复制风险
识别 fork 与写时复制风险
本课解决 Redis “平时内存正常,执行后台保存或 AOF 重写时却突然逼近 OOM”的问题。关键不在于简单把 Redis 数据集大小再加一遍,而是理解 fork 创建子进程后,父子进程共享页并采用 Copy-on-Write,从而让写入高峰带来额外物理内存压力。
学习目标
- 理解
fork与 Copy-on-Write 的内存关系 - 估算后台保存和 AOF 重写期间的内存风险
- 结合 RSS、写入速率和峰值水位判断是否接近 OOM
fork 为什么会制造内存峰值
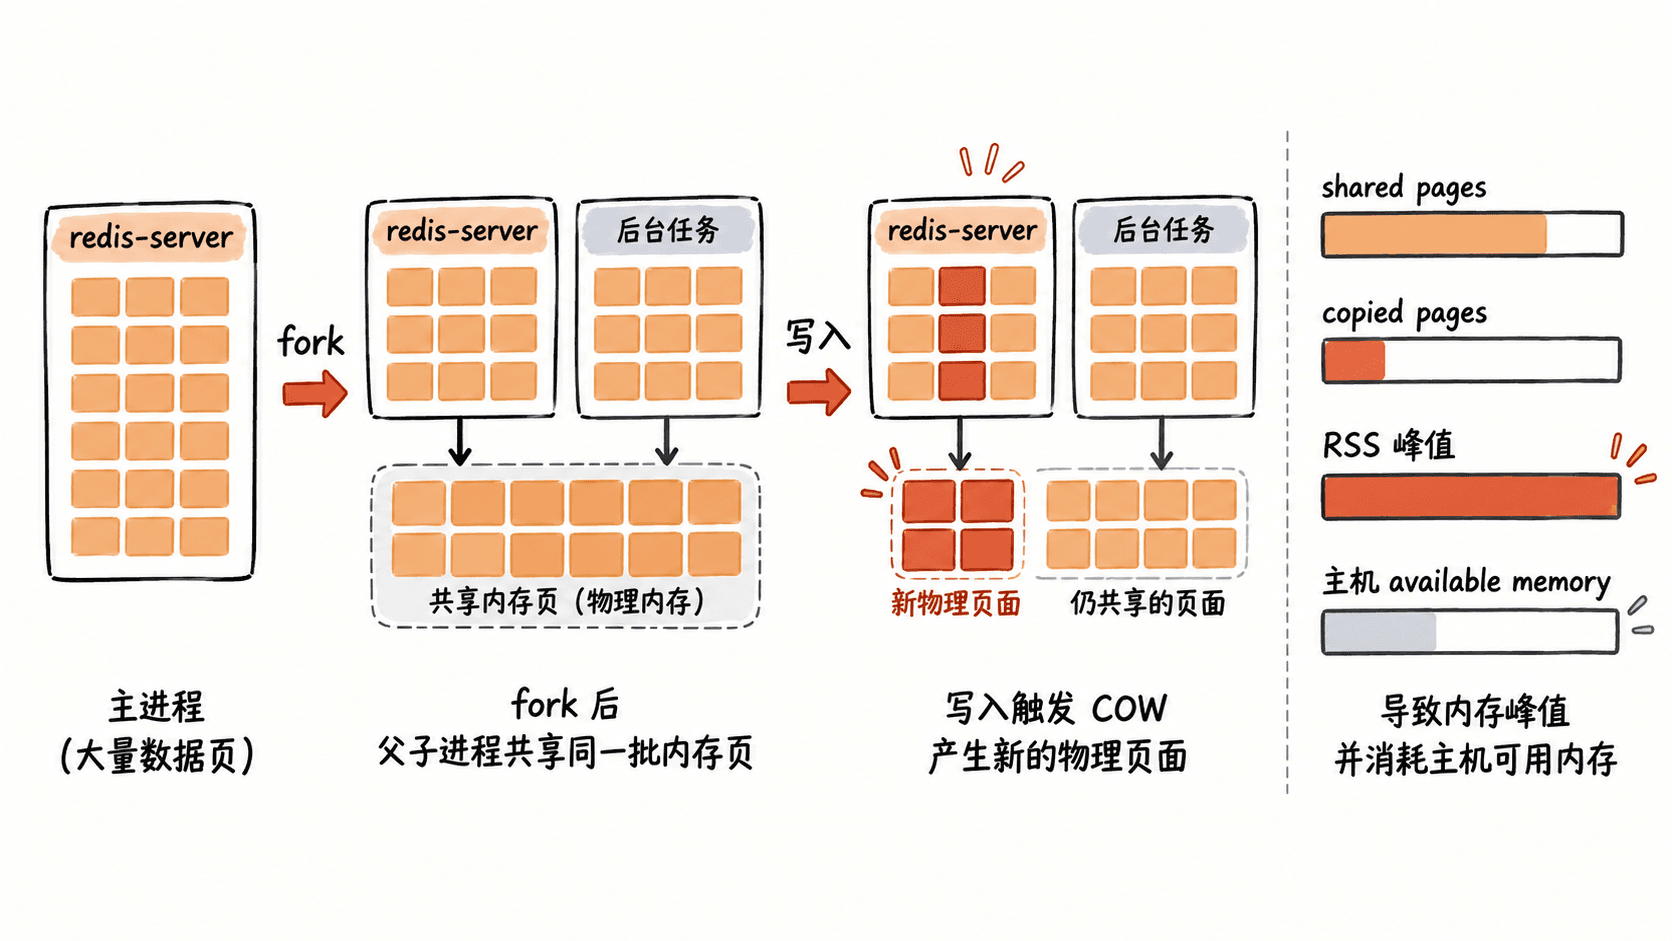
Redis 在执行后台保存或后台 AOF 重写时,会通过 fork 创建子进程。fork 并不会立即把父进程全部内存复制一份;父子进程最初共享已有内存页,只有某个进程修改某页时,内核才通过 Copy-on-Write 复制该页。
因此风险取决于子进程存在多久、父进程修改了多少页以及主机还能提供多少空闲内存。如果 Redis 数据集很大但期间几乎没有写入,额外物理内存可能相对有限;如果数据集很大且写入持续旺盛,COW 页会不断产生,RSS 峰值可能明显上升。
哪些操作会触发这个风险
典型场景包括 RDB 后台保存、AOF 后台重写,以及与之相近的后台 fork 工作负载。真正危险的组合通常是“大数据集 + 持续写入 + 长时间后台任务”,因为后台子进程存活越久,父进程继续修改页面的机会越多。
可以先观察当前内存和后台任务状态,再结合写入期间的 RSS 变化做判断。
redis-cli INFO memory | grep -E 'used_memory:|used_memory_rss:|used_memory_peak:|mem_fragmentation_ratio:'
redis-cli INFO persistence | grep -E 'rdb_bgsave_in_progress:|aof_rewrite_in_progress:|rdb_current_bgsave_time_sec:|aof_current_rewrite_time_sec:'
预期结果
used_memory:6291456000
used_memory_rss:7340032000
used_memory_peak:8388608000
mem_fragmentation_ratio:1.17
rdb_bgsave_in_progress:1
aof_rewrite_in_progress:0
rdb_current_bgsave_time_sec:12
aof_current_rewrite_time_sec:0
这里最值得关注的是后台任务是否正在进行,以及 used_memory_rss 是否明显高于平时基线。mem_fragmentation_ratio 可以作为辅助信号,但不能直接把它解释成“全部都是 COW 内存”;分配器碎片、共享页和其他进程都会影响实际 RSS。
用峰值而不是静态容量做判断
生产容量规划不能只看 Redis 数据集大小。例如 Redis 管理的数据约为 6 GiB,并不意味着进程峰值只需要略高于 6 GiB。还要预留 Redis 非数据开销、分配器碎片、后台任务带来的 COW 增量,以及宿主机或 cgroup 的其他内存消耗。
一个实用的粗略模型是:
其中 M_COW 与写入模式相关,不能固定按某个百分比拍脑袋。更可靠的方法是在接近真实数据量的环境中执行一次后台保存或 AOF 重写,同时记录 RSS 峰值,并把最差写入窗口纳入容量基线。
通过写入压力验证 COW 风险
最有效的验证不是单独运行一次 BGSAVE,而是在后台任务持续期间观察 Redis RSS 是否随写入增长。下面示例每秒采样一次,适合在实验环境中验证趋势;生产环境应先确认监控和采样不会造成额外压力。
for i in $(seq 1 10); do
  date '+%H:%M:%S'
  redis-cli INFO memory | grep -E 'used_memory:|used_memory_rss:|used_memory_peak:'
  redis-cli INFO persistence | grep -E 'rdb_bgsave_in_progress:|aof_rewrite_in_progress:'
  sleep 1
done
预期结果
10:42:01
used_memory:6291456000
used_memory_rss:7340032000
used_memory_peak:8388608000
rdb_bgsave_in_progress:1
aof_rewrite_in_progress:0
10:42:02
used_memory:6304034816
used_memory_rss:7497316352
used_memory_peak:8388608000
rdb_bgsave_in_progress:1
aof_rewrite_in_progress:0
10:42:03
used_memory:6316627968
used_memory_rss:7661428736
used_memory_peak:8388608000
rdb_bgsave_in_progress:1
aof_rewrite_in_progress:0
如果 used_memory 增长不大,但 used_memory_rss 在后台任务期间持续抬升,这与 COW 或其他进程级内存压力相符。若后台任务结束后 RSS 回落,则进一步说明峰值与后台任务窗口有关;若始终不回落,则还需要继续检查分配器碎片、长期增长和其他进程影响。
怎么降低 fork 风险
治理的核心不是简单关闭后台保存,而是降低峰值出现时的资源紧张程度。首先要保证实例的内存水位与宿主机或 cgroup 上限之间存在明确余量;其次要避免在高写入、高碎片、高后台任务重叠时把多个风险叠加到同一个窗口。
对于必须持续执行持久化的实例,应基于真实数据规模和写入模式测量后台任务期间的 RSS 峰值,而不是只按照 maxmemory 设计容量。maxmemory 主要控制 Redis 数据集策略,并不能替代对 fork、COW 和宿主机内存的容量规划。
最终判断是否存在 fork 与 COW 风险,应把三个时间序列放在一起看:后台任务状态、Redis 的 used_memory_rss、同时间窗口的写入量或系统可用内存。只有当它们在时间上形成一致的峰值关系时,才有足够证据把 OOM 风险归因于 fork 引起的额外内存需求。