
Redis 与缓存 / 系统课时
控制内存瞬时峰值
控制内存瞬时峰值
Redis OOM 风险并不只来自数据持续增长,还可能来自一次批量写入、复制、持久化或迁移造成的瞬时额外占用。治理的目标不是只压低平时 used_memory,而是让峰值发生时仍有足够余量,避免业务在短时间内越过机器或实例的安全边界。
学习目标
- 能识别批量写入、复制、持久化和迁移产生瞬时内存的主要位置
- 能用批次、并发和水位限制峰值,而不是只依赖
maxmemory - 能根据峰值来源设计可观测、可回退的操作窗口
先把峰值来源拆开
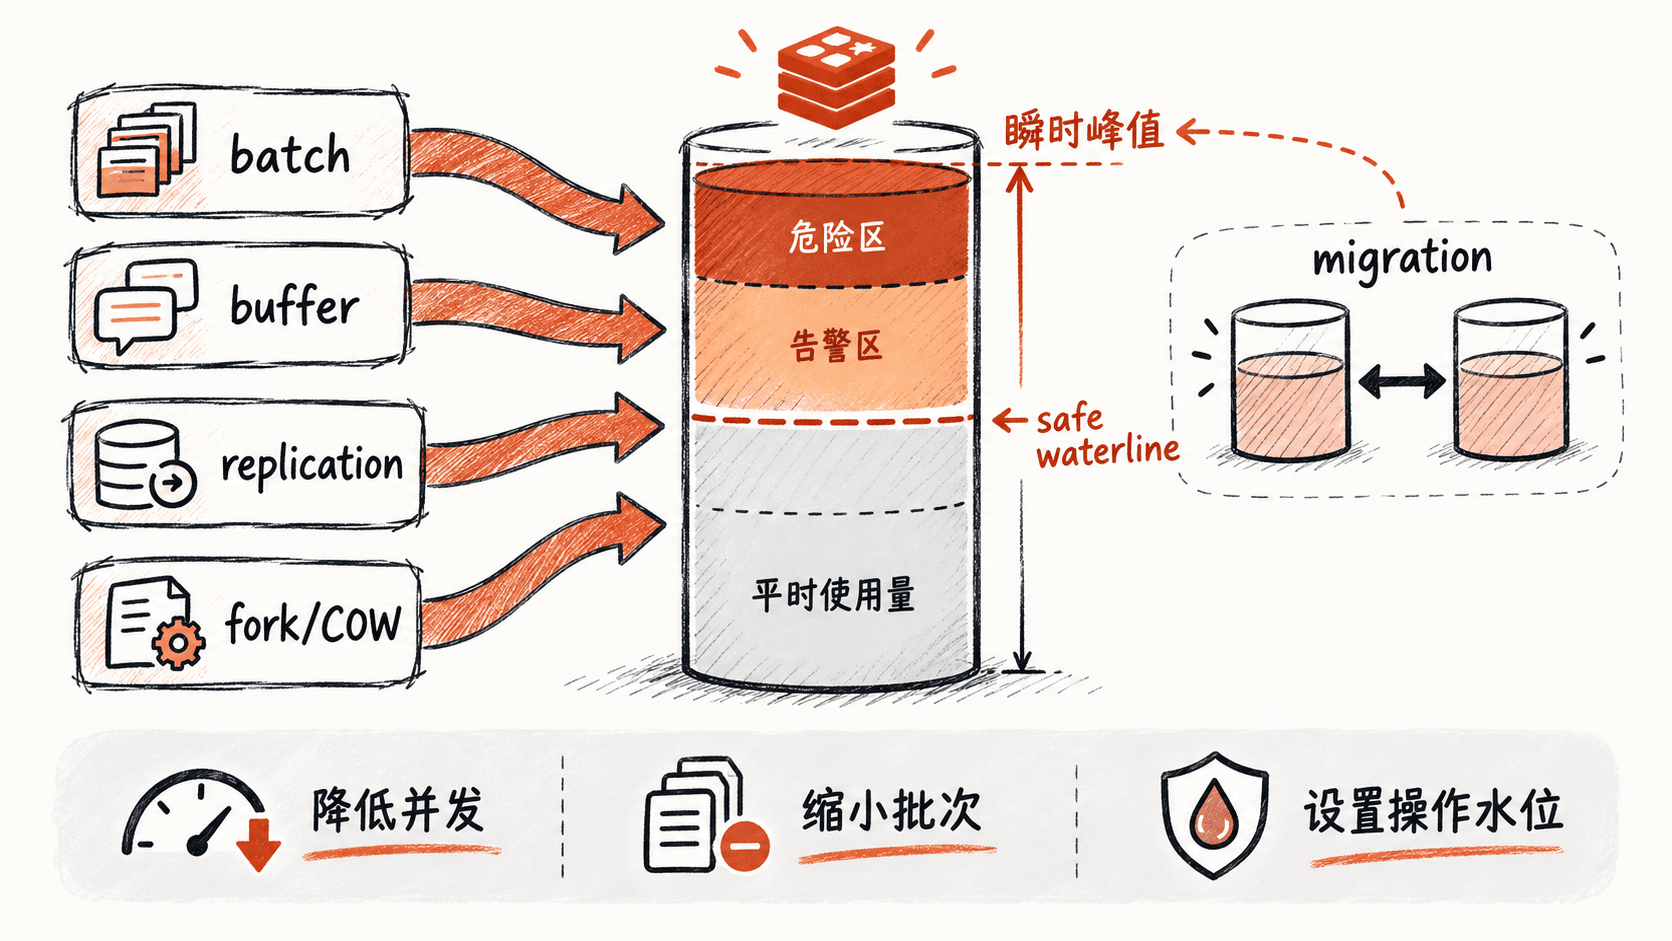
瞬时内存通常不是一个单独的大对象突然出现,而是多个额外内存来源叠加。批量写入会增加数据本身;客户端输出缓冲会暂时堆积返回数据;复制会产生复制积压和客户端输出缓冲;持久化期间还可能因为后台 fork 与写时复制产生额外 RSS;迁移操作则可能同时存在源端和目标端的数据占用。
用峰值而不是平均值做容量预算
先读取历史峰值与当前内存,再判断操作是否接近水位。used_memory_peak 能帮助识别 Redis 管理内存曾达到的高点,但它不能替代对 RSS 与复制、持久化额外开销的观察。
redis-cli -h <IP> -p <PORT> INFO memory | grep -E '^(used_memory:|used_memory_peak:|used_memory_rss:|maxmemory:|mem_not_counted_for_evict:)'预期输出
used_memory:734003200
used_memory_peak:905969664
used_memory_rss:1073741824
maxmemory:1073741824
mem_not_counted_for_evict:67108864
这里最危险的信号不是单一字段超过某个固定阈值,而是当前 RSS 已经接近机器或实例可承受上限,同时业务操作还准备制造额外内存。maxmemory 主要约束 Redis 的可驱逐内存,并不能保证操作系统层面的 RSS 在所有瞬时场景下都不会继续上涨。
容量预算应该至少预留三部分:正常业务内存、预期峰值增量、保护余量。保护余量被批量任务或后台操作持续侵蚀时,应先降低操作规模,而不是等系统进入危险区后再依赖 OOM 或驱逐。
用批次和并发削平批量操作
批量写入最容易犯的错误是一次构造过大的请求,并让多个 worker 同时执行。更稳妥的做法是固定批次大小,再通过并发上限控制单位时间内同时存在的临时对象数量。
下面用 shell 轮询演示一种简单的水位保护方式:只有当前 RSS 低于预设阈值时才继续下一批。实际生产应把阈值放入配置或发布系统,而不是硬编码业务逻辑。
set -euo pipefail

HOST=<IP>
PORT=<PORT>
SAFE_RSS_BYTES=900000000
BATCH=500

for ((start=0; start<5000; start+=BATCH)); do
  rss=$(redis-cli -h "$HOST" -p "$PORT" INFO memory | awk -F: '/^used_memory_rss:/{print $2}')
  if (( rss >= SAFE_RSS_BYTES )); then
    echo "PAUSE start=$start rss=$rss"
    exit 0
  fi

  echo "RUN start=$start batch=$BATCH"
  # 实际任务在这里提交一个固定大小的数据批次。
done
预期输出
RUN start=0 batch=500
RUN start=500 batch=500
RUN start=1000 batch=500
PAUSE start=1500 rss=912384000这个模式的关键不是脚本本身,而是让任务具备自我刹车能力。批次越大,单次峰值通常越高;并发越高,同时存在的临时对象和网络缓冲越多。应优先减少单批规模,再逐步增加并发,而不是同时把两者拉高。
持久化和复制要单独留余量
执行持久化、复制初始化或大量写入时,必须重新计算安全水位。后台 fork 产生的写时复制开销与写入速率和页修改有关,并不是简单等于 used_memory 的固定百分比,因此不能用一个永远正确的静态系数覆盖所有业务。
复制还应关注复制积压、复制缓冲以及客户端输出缓冲。大批量写入如果同时让副本追赶压力升高,峰值可能叠加出现。此时更重要的是限制写入节奏,让后台链路有机会追平,而不是单纯继续扩大吞吐。
建立操作水位
生产环境可以把内存保护做成三段式:正常区允许任务运行;告警区降低并发并缩小批次;危险区立即暂停批量任务、迁移任务以及非必要后台操作,并优先恢复内存余量。
水位不应只看 used_memory。至少同时关注 used_memory_rss、历史峰值、复制与客户端缓冲,以及持久化任务的运行状态。只有把“当前占用”和“下一次操作可能增加多少”放在一起,水位才真正有保护意义。
最终治理目标是让高峰变得可预测:批量任务有固定批次和并发上限,后台操作有开始前检查,达到水位能够自动暂停,恢复到安全区后再继续。这样即使峰值无法完全消除,也能把它从不可控的 OOM 事件变成可以观察、暂停和恢复的容量事件。