
Redis 与缓存 / 系统课时
建立 Redis 内存治理手册
建立 Redis 内存治理手册
本课把 Redis 内存告警、现场取证、应急处置、升级条件和长期整改串成一套值班可执行的手册,目标是在高压故障中先止损、再留证、后恢复,并让复盘结果能够转化为容量和监控改进。
学习目标
- 能按统一顺序完成 Redis 内存故障的告警确认、证据保存与现场判断。
- 能选择安全的应急动作,并明确哪些情况必须升级处理。
- 能把一次故障整理为可跟踪的长期整改项,避免同类 OOM 重复发生。
先固定值班处置顺序
手册不要从“先执行什么命令”开始,而应先固定决策顺序:确认影响范围 → 保存现场证据 → 判断 Redis 层还是容器/主机层问题 → 止住继续增长或降低风险 → 验证恢复 → 升级与记录。这样即使值班人员经验不同,也不会因为遗漏证据而失去根因线索。
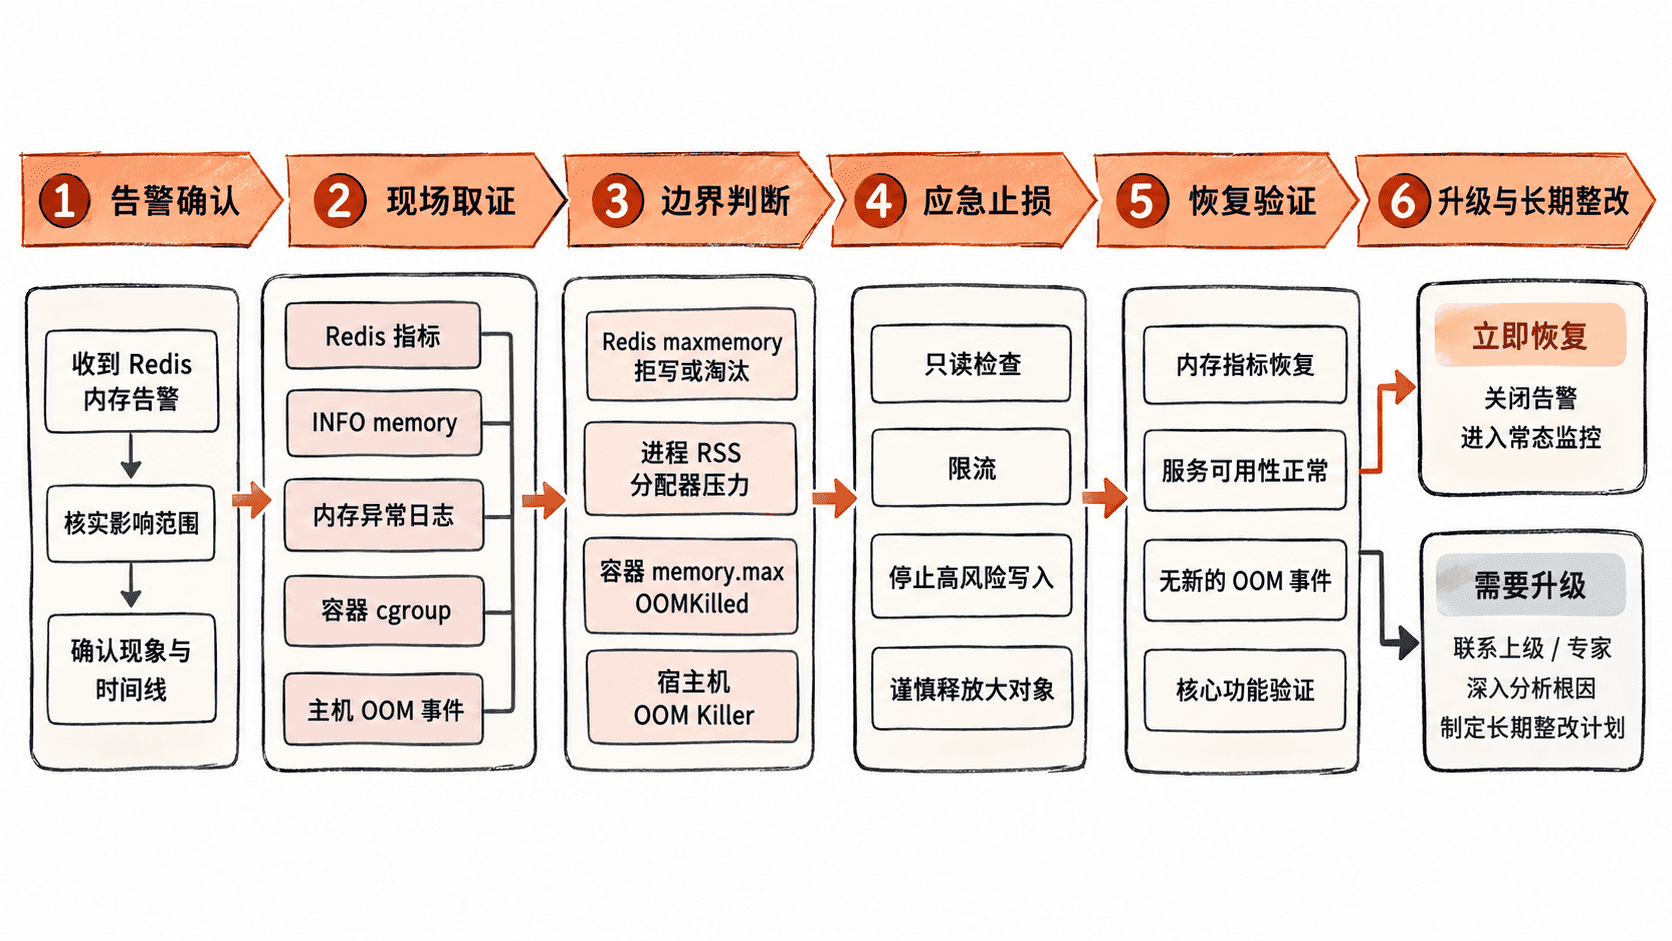
告警确认阶段至少回答三个问题:当前使用量是否仍在增长、Redis 是否已经拒写或开始淘汰、业务是否已经受到延迟或错误影响。不要看到 used_memory 很高就直接认定是 OOM,因为 Redis、容器和宿主机的内存边界并不相同。
保存一份最小现场证据
故障处理中优先保存“可重复判断”的数据,而不是只截一张监控图。至少记录采样时间、实例身份、INFO memory、INFO stats、客户端连接数、最近错误日志,以及容器或主机侧的内存事件。命令本身可以按环境调整,但证据采集顺序应固定。
redis-cli -h <IP> -p <PORT> INFO memory
redis-cli -h <IP> -p <PORT> INFO stats
redis-cli -h <IP> -p <PORT> INFO clients
redis-cli -h <IP> -p <PORT> CONFIG GET maxmemory
redis-cli -h <IP> -p <PORT> CONFIG GET maxmemory-policy
预期结果
# Memory
used_memory:<VALUE>
used_memory_rss:<VALUE>
maxmemory:<VALUE>

# Stats
evicted_keys:<VALUE>
keyspace_hits:<VALUE>
keyspace_misses:<VALUE>

# Clients
connected_clients:<VALUE>

maxmemory
<VALUE>

maxmemory-policy
<VALUE>
将命令输出与 <TIME> 对齐保存,并保留连续两个或以上时间点。单点数据只能说明“现在是多少”,不能证明增长速度、淘汰趋势或 RSS 是否正在扩大。
应急动作要有先后和边界
第一优先级是停止故障继续扩大,例如降低高峰写入、限制异常流量、暂停非必要批任务。第二优先级才是处理明显的内存来源,例如确认过期与淘汰是否工作、定位高风险大 Key、检查客户端输出缓冲区。对超大对象不要在高峰期盲目执行同步删除;需要释放大型复杂对象时,应优先评估异步释放对延迟和剩余内存的影响。
涉及配置改变时,手册必须记录“动作、执行人、时间、变更前值、变更后值、回滚方式”。任何会扩大业务风险的操作,例如随意重启、直接删除大量业务数据或修改淘汰策略,都应先经过升级门禁。
明确什么时候必须升级
出现容器 OOMKilled、宿主机 OOM Killer、RSS 已逼近容器上限、内存仍持续快速增长,或者确认存在无法快速隔离的异常写入时,应立即升级给负责 Redis 平台、基础设施和业务流量控制的人员。升级时不要只说“Redis 内存满了”,而要附带影响范围、证据时间线、已执行动作和当前风险。
升级记录建议固定成一段短文本:现象 + 首次出现时间 + 当前内存水位 + Redis 行为 + 容器/主机事件 + 已执行止损 + 下一门禁。这样接手人员可以直接继续判断,而不是重新采集一遍现场。
把故障转成长期整改项
恢复后不要立即关闭事件。至少检查四类问题:容量是否有足够余量、增长来源是否明确、告警是否能在业务受影响前触发、应急动作是否真的可执行。整改项应绑定具体负责人和验收指标,例如降低高基数 Key 增长率、限制单实例客户端缓冲区风险、调整最大内存安全水位、增加 cgroup 内存告警或完善高峰期扩容策略。
一次故障的最终成果不是“Redis 又恢复了”,而是留下了一条可以复用的证据链和一组已经验证过的处置动作。把这些内容沉淀进值班手册,并在下一次演练中按同一顺序执行,才能让内存治理从个人经验变成稳定的运行能力。