
Redis 与缓存 / 系统课时
识别高基数 Key 增长
识别高基数 Key 增长
本课解决的是另一类内存增长问题:单个 Key 看起来都不大,但 Key 总数和业务命名空间持续膨胀,最终把 Redis 内存推向上限。你将通过数量、命名模式、业务维度和 TTL 快照,把正常增长与泄漏式写入、过期缺失区分开。
学习目标
- 能按数据库总 Key 数和命名模式统计高基数增长。
- 能用连续快照判断某个业务命名空间是在正常增长,还是出现异常增量。
- 能结合 TTL、业务维度和写入来源判断“正常增长、泄漏式写入、过期缺失”三类情况。
先看总量,再拆命名空间
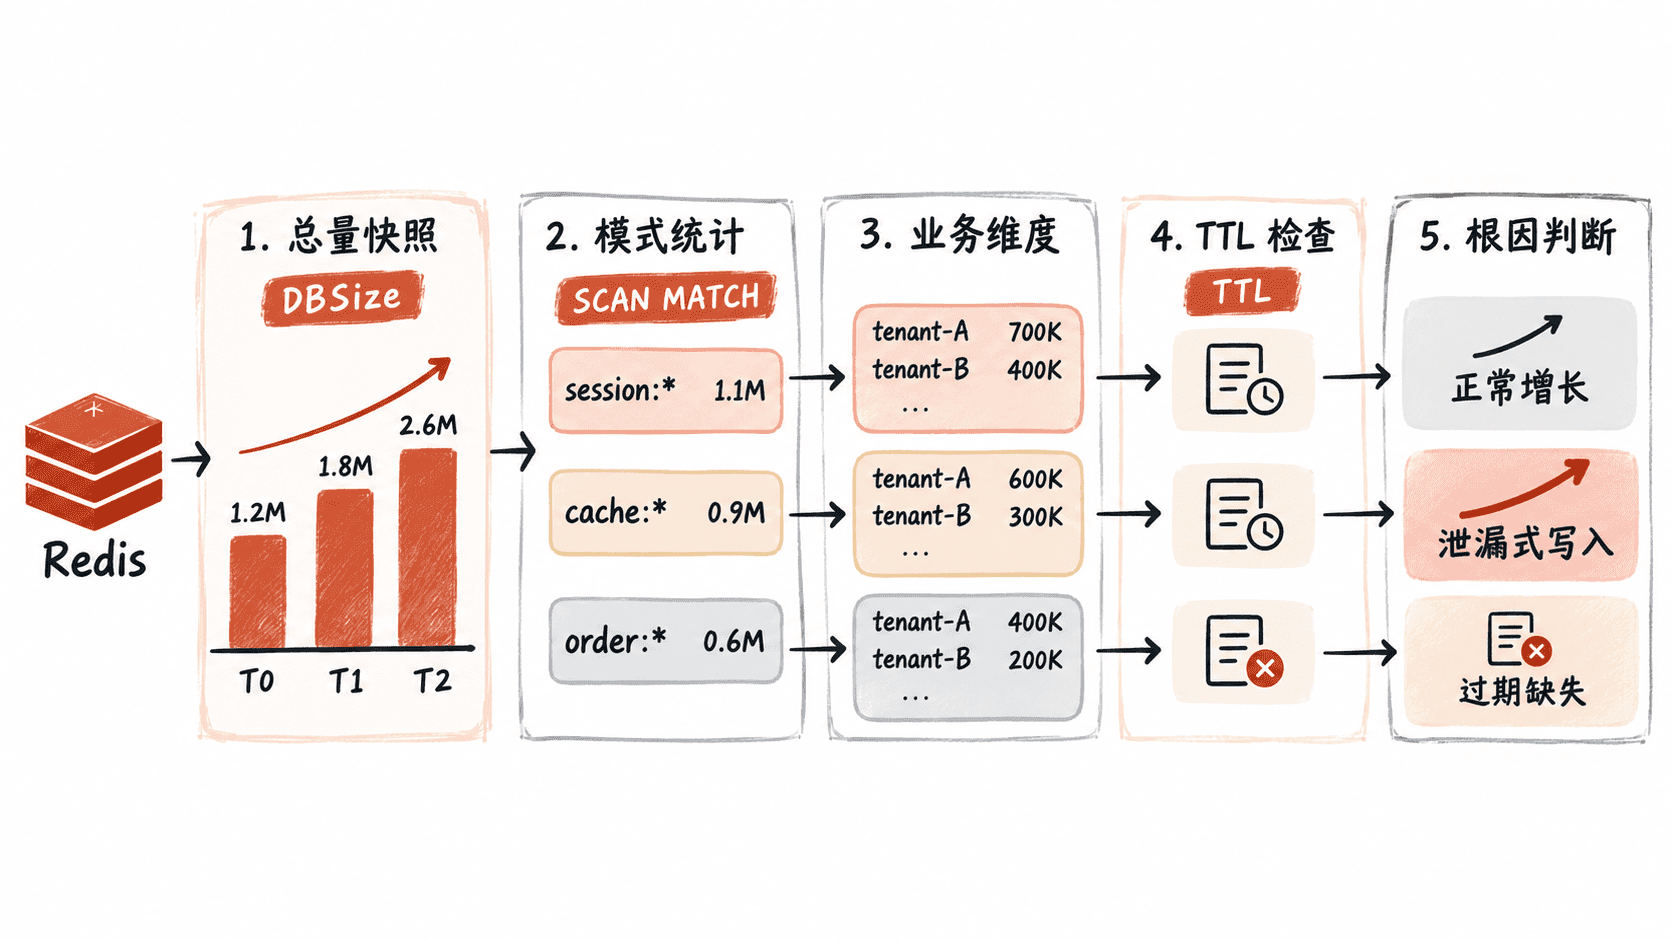
高基数问题首先表现为 Key 数量变化,而不是某个 Key 特别大。DBSIZE 可以快速查看当前数据库中的 Key 数量;真正有价值的是把它和不同命名空间的数量放在一起比较,例如 session:*、cache:*、order:* 或带租户、业务线标识的模式。
对线上数据做模式分析时,不要把 KEYS * 当成常规排障手段。更安全的入口是 SCAN MATCH,它通过游标分批遍历,适合逐步统计候选命名空间。
用连续快照确认是否真的在增长
单次 DBSIZE 没法证明存在泄漏。需要至少记录两个时间点,并计算某个命名空间的 Key 增量。实际值可能受业务流量影响,因此最好选择业务低峰与高峰之外的稳定窗口进行对比。
redis-cli -h <IP> -p <PORT> DBSIZE
redis-cli -h <IP> -p <PORT> SCAN 0 MATCH 'session:*' COUNT 1000
redis-cli -h <IP> -p <PORT> SCAN 0 MATCH 'cache:*' COUNT 1000
预期结果
<VALUE>
1) "<ID>"
2) 1) "session:<ID>"
   2) "session:<ID>"
   3) "session:<ID>"
1) "<ID>"
2) 1) "cache:<ID>"
   2) "cache:<ID>"
SCAN 的第一项是游标,不是 Key 数量;返回数量还受 COUNT 影响,而且一轮从 0 扫到 0 才完成整个遍历。因此示例中的一次命令只能说明“当前扫描批次看到哪些 Key”,不能直接当成命名空间总量。
要得到某个模式的总数,应持续取游标直到返回 0,并累计第二项数组中的 Key 数量。生产环境建议把这种统计放在受控脚本或后台任务中,并限制运行频率,避免人工反复扫描。
用 TTL 区分正常缓存和过期缺失
高基数 Key 最关键的分叉点之一是生命周期。正常的临时缓存、Session 或幂等键通常应有明确的过期策略;如果业务声称这些 Key 会自动淘汰,却发现大量对象 TTL 为 -1,就需要重点检查写入路径是否漏掉了 EXPIRE 或对应的带过期写入命令。
redis-cli -h <IP> -p <PORT> SET demo:session:<ID> value EX 300
redis-cli -h <IP> -p <PORT> TTL demo:session:<ID>
redis-cli -h <IP> -p <PORT> SET demo:leak:<ID> value
redis-cli -h <IP> -p <PORT> TTL demo:leak:<ID>
预期结果
(integer) 300
(integer) <VALUE>
(integer) -1
第一个 TTL 会返回接近 300 的正整数,并随着时间减少;第二个返回 -1,表示 Key 存在但没有设置过期时间。这里不能把所有 TTL=-1 都直接判定为泄漏,因为永久缓存、配置数据等本来就可能设计为不过期,必须结合命名模式和业务语义判断。
按业务维度找异常来源
发现总 Key 数增长后,继续问“是谁在增长”。例如同样是 session:*,tenant-A 每分钟增加几十个可能正常,而 tenant-B 持续每分钟增加数万个且业务流量并未同步增长,就更值得调查。
可以把观察结果整理成“时间点、命名空间、业务维度、Key 数、带 TTL 比例、无 TTL 比例、业务流量”几个字段。不要只比较绝对数量,还要比较增长斜率:单位时间新增 Key 越来越高,通常比稳定的小幅增长更可疑。
正常增长通常表现为 Key 增量与业务流量、用户量或订单量同步;泄漏式写入常表现为某个维度持续新增,而业务对象已经结束生命周期;过期缺失则常表现为本应临时存在的 Key 长期 TTL=-1,或者 Key 数在业务流量下降后仍不回落。
建立可重复的判断门槛
当 Redis 内存持续上涨时,不要只看一次 INFO memory 或一次 Key 总数。至少保留连续快照,并把“总量变化”和“命名空间变化”绑定起来,再抽样检查代表性 Key 的 TTL 与创建逻辑。
一个实用的判断顺序是:先确认总 Key 数是否增长,再定位增长最快的命名空间,然后按租户、用户、任务等业务维度拆分,最后检查这些 Key 的 TTL 是否符合设计。这样能把“Redis 变大了”转换成可以交给开发修复的具体证据,例如“某命名空间持续新增、与流量不匹配,且大多数临时 Key 没有过期时间”。