
Redis 与缓存 / 系统课时
设计内存水位与告警
设计内存水位与告警
本课把 Redis 内存监控从“快满了才报警”改成分层水位。你会同时观察 used_memory、RSS、maxmemory 使用比例、内存碎片和增长速度,让告警既能发现容量逼近,也能发现碎片异常和增长加速。
学习目标
- 能区分
used_memory、RSS 与maxmemory使用比例所表达的问题 - 能按预警、严重和容量风险设计分级水位
- 能用增长速度与碎片信号提前发现潜在 OOM 风险
先建立四类监控信号
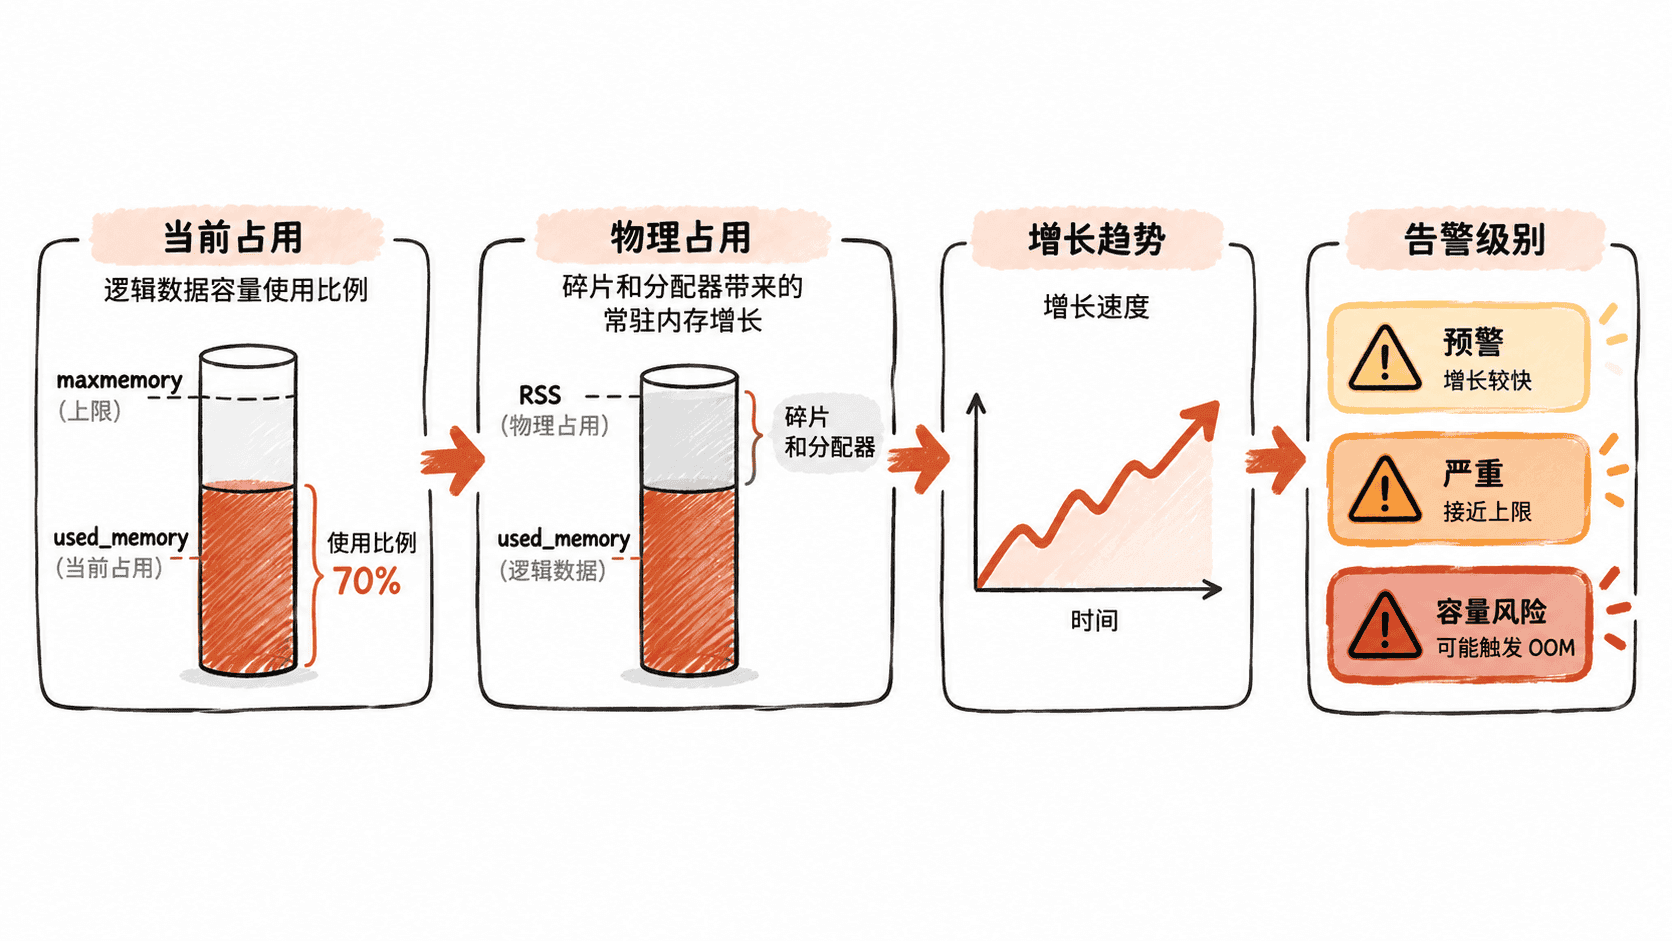
used_memory 更接近 Redis 自身管理的数据和对象内存;RSS 反映进程从操作系统实际获得的常驻内存。两者的差值可能受到内存分配器、碎片和进程运行状态影响,因此只看其中一个指标容易漏掉风险。
maxmemory 则是 Redis 对数据淘汰容量施加的逻辑上限。监控时建议同时计算 used_memory / maxmemory,再结合 RSS 与碎片观察实例是否已经接近物理资源边界。
计算水位而不是只设一个阈值
水位设计的目标不是寻找一个“绝对正确”的百分比,而是让团队在风险扩大前获得处理时间。可以先使用三档相对水位,再根据实例规格和历史峰值校准。
例如,以 used_memory / maxmemory 作为逻辑容量水位:70% 可作为观察线,80% 作为明确预警,90% 作为高风险线。这里的数字只是治理起点,不能直接视为所有业务的生产标准;高峰波动大、重建时间长或复制压力高的实例,应设置更保守的门槛。
redis-cli -h <IP> -p <PORT> INFO memory | grep -E '^(used_memory:|used_memory_human:|used_memory_rss:|maxmemory:|mem_fragmentation_ratio:)'预期结果
used_memory:7340032000
used_memory_human:6.83G
used_memory_rss:8053063680
maxmemory:8589934592
mem_fragmentation_ratio:1.10
按照这组示例数据,逻辑容量使用率约为 79.1%,属于接近预警线的状态;RSS 高于 used_memory,说明还存在进程层面的额外常驻占用。实际值会因实例当前状态而变化。
把碎片与增长速度纳入告警
碎片率适合回答“Redis 已管理的内存与进程 RSS 之间是否出现明显差异”,但不应单独作为 OOM 判断。关键是看它是否持续上升,以及 RSS 是否已经逼近宿主机可用内存。
增长速度则解决另一个问题:当前只用了 70%,但如果过去一小时增长很快,可能比“静态 90%”更值得关注。可以同时监控最近窗口的内存增量,例如:
将增长速度与剩余空间结合,可以估算剩余安全时间。假设当前剩余可用逻辑空间为 1.5 GiB,最近稳定增长速度为 300 MiB/小时,则仅按该趋势计算的容量耗尽时间约为 5 小时。峰值和突发写入会让实际时间更短,所以趋势指标应承担提前预警,而不是精确倒计时。
设计告警分级与处理动作
告警必须绑定动作,否则水位越多,值班人员反而越难判断。建议把监控信号分成“观察、预警、紧急”三个处理层级:观察阶段关注增长和趋势;预警阶段检查增长来源并准备扩容;紧急阶段限制风险操作、降低写入压力或立即扩容。
| 水位信号 | 典型含义 | 处理重点 |
|---|---|---|
| used/maxmemory 持续升高 | 逻辑容量逼近上限 | 检查增长来源并评估扩容 |
| RSS 明显高于 used_memory | 进程额外占用或碎片增大 | 检查碎片、分配器与大对象操作 |
| 增长速度突然升高 | 写入模式或数据规模异常 | 定位新增业务、Key 数量和单条成本 |
| 多信号同时恶化 | 接近实际 OOM 风险 | 优先止损并执行容量处置 |
生产告警不要把“超过阈值”作为唯一条件。更可靠的规则是同时观察绝对水位、持续时间和增长趋势,例如“使用率高位持续若干分钟且增长速度仍为正”比单次瞬时越线更有行动价值。
最终的内存告警体系应该让值班人员在真正 OOM 之前得到明确答案:容量还剩多少、增长有多快、RSS 是否异常、下一步应该扩容还是先止损。 这样告警才真正服务于容量治理,而不是只记录一次故障。