
Redis 与缓存 / 系统课时
排查容器 OOMKilled
排查容器 OOMKilled
Redis 容器出现 OOMKilled,说明问题已经越过 Redis 自己的 maxmemory 控制,进入了容器或宿主机的内存控制层。排查的关键不是看 Redis 是否“快到 maxmemory”,而是同时核对 cgroup 上限、当前内存、RSS、工作集和重启时间,确认究竟是谁触发了内核的终止。
学习目标
- 能区分 Redis maxmemory OOM 与容器 OOMKilled 的触发层级
- 能通过 cgroup 和容器运行时数据判断内存峰值是否越过限制
- 能结合重启时间、RSS 与 Redis 指标建立 OOMKilled 的证据链
先确定到底是哪一层杀掉进程
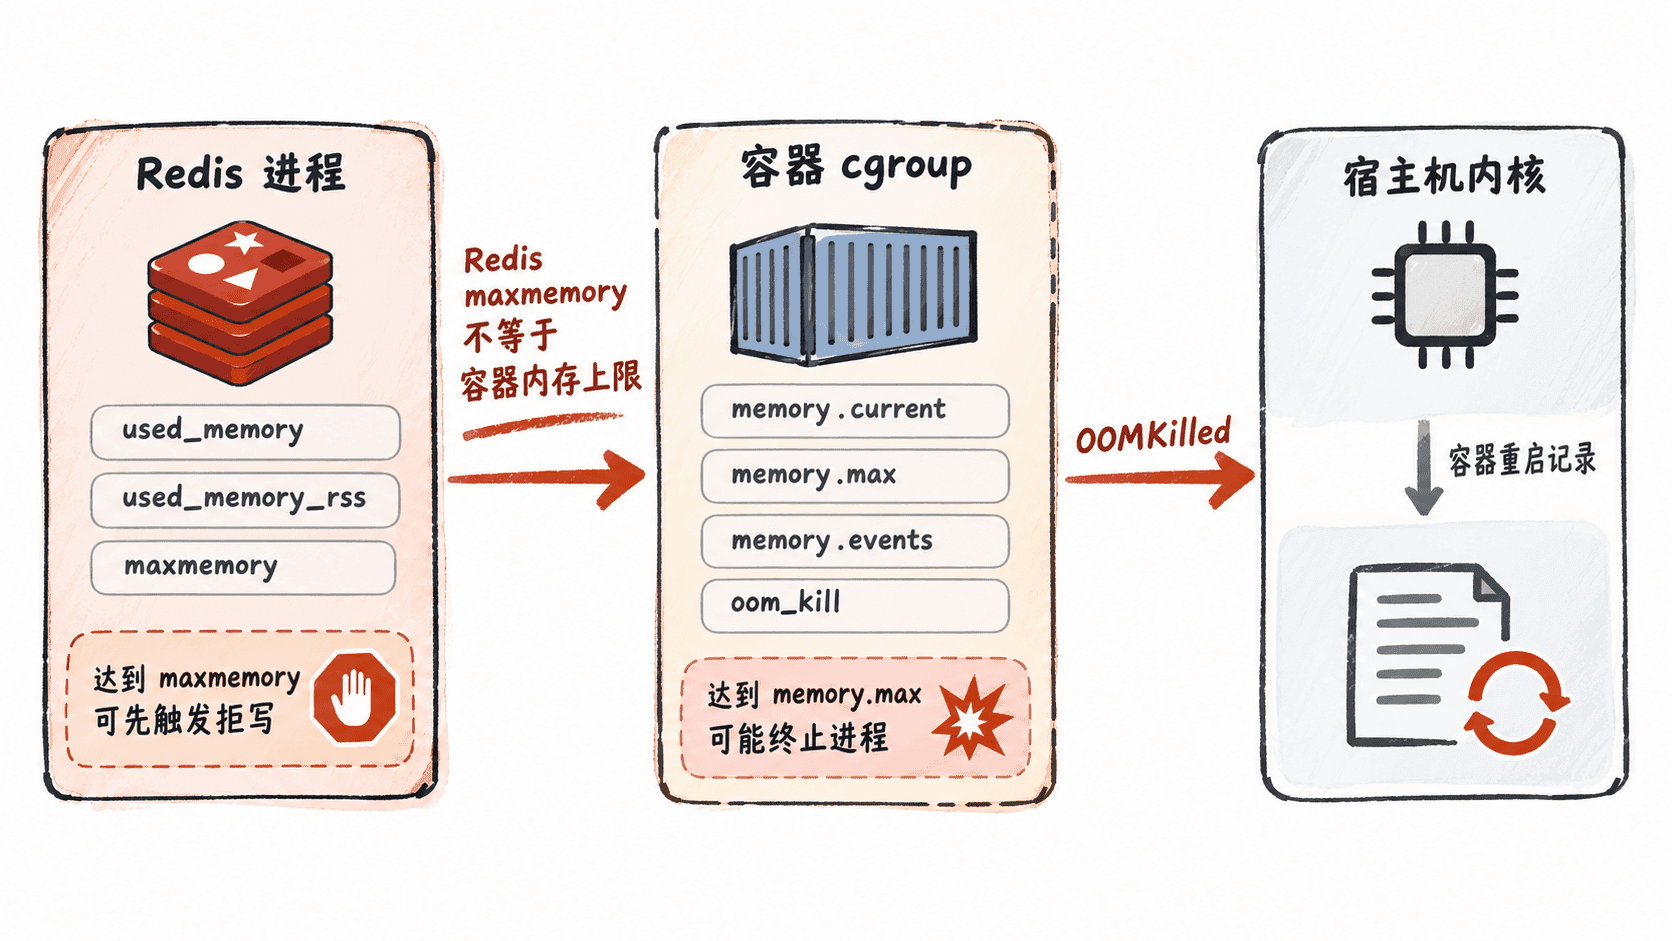
Redis 自己拒写通常会返回错误,但进程仍然存活;OOMKilled 则表示容器中的进程被操作系统内存控制机制终止。尤其要注意:Redis 的 maxmemory 并不等于容器的内存上限,因此把两者设置成相同值通常没有给额外开销留下空间。
先在 Docker 环境确认容器状态和内存限制:
docker inspect <CONTAINER_ID> --format 'OOMKilled={{.State.OOMKilled}} Status={{.State.Status}} RestartCount={{.RestartCount}} MemoryLimit={{.HostConfig.Memory}}'
docker stats --no-stream <CONTAINER_ID>
预期结果
OOMKilled=true Status=running RestartCount=<VALUE> MemoryLimit=<VALUE>
CONTAINER ID   NAME          CPU %   MEM USAGE / LIMIT   MEM %   NET I/O   BLOCK I/O   PIDS
<ID>           redis         <VALUE>  <VALUE> / <VALUE>  <VALUE>% <VALUE>    <VALUE>      <VALUE>
OOMKilled=true 是容器运行时记录的关键证据;docker stats 中的内存值用于观察当前或采样时刻的使用情况,不能代表已经发生过的历史峰值。因此,看到当前值很低并不能推翻“此前峰值导致 OOMKilled”的判断。
读取 cgroup 的真实限制
容器最终受 cgroup 内存控制。Linux cgroup v2 下,可以直接查看 memory.max、memory.current 和 memory.events。其中 memory.max 是硬限制,memory.current 是当前使用量,memory.events 中的 oom 与 oom_kill 能帮助确认是否发生过 OOM 事件。
printf 'memory.max='; cat /sys/fs/cgroup/memory.max
printf 'memory.current='; cat /sys/fs/cgroup/memory.current
printf 'memory.events\n'; cat /sys/fs/cgroup/memory.events
预期结果
memory.max=<VALUE>
memory.current=<VALUE>
memory.events
low <VALUE>
high <VALUE>
max <VALUE>
ome <VALUE>
ome_kill <VALUE>
ome_group_kill <VALUE>
memory.max 如果显示 max,表示当前 cgroup 没有设置该层面的硬内存上限;否则应把它与业务期望的容器限制比较。oom_kill 大于 0 是非常有价值的证据,但不同部署环境和 cgroup 版本的统计字段可能略有差异,因此还要结合容器运行时事件和 Redis 监控。
为什么“没到 maxmemory”也可能被杀
最常见的误判是看到 used_memory < maxmemory 就认为 Redis 不可能发生 OOMKilled。实际上,used_memory 描述的是 Redis 自身统计的内存,而容器限制约束的是进程及其相关内存的总体使用;复制缓冲、客户端输出缓冲、AOF 重写、内存碎片和其他进程内存都可能拉高 RSS。
因此应同时保存一组指标,而不是只看一个数字。重点关注 used_memory、used_memory_rss、mem_not_counted_for_evict,再与 cgroup 的 memory.current 和 memory.max 对照。若 Redis 数据内存并未越过 maxmemory,但 cgroup 已逼近上限,根因方向就应该从“淘汰 Key”切换到“进程总内存预算”。
用重启记录还原时间线
OOMKilled 通常是瞬时峰值问题,所以“现在恢复正常”不能说明没有异常。需要把容器重启时间与 Redis 采样、AOF 重写、复制变化或业务流量峰值对齐,确认 OOM 是否发生在某个短时间窗口。
docker inspect <CONTAINER_ID> --format 'StartedAt={{.State.StartedAt}} FinishedAt={{.State.FinishedAt}} OOMKilled={{.State.OOMKilled}} RestartCount={{.RestartCount}}'
docker events --since <TIME> --until <TIME> --filter container=<CONTAINER_ID> --filter event=restart
预期结果
StartedAt=<TIME> FinishedAt=<TIME> OOMKilled=true RestartCount=<VALUE>
<TIME> container restart <ID>
时间线要回答三个问题:容器何时达到峰值、Redis 在峰值附近用了多少内存、进程何时被终止并重启。若只能拿到重启后的当前数据,应明确标记“历史峰值缺失”,不能根据当前低水位推导峰值没有超限。
修复时不要只调高容器内存
先判断是哪一项占满预算,再决定治理方向。若 Redis 数据集本身持续增长,应处理 Key 生命周期、淘汰策略和数据结构;若 RSS 明显高于 used_memory,应检查碎片和额外缓冲;若业务流量只在特定峰值时触发,则要评估峰值容量和连接、复制、AOF 等资源预算。
更稳妥的配置关系是给 Redis 数据集预留明确余量,不要把 maxmemory 直接顶到容器硬限制。容器还需要容纳分配器开销、复制缓冲、客户端缓冲、后台操作以及其他不可忽略的进程内存。最终目标不是让两个上限相等,而是让 Redis 的数据预算与容器总预算保持可解释的安全距离。
当 OOMKilled=true、cgroup 的 oom_kill 有记录,并且历史时间线显示内存峰值接近或超过 memory.max 时,就可以把故障从“Redis 偶发重启”提升为“容器内存预算不足”的证据化结论;随后再用 Redis 内部指标确定到底是哪一类内存把预算吃掉。