
Redis 与缓存 / 系统课时
理解集合编码与内存拐点
理解集合编码与内存拐点
Redis 会根据数据规模和成员特征选择更紧凑或更通用的内部编码。真正需要关注的不是“用了哪种编码”本身,而是数据在什么条件下发生转换,以及转换后为什么内存占用可能突然上升。
学习目标
- 能用
OBJECT ENCODING判断常见集合当前采用的编码。 - 理解成员数量、成员长度和数据类型特征如何影响编码选择。
- 能定位编码拐点,并把它与单 Key 内存增长联系起来。
紧凑编码为什么能省内存
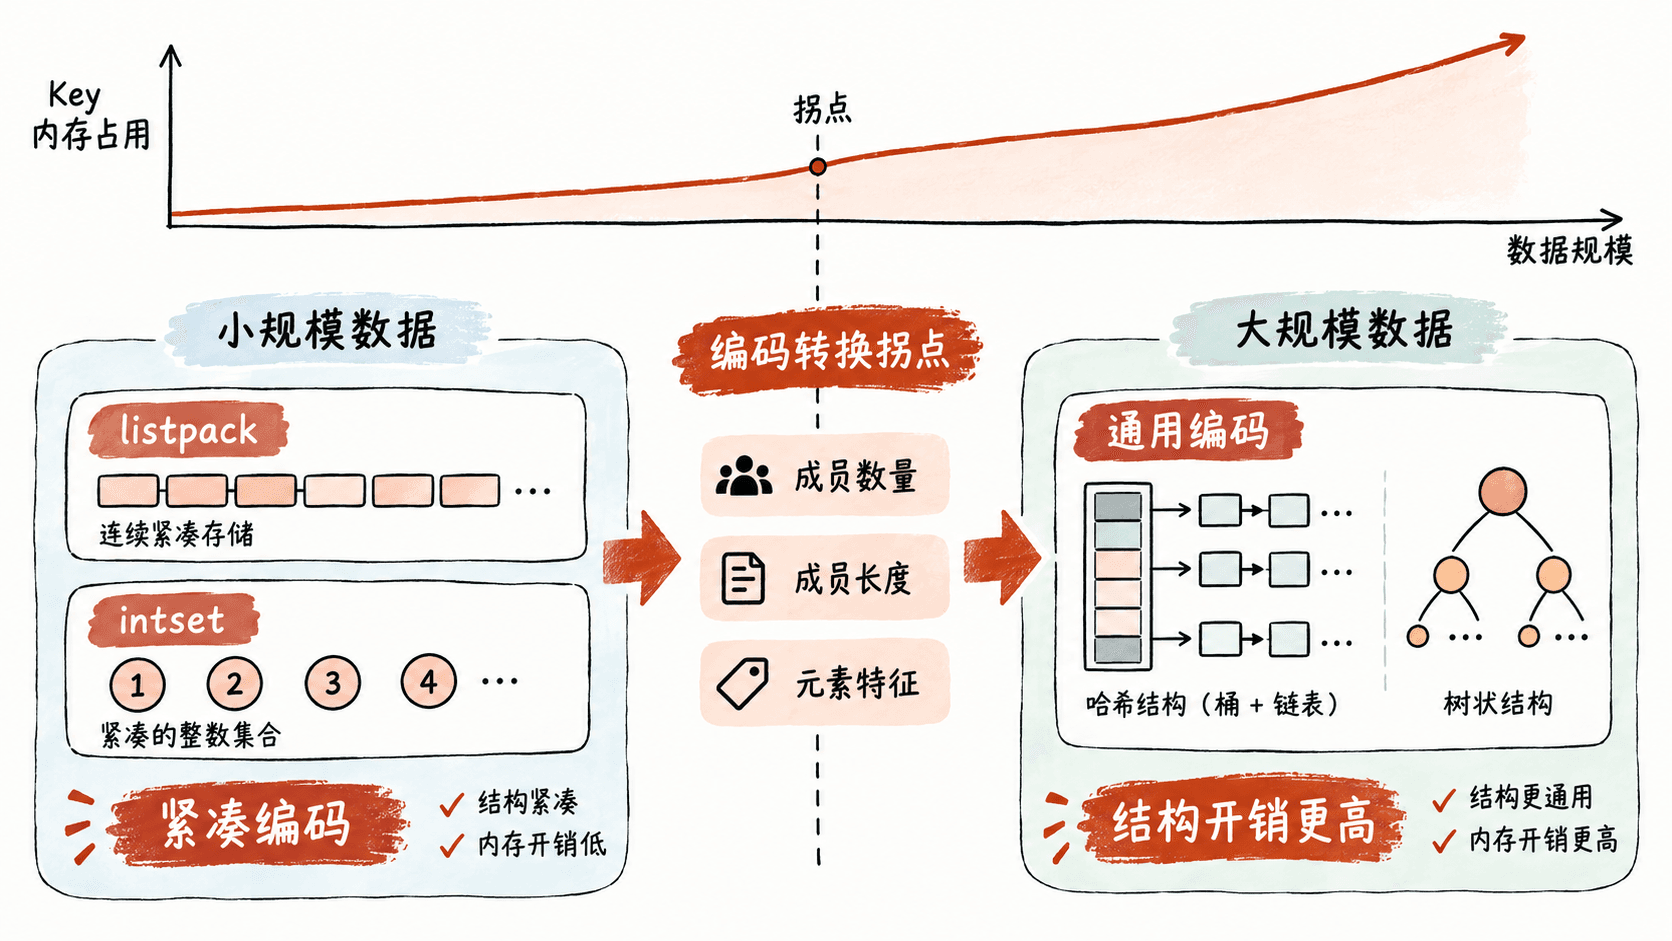
Redis 对小规模集合会优先采用紧凑表示,以减少哈希表、指针和对象元数据等额外开销。常见情况包括整数集合使用 intset,小型哈希、集合类有序集合可采用 listpack 等紧凑结构;列表则采用 quicklist 组织其内部节点。
当数据规模继续增长,或成员特征不再满足紧凑表示的条件时,Redis 会转向更通用的编码。通用结构通常更适合高效查找和更新,但每个元素承担的结构开销也可能更高,因此内存曲线可能出现明显拐点。
哪些特征会触发变化
首先看规模。同一种类型在元素较少时可能保持紧凑编码,超过相应条件后再切换。这里不要把某个阈值死记成所有 Redis 版本都相同的常数,因为具体限制会受到数据类型、Redis 版本和相关配置影响。
其次看成员特征。例如整数集合适用于可表示为整数的成员;当集合出现不满足该表示条件的成员时,就不能继续保持原有的整数型紧凑结构。哈希和有序集合的紧凑表示也会受到元素数量、字符串长度等条件影响。
因此,排查“大 Key 内存突然变多”时,不应只看元素个数,还要比较成员长度和成员类型是否发生了变化。
用命令观察编码和内存
可以直接对目标 Key 查看编码与近似内存占用。下面用一个小型集合演示观察方法,实际输出会因 Redis 版本和数据内容不同而变化。
redis-cli SADD demo:numbers 1 2 3 4
redis-cli OBJECT ENCODING demo:numbers
redis-cli MEMORY USAGE demo:numbers
预期输出
(integer) 4
intset
(integer) <VALUE>
这里的重点不是记住具体的 <VALUE>,而是确认当前 Key 的编码类型与内存占用。继续增加元素或改变成员特征后,再次执行同样的检查,就可以比较编码是否发生变化以及内存是否出现拐点。
从编码拐点定位内存问题
生产排查时,可以把一个集合拆成三个观察维度:元素数量、单元素大小、当前编码。若元素数量只增长了少量,但 MEMORY USAGE 明显上升,优先检查成员长度是否增大,以及编码是否已经从紧凑结构切换为通用结构。
例如,一个原本只保存短整数的集合后来混入较长字符串,即使元素数量几乎不变,也可能改变内部表示。反过来,只看到编码变化,也不能直接判定“编码转换就是 OOM 根因”,还要比较 Key 总数量、单元素大小以及增长速度。
真正有治理价值的是找到拐点前的数据形态:控制元素数量、限制成员长度、拆分超大集合,往往比事后压缩内存更可靠。编码是结果,数据模型才是决定拐点能否被控制的根因。