
Redis 与缓存 / 系统课时
读懂 INFO memory 指标
读懂 INFO memory 指标
排查 Redis 内存问题时,先把逻辑内存、数据集、进程 RSS 和碎片指标分开看。本课用一份 INFO memory 输出建立统一口径,避免把 RSS 偏高直接等同于键值数据过多,也避免仅看 used_memory 漏掉进程层面的压力。
学习目标
- 识别
used_memory、used_memory_dataset与used_memory_rss的统计边界 - 正确解读
mem_fragmentation_ratio,避免把所有 RSS 差额都归因于内存碎片 - 用一组命令采集并交叉验证 Redis 内存基线
先采集一份完整内存快照
连接目标实例后执行 INFO memory。生产环境最好同时记录采集时间、实例角色和当前业务负载,因为内存值会随着写入、过期、删除和后台任务持续变化。
redis-cli -h <IP> -p <PORT> INFO memory预期输出中应能看到如下核心字段,具体数值会随实例状态变化:
# Memory
used_memory:<VALUE>
used_memory_human:<VALUE>
used_memory_rss:<VALUE>
used_memory_rss_human:<VALUE>
used_memory_peak:<VALUE>
used_memory_overhead:<VALUE>
used_memory_startup:<VALUE>
used_memory_dataset:<VALUE>
used_memory_dataset_perc:<VALUE>
allocator_allocated:<VALUE>
allocator_active:<VALUE>
allocator_resident:<VALUE>
mem_fragmentation_ratio:<VALUE>
mem_fragmentation_bytes:<VALUE>
maxmemory:<VALUE>
maxmemory_policy:<VALUE>
*_human 字段适合人工阅读,做监控和计算时应使用原始字节值,避免单位转换和四舍五入影响判断。
区分逻辑内存、数据集与 RSS
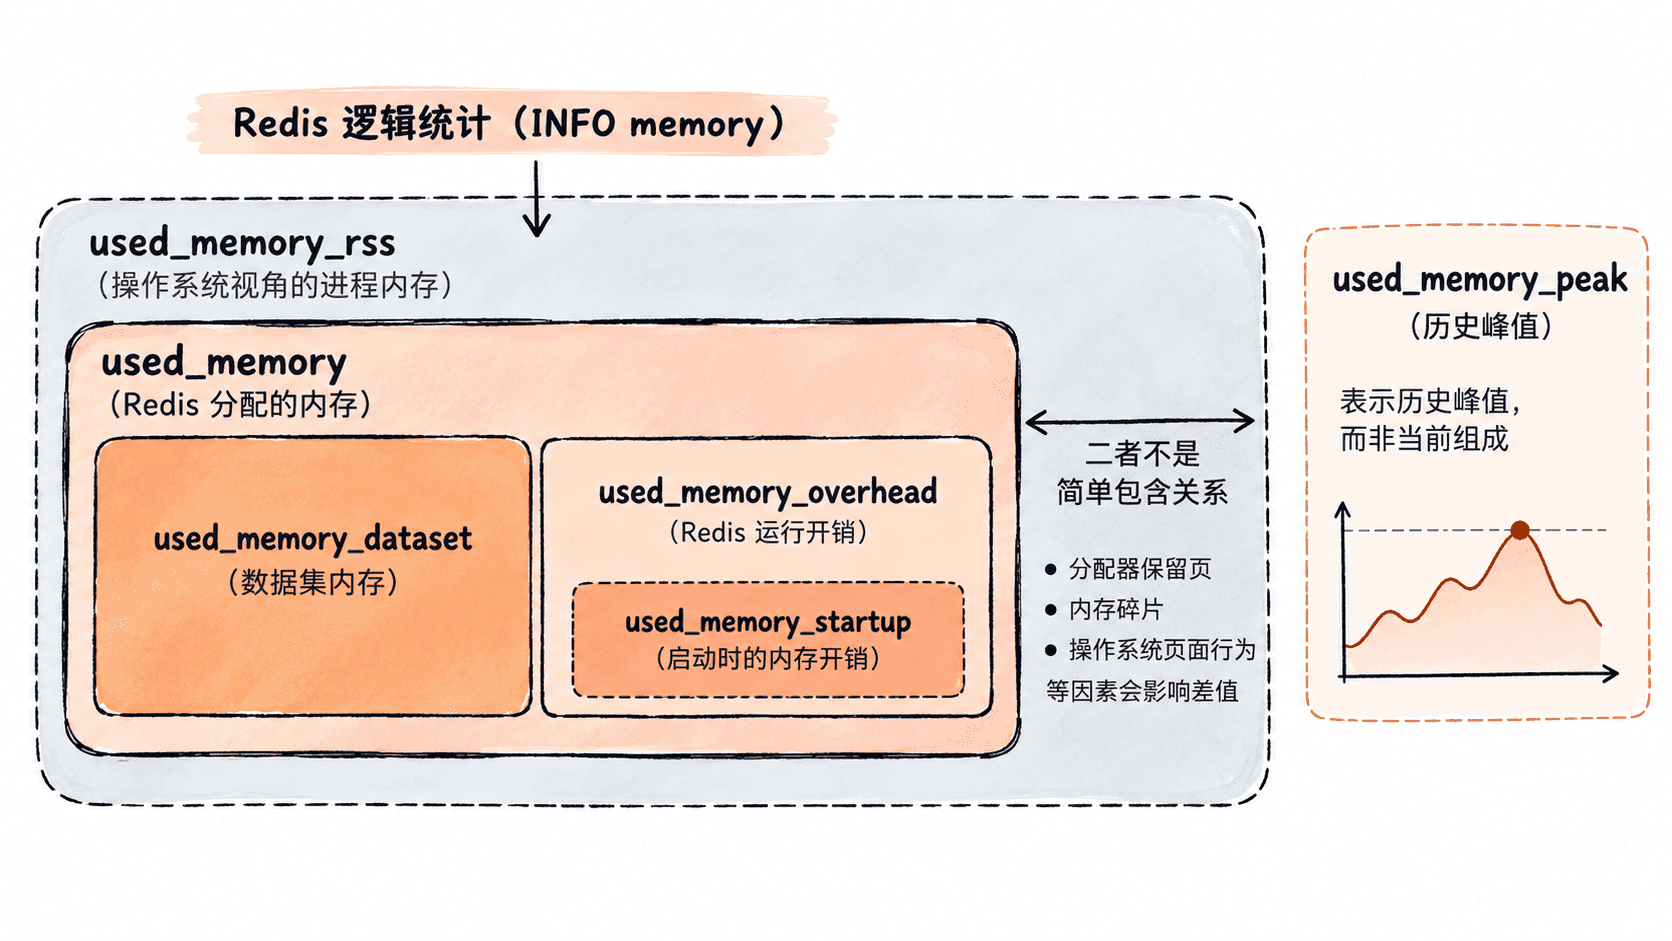
used_memory 是 Redis 通过内存分配器已经分配的内存总量,是分析 Redis 自身内存占用的主要入口。它不等于数据本身大小,因为其中还包含字典、对象元数据、客户端缓冲区、复制相关结构等开销。
used_memory_dataset 更接近真正承载用户数据的数据集部分,可以近似理解为 used_memory 扣除 Redis 统计到的内部开销后的剩余量。与它配套的 used_memory_overhead 用于观察非数据集开销是否异常增大,例如连接数暴涨、复制缓冲区扩大或内部结构占用增加。
used_memory_rss 则来自操作系统视角,表示 Redis 进程当前驻留在物理内存中的页面规模。它与 used_memory 不属于同一个口径,因此二者出现差值本身并不意味着异常。
不要把碎片率当成唯一诊断结论
mem_fragmentation_ratio 常用于快速观察 RSS 与 Redis 已分配内存之间的关系,通常可按 used_memory_rss / used_memory 理解。比值明显大于 1 时,说明进程 RSS 高于 Redis 统计的已分配内存,但造成差值的可能不仅是经典意义上的堆碎片,还包括分配器保留但未归还操作系统的页面等因素。
因此,看到碎片率升高后应继续查看 allocator_allocated、allocator_active 和 allocator_resident。它们分别帮助判断分配器已分配、活跃页以及驻留页之间的差距,把“Redis 逻辑内存”和“分配器/操作系统驻留”进一步拆开。
可以直接提取几个关键指标,形成一次轻量基线采样:
redis-cli -h <IP> -p <PORT> INFO memory | grep -E '^(used_memory:|used_memory_rss:|used_memory_dataset:|used_memory_overhead:|mem_fragmentation_ratio:|mem_fragmentation_bytes:|allocator_allocated:|allocator_active:|allocator_resident:)'预期输出:
used_memory:<VALUE>
used_memory_rss:<VALUE>
used_memory_overhead:<VALUE>
used_memory_dataset:<VALUE>
allocator_allocated:<VALUE>
allocator_active:<VALUE>
allocator_resident:<VALUE>
mem_fragmentation_ratio:<VALUE>
mem_fragmentation_bytes:<VALUE>
用指标组合判断问题方向
当 used_memory_dataset 持续增长,同时键数量或业务写入量也同步增长,首先调查数据规模、TTL 和大 Key;如果 used_memory_overhead 增长更明显,则应优先检查客户端、复制、缓冲区以及内部元数据开销。
如果 used_memory 已经下降,而 used_memory_rss 长时间保持高位,则问题更可能位于分配器保留、页面回收或碎片层面,而不是 Redis 仍保存着同等规模的数据。反过来,如果 used_memory 与 RSS 都同步上涨,就不应先把问题归咎于碎片,而要先找出 Redis 为什么持续申请更多内存。
used_memory_peak 适合回答“当前占用距离历史峰值有多远”,但它不会随着当前内存下降而同步降低,因此不能用它判断当前是否仍然承压。maxmemory 和 maxmemory_policy 则决定达到 Redis 配置内存上限后的行为,应作为后续 OOM 与淘汰分析的边界条件。
把这些指标按口径组合起来,INFO memory 才能从一串数字变成诊断入口:先确认 Redis 当前分配了多少,再拆出数据与开销,最后比较进程 RSS 和分配器驻留情况,而不是用单个“碎片率”替代完整判断。