
Redis 与缓存 / 系统课时
限制客户端缓冲区膨胀
限制客户端缓冲区膨胀
Redis 的客户端连接本身通常不是最大的内存来源,但某些客户端如果持续产生大量待发送数据,输出缓冲区会不断增长,最终把内存压力推向 OOM。本课重点解决如何从客户端连接中识别异常 omem,再用缓冲区上限、流量治理和连接管理把增长限制在可控范围内。
学习目标
- 能从
CLIENT LIST识别输出缓冲区异常增长的连接。 - 能正确配置客户端输出缓冲区的硬限制、软限制和持续时间。
- 能理解限制之后仍需从订阅流量、慢消费者和连接生命周期继续治理。
先找出谁在堆积待发送数据
Redis 向客户端发送响应时,如果客户端读取速度跟不上,尚未发送完成的数据会留在客户端输出缓冲区。连接越多、单个响应越大、客户端消费越慢,累计内存越容易放大。
CLIENT LIST 可以提供连接级线索,其中 omem 表示输出缓冲区相关内存,obl 和 oll 也可以辅助判断是否存在大量待发送数据。排查时不要只看连接数量,还要寻找“连接少但 omem 特别大”或“同类连接持续上涨”的异常模式。
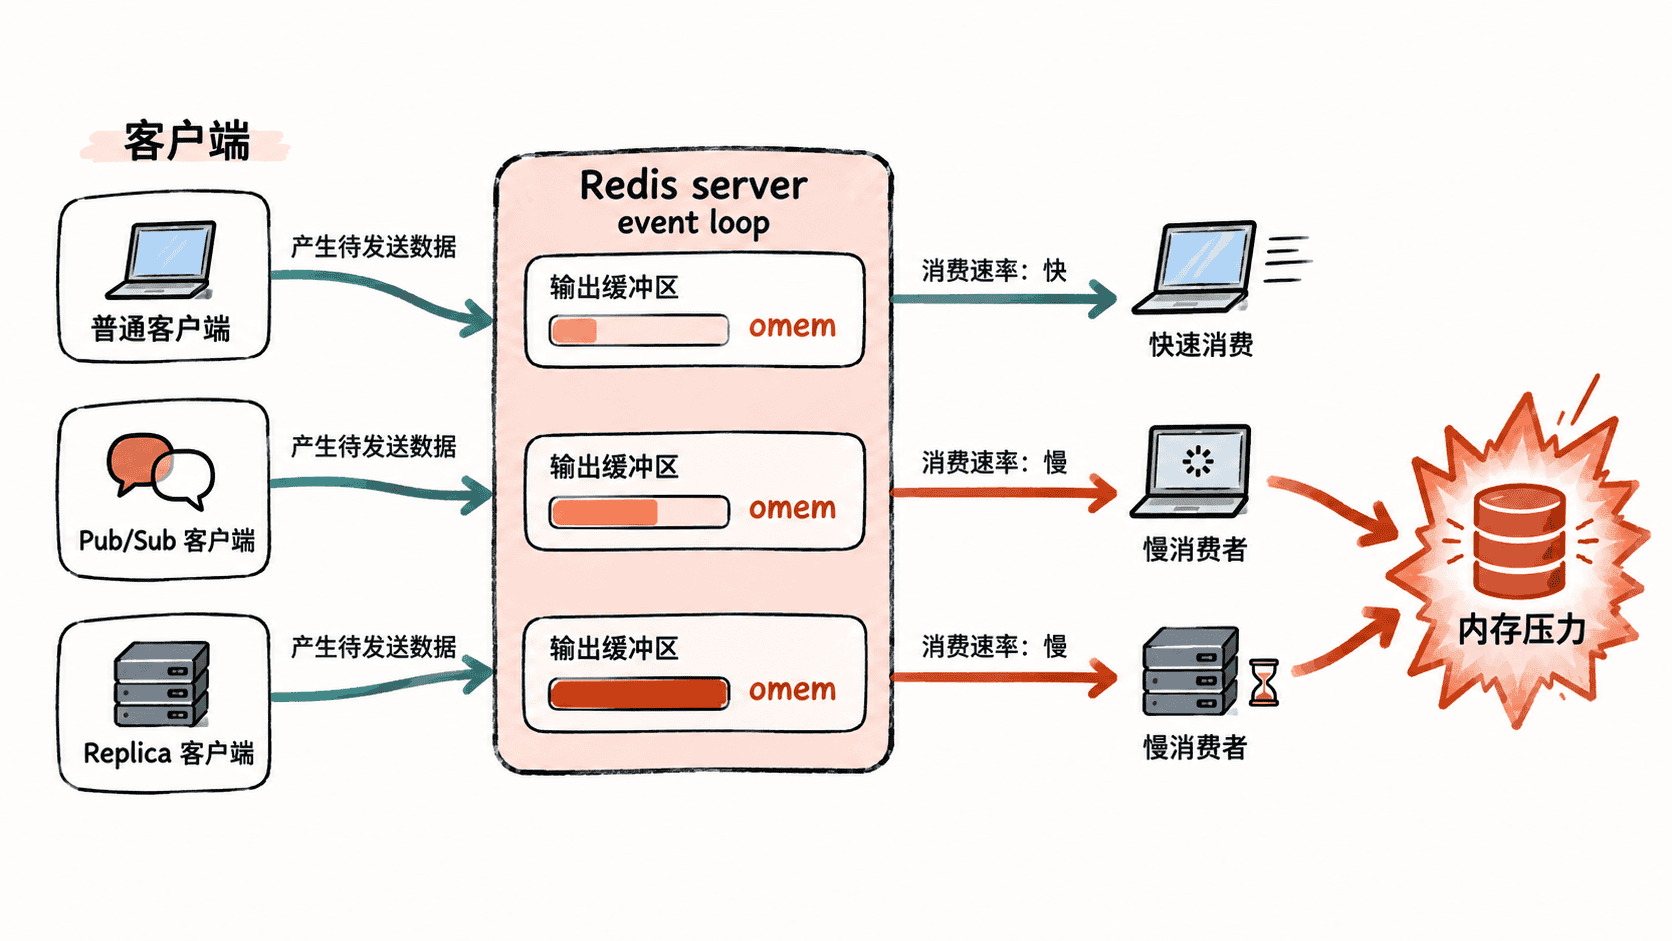
下面命令从连接列表中筛出输出缓冲区字段,先建立“谁在增长”的证据链,而不是直接修改全局配置。
redis-cli CLIENT LIST | awk -F' ' '{for(i=1;i<=NF;i++){if($i ~ /^id=/) id=$i; if($i ~ /^addr=/) addr=$i; if($i ~ /^name=/) name=$i; if($i ~ /^omem=/) omem=$i; if($i ~ /^obl=/) obl=$i; if($i ~ /^oll=/) oll=$i} print id, addr, name, omem, obl, oll}'预期结果
id=21 addr=10.0.0.12:52344 name=worker-a omem=1024 obl=0 oll=0
id=37 addr=10.0.0.18:51422 name=worker-b omem=52428800 obl=16384 oll=4
id=42 addr=10.0.0.19:51790 name=api omem=2048 obl=0 oll=0
示例中 worker-b 明显高于其他连接,因此下一步应围绕它继续查清客户端类型、订阅关系、请求模式和消费速度。这里的 omem 是连接级证据,不应直接当作“这一个客户端占用了 Redis 的全部内存”。
用硬限制和软限制建立安全阀
Redis 的 client-output-buffer-limit 按客户端类别设置限制。配置由三个核心部分组成:hard limit 达到后立即强制关闭连接;soft limit 表示进入持续超限观察;soft seconds 表示软限制连续超过多久后才关闭。
语法如下,单位支持 kb、mb 和 gb:
client-output-buffer-limit <class> <hard-limit> <soft-limit> <soft-seconds>例如,针对 Pub/Sub 慢消费者设置一个明确的保护边界,可以使用:
redis-cli CONFIG SET client-output-buffer-limit "pubsub 32mb 8mb 60"
redis-cli CONFIG GET client-output-buffer-limit
预期结果
OK
1) "client-output-buffer-limit"
2) "normal 0 0 0 slave 256mb 64mb 60 pubsub 32mb 8mb 60"
上面的完整返回值取决于当前 Redis 版本和原有配置;关键验证点是 pubsub 项已经变为 32mb 8mb 60。生产环境不应机械照抄数值,应结合单条消息大小、正常消费速度、允许的断连代价以及客户端重连行为确定。
限制后还要判断是哪类慢消费者
发现高 omem 后,至少要继续回答三个问题:这个连接属于哪类客户端、为什么产生这么多待发送数据、客户端为什么没有及时消费。
对于 Pub/Sub,常见原因是订阅端处理速度下降;对于 Replica,可能与复制链路受阻和数据发送积压有关;普通客户端则需要回到请求模型,检查是否存在巨大响应、批量返回过大或连接长时间不读取结果等问题。
因此治理顺序通常是“定位连接 → 确认客户端角色 → 判断输出数据为何积压 → 限制增长 → 修复消费速度”。只改 client-output-buffer-limit 而不处理慢消费者,故障往往只是从 OOM 变成频繁断连。
结合流量治理控制增长上限
除了 Redis 端限制,还应限制进入 Redis 的数据爆发速度。高峰期尤其要避免多个生产者同时向 Pub/Sub 大量广播,或者把超大结果集一次性返回给客户端。
工程上更可靠的做法是把“大消息”和“大批次”拆小:单次响应控制最大记录数,分页读取代替一次性拉取;广播业务设置发送速率或队列化;消费者异常时及时摘除或限流,而不是让 Redis 无限积压待发送数据。
需要特别注意的是,客户端断开后,Redis 的输出缓冲区会被释放,但如果新的慢连接持续出现,内存问题仍会重复发生。所以验收标准不能只是“当前 omem 降到正常”,而应该是异常连接消失后,在相同流量下不再持续积累。
最小验收闭环
一次完整的客户端缓冲区治理至少要有一个对比窗口:修改前记录异常连接的 omem、连接类型和业务流量;修改后观察这些指标是否回落,并确认 Redis 延迟、连接数和客户端重连没有出现新的异常。
最终目标不是把某个阈值调得越大越好,而是让 Redis 在遇到慢消费者时能够尽早形成明确边界:异常连接受限、内存增长有上限、业务能继续运行,随后再通过客户端消费能力和流量模型解决根因。