
Redis 与缓存 / 系统课时
设计可控的数据生命周期
设计可控的数据生命周期
Redis 内存治理不能只靠扩大 maxmemory。更稳定的做法是让数据从创建开始就有明确的存活规则:哪些 Key 自动过期,哪些可以主动删除,哪些需要按业务维度拆分,从源头避免永久 Key 和无界集合持续侵占容量。
学习目标
- 能根据业务语义选择 TTL、主动删除或拆分方案。
- 能识别永久 Key 与无界集合为什么会形成持续内存压力。
- 能用 Redis 命令验证过期和删除行为,并评估拆分后的容量边界。
先定义数据的生命周期
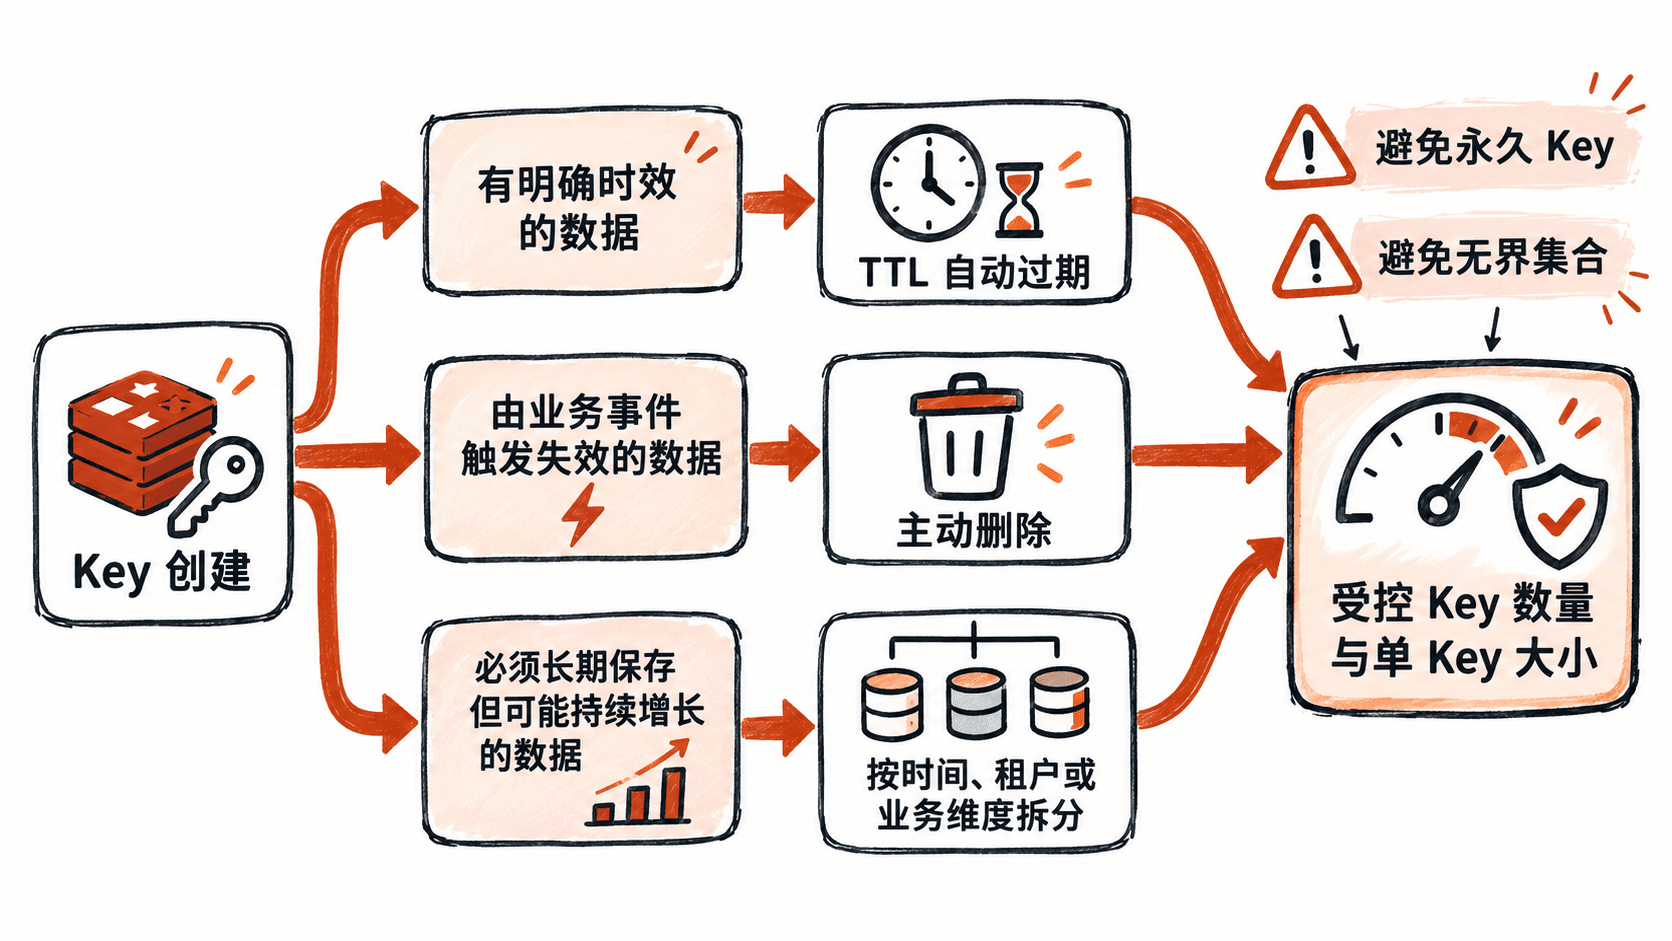
一个 Key 的生命周期至少要回答三个问题:数据多久失效、什么事件可以提前失效、单个 Key 最多允许承载多少数据。
缓存、验证码、会话等天然存在有效期的数据,应优先使用 TTL。业务上已经确定失效的对象,则应在事件发生后主动删除。对于必须长期保存的数据,不能因为“没有过期时间”就放任集合无限增长,而应通过时间分桶、租户拆分、业务维度拆分等方式控制单 Key 的增长上限。
TTL 适合解决什么问题
TTL 最适合“过了时间就没有业务价值”的数据。创建数据时同时设置过期时间,可以避免应用因为忘记清理而留下大量永久 Key。
例如,临时验证码可以直接设置较短 TTL;缓存结果也可以根据业务容忍度选择过期时间。TTL 是生命周期的一部分,而不是故障发生后的补救措施,因此应尽量在写入路径中一次完成。
redis-cli SET cache:user:42 "cached-value" EX 300
redis-cli TTL cache:user:42
redis-cli GET cache:user:42
预期输出
OK
(integer) <VALUE>
"cached-value"
TTL 返回值会随执行时间变化,因此用 <VALUE> 表示当前剩余秒数;实际运行时只要它为正数,就说明该 Key 已设置有效期。到期后查询该 Key 会得到空结果。
主动删除与异步删除
对于已经确认失效的数据,可以主动删除。DEL 会同步执行删除操作,而 UNLINK 会将解除 Key 引用与实际释放内存分离,在删除大 Key 时通常更适合降低删除操作本身的延迟风险。
redis-cli SET session:user:42 "session-data"
redis-cli EXISTS session:user:42
redis-cli UNLINK session:user:42
redis-cli EXISTS session:user:42
预期输出
OK
(integer) 1
(integer) 1
(integer) 0
这里第三行的返回值表示命令删除并解除引用了一个 Key;最后一行验证该 Key 已不存在。实际是否选择 DEL 或 UNLINK,应结合 Key 大小和延迟要求判断,而不是机械地全部替换。
拆分无界集合
永久生命周期并不一定意味着危险,真正危险的是永久且无界增长。例如单个用户、单个租户或单个业务对象持续向一个 List、Set 或 Hash 追加数据,最终会形成难以控制的大 Key。
拆分的核心是把一个无限增长对象变成多个有边界的对象。例如按天生成 events:<时间桶>,按租户生成 tenant:<ID>:events,或者同时限制每个桶的最大元素数量。这样做后,TTL 可以负责回收旧桶,应用则负责控制当前桶的增长速度。
拆分并不会自动降低总数据量,它的价值在于把单 Key 风险转换成可度量、可淘汰、可分批删除的容量单元。因此设计时要同时考虑读写路径、过期策略和热点分布。
用容量边界检查方案
在设计生命周期时,可以给每类数据建立简单的约束:Key 是否必须有 TTL、单 Key 最大元素数、单元素最大长度,以及超过阈值后的处理动作。上线前按真实数据分布验证,而不是只测试空数据或极小集合。
一个可落地的判断顺序是:先判断数据是否天然有失效时间;没有的话,再判断是否存在明确的业务删除事件;两者都没有时,继续检查单 Key 是否可能无限增长。只要答案是“可能”,就需要拆分或增加硬性容量边界。
最终目标不是让 Redis 中永远没有大 Key,而是让数据的存活时间、删除责任和单 Key 容量都能被系统明确控制。这样内存增长才会从不可预测的累积问题,变成可以通过指标和规则提前治理的工程问题。