
Redis 与缓存 / 系统课时
处理高内存碎片实例
处理高内存碎片实例
这篇解决的是 Redis 已经没有继续增长太多数据,但进程 RSS 仍明显高于实际数据内存的问题。你将学会区分逻辑内存与分配器碎片,并根据容量余量和业务窗口选择主动碎片整理、迁移或重启。
学习目标
- 能用
INFO memory判断碎片是否已经成为主要 RSS 来源 - 能理解主动碎片整理与数据迁移、进程重启的适用边界
- 能在生产环境用容量水位和业务窗口控制回收风险
先确认是碎片,不是数据本身
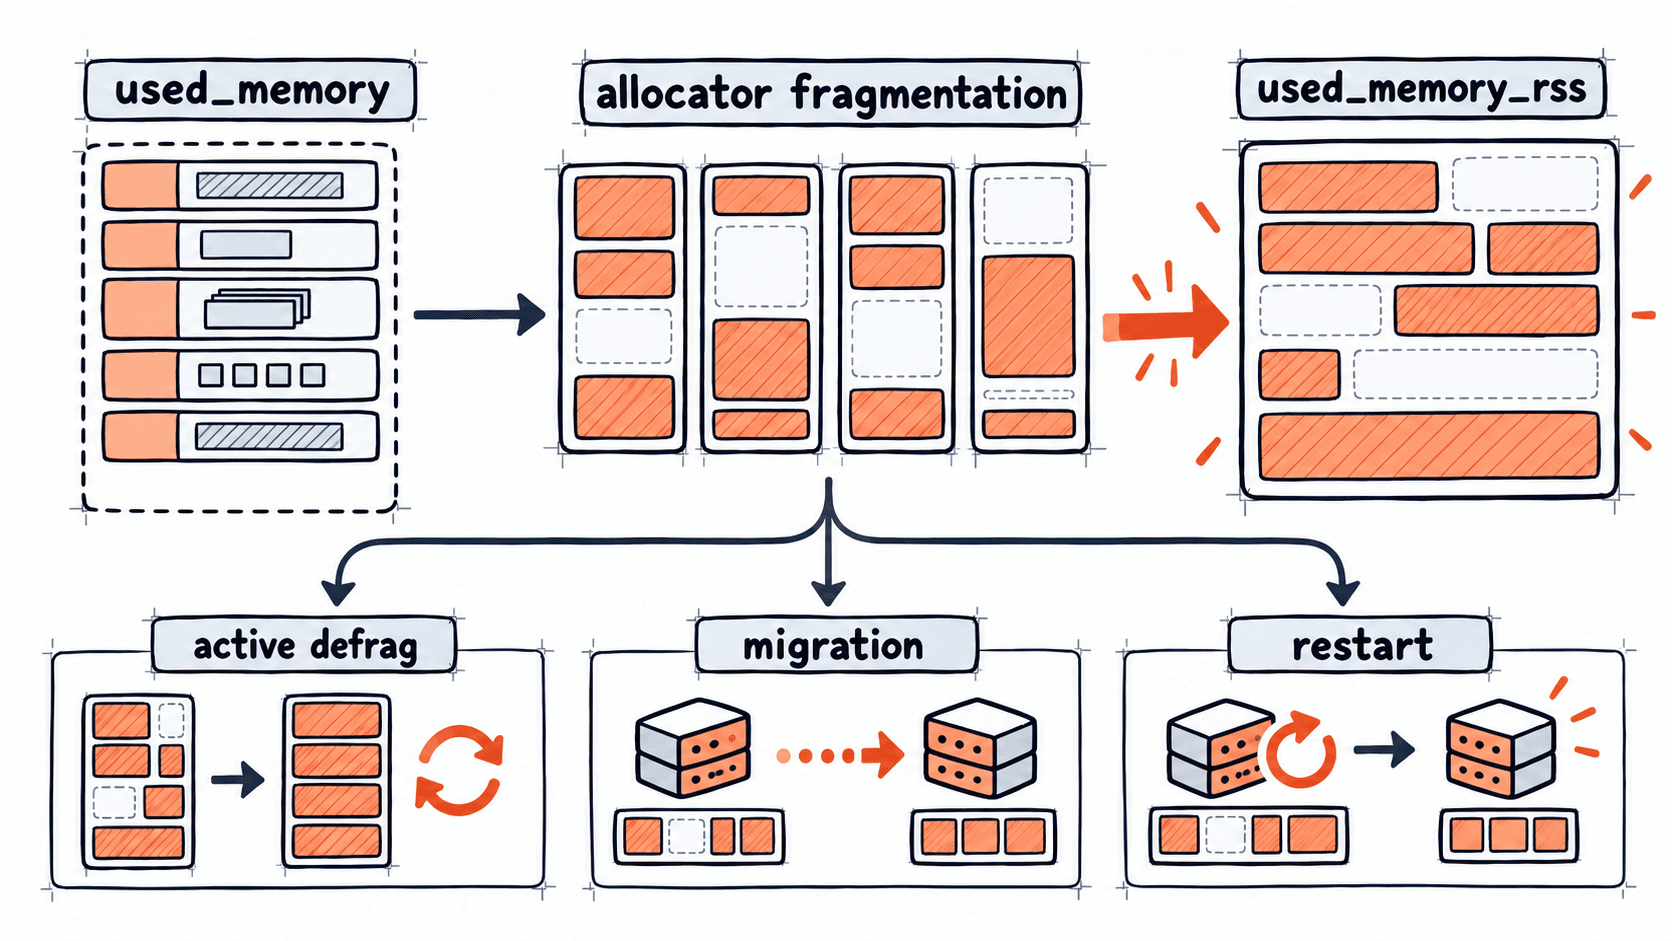
Redis 中最重要的两个观察值是 used_memory 与 used_memory_rss。前者更接近 Redis 管理的内存,后者反映操作系统看到的进程常驻内存。当 RSS 明显高于 used_memory 时,才有必要进一步判断是否存在分配器碎片。
mem_fragmentation_ratio 可以作为快速信号,但不能把它当成唯一结论。RSS 还可能受到 Lua、模块、客户端输出缓冲区、复制缓冲区以及其他不完全计入 Redis 数据内存的部分影响,因此必须结合 used_memory_peak、mem_not_counted_for_evict 等字段一起看。
用指标决定是否值得处理
先在实例上采集一组基线,而不是看到 RSS 偏高就立即重启。下面命令读取最关键的内存字段;其中实际数值会随实例负载变化。
redis-cli -h <IP> -p <PORT> INFO memory | grep -E '^(used_memory:|used_memory_rss:|used_memory_peak:|mem_fragmentation_ratio:|mem_not_counted_for_evict:)'预期输出
used_memory:524288000
used_memory_rss:838860800
used_memory_peak:612368384
mem_fragmentation_ratio:1.60
mem_not_counted_for_evict:50331648
这个结果表示 RSS 约 800 MiB,而 Redis 管理的内存约 500 MiB,确实值得进一步检查。但 1.60 并不意味着其中全部都是碎片:还要结合实例的 allocator、模块和非驱逐内存判断。
更重要的是看绝对值。一个只有 1 GiB 内存、RSS 多出 100 MiB 的实例,和一个 64 GiB 实例、比数据内存多出数 GiB 的实例,治理优先级完全不同。生产判断应优先回答“额外 RSS 是否已经侵蚀安全水位”。
先试在线主动碎片整理
Redis 支持主动内存碎片整理时,会在后台搬移部分对象,让分配器有机会合并空闲空间并把不用的页返还给系统。它适合业务仍在运行、没有立即需要迁移或重启、同时实例还有一定余量的场景。
可以先检查当前配置,并在确认版本和运维规范允许后启用它:
redis-cli -h <IP> -p <PORT> CONFIG GET activedefrag
redis-cli -h <IP> -p <PORT> CONFIG SET activedefrag yes
redis-cli -h <IP> -p <PORT> CONFIG GET activedefrag
预期输出
1) "activedefrag"
2) "no"
OK
1) "activedefrag"
2) "yes"
主动碎片整理不是“立即把 RSS 降到最低”的开关。它需要消耗 CPU,并且回收速度受碎片程度、对象布局和当前负载影响。实例已经接近内存上限时,更不应该为了追求碎片率而把 CPU 和延迟风险进一步放大。
生产上应同时观察延迟、CPU、RSS 与业务请求量。若 RSS 没有明显下降,或者整理带来的 CPU 成本已经影响服务,就应停止把它当作唯一方案。
什么时候应该迁移或重启
迁移适合长期需要继续承载业务、但当前实例碎片严重且希望换到更健康地址空间的情况。迁移后,新实例从新的内存布局开始工作,旧实例可以在确认切换完成后退出,从而一次性释放旧进程 RSS。
重启则更直接:进程退出后操作系统回收全部地址空间,再从持久化数据或其他恢复机制重新建立实例。它的代价是必须承担重建时间、连接切换、数据恢复和业务窗口等风险,因此不能因为碎片率偏高就随意执行。
可以把选择逻辑压缩成三个问题:有没有容量余量、能不能接受在线 CPU 成本、有没有可控的切换或重启窗口。余量充足且希望在线处理,优先评估主动碎片整理;碎片长期严重且有迁移能力,优先迁移;已经准备维护窗口且需要彻底释放 RSS,才考虑重启。
回收后的验证
治理完成后不要只看 mem_fragmentation_ratio。至少再次检查 used_memory、used_memory_rss 和业务延迟,并与治理前基线比较。
redis-cli -h <IP> -p <PORT> INFO memory | grep -E '^(used_memory:|used_memory_rss:|mem_fragmentation_ratio:)'预期输出
used_memory:521011200
used_memory_rss:604110848
mem_fragmentation_ratio:1.16
这个结果说明 RSS 与数据内存的差距已经明显收窄,但是否真正安全仍要结合实例配置的 maxmemory、节点可用物理内存以及同机其他进程判断。高碎片治理的目标不是追求某个漂亮的比值,而是重新建立足够的 RSS 安全余量。
当实例长期表现为“数据内存稳定、RSS 持续偏高”时,应把它纳入周期性容量治理,而不是等到 OOM 前才处理。在线整理、迁移和重启分别对应不同的风险预算,真正稳妥的选择取决于内存余量与业务窗口,而不是某个单独指标。