
Redis 与缓存 / 系统课时
排查系统 OOM Killer
排查系统 OOM Killer
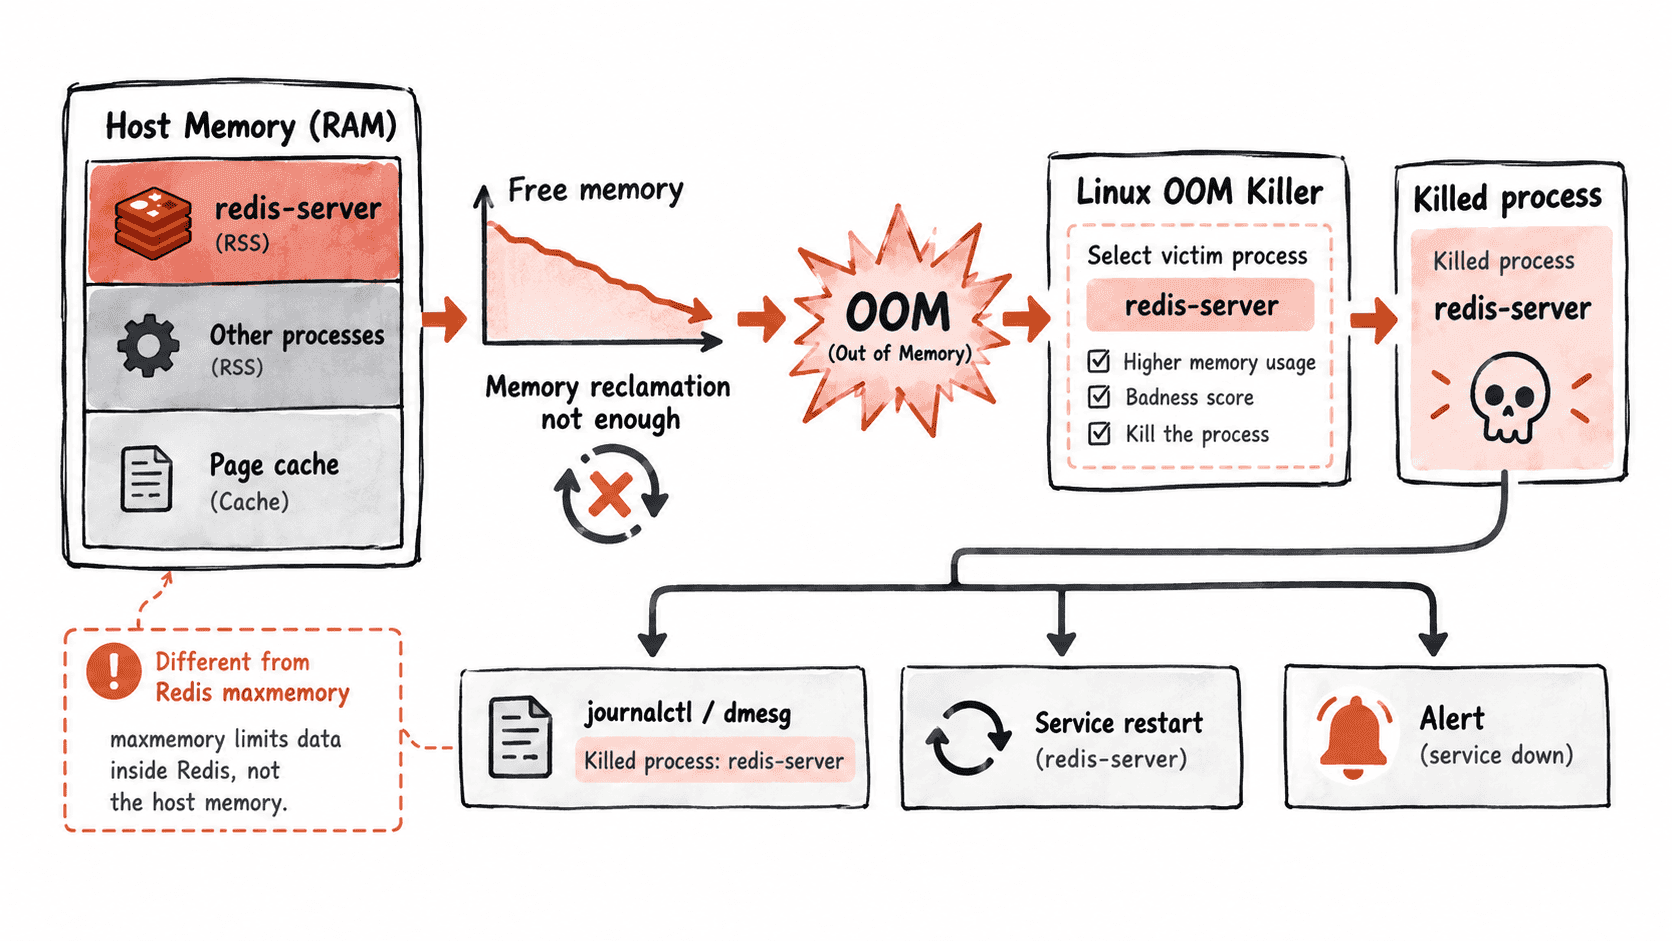
本课解决一个容易被误判的问题:Redis 进程突然消失,究竟是 Redis 自身达到 maxmemory,还是 Linux 在宿主机内存压力下主动杀掉了进程。最终你能用系统证据确认杀进程原因,并把 Redis 内存、主机内存和其他进程竞争放到同一条判断链路中。
学习目标
- 区分 Redis OOM 与 Linux OOM Killer 的触发边界
- 使用内核日志、进程状态和容器信息定位被杀原因
- 根据证据判断是整体内存压力、过量提交还是其他进程竞争
先确认是不是 Redis 自身拒绝分配
Redis 的 maxmemory 是 Redis 内部的数据集内存控制机制;达到上限时,Redis 会根据配置执行淘汰或拒绝写入,它不会因此主动让 Linux 把 Redis 进程杀掉。排查进程突然退出时,第一步应先确认应用层现象,再查看操作系统是否记录了杀进程事件。
常见信号包括 Redis 客户端突然收到连接断开、服务管理器显示进程退出,以及主机内核日志出现 Out of memory、Killed process 等记录。若 Redis 日志看起来像是“正常停止”而系统同时存在 OOM 记录,应优先相信内核侧证据。
从内核日志确认 OOM Killer
Linux 的 OOM Killer 会在内存无法满足分配且回收不足时选择进程终止。不同发行版日志位置可能不同,因此先从 journalctl 查询,再根据需要检查内核消息。
sudo journalctl -k -b | grep -Ei 'out of memory|oom-killer|killed process|memory cgroup out of memory'
sudo dmesg -T | grep -Ei 'out of memory|oom-killer|killed process' 2>/dev/null | tail -n 50
预期结果
Sep 06 10:31:12 <HOST> kernel: Out of memory: Killed process <PID> (redis-server) total-vm:... anon-rss:...
Sep 06 10:31:12 <HOST> kernel: oom_reaper: reaped process <PID> (redis-server)
看到 Killed process ... (redis-server) 基本可以确认 Redis 是被内核选择为受害进程;total-vm、anon-rss 等字段还能帮助判断它当时的内存体量。没有这类记录时,不要仅凭 Redis 重启就下结论为 OOM Killer,可能还存在服务管理器重启、崩溃或人为停止等原因。
查看 Redis 当时到底占了多少内存
确认内核记录后,再看 Redis 进程的实际内存,而不是只看 used_memory。Redis 自身指标描述的是 Redis 管理的数据与内部内存;Linux 还需要考虑进程常驻内存、共享页、线程栈、分配器碎片以及其他宿主机开销。
PID=<PID>
ps -o pid,ppid,rss,vsz,%mem,etime,cmd -p "$PID"
awk '/VmRSS|VmSize|VmPeak|VmHWM/ {print}' "/proc/$PID/status"
预期结果
  PID  PPID    RSS     VSZ %MEM     ELAPSED CMD
  <PID>    1  7340032  10485760 45.2  01:24:17 redis-server *:<PORT>
VmSize:   10485760 kB
VmRSS:     7340032 kB
VmPeak:   11010048 kB
VmHWM:     8388608 kB
这里的 VmRSS 更接近当前驻留物理内存,VmHWM 可以提供历史高水位线。两者都不能单独证明“为什么被杀”,但可以帮助你把 OOM 日志中的进程内存数字与运行时状态对应起来。
判断宿主机还是其他进程造成压力
系统 OOM 并不意味着 Redis 本身是唯一问题。要判断根因,需要把 Redis、其他进程、页缓存以及容器或 cgroup 限制放在同一时间点观察。尤其在容器环境中,宿主机还有内存,但 Redis 所在 cgroup 可能已经达到自己的限制。
free -h
printf '\n--- Top memory consumers ---\n'
ps -eo pid,comm,rss,%mem --sort=-rss | head -n 12
printf '\n--- Redis memory ---\n'
redis-cli INFO memory | grep -E 'used_memory:|used_memory_rss:|used_memory_peak:|maxmemory:'
预期结果
               total        used        free      shared  buff/cache   available
Mem:             16Gi        15Gi       120Mi        24Mi        900Mi       420Mi

--- Top memory consumers ---
  <PID> redis-server   7340032 45.2
  <PID> java            4194304 25.8
  <PID> nginx            524288  3.2

--- Redis memory ---
used_memory:6291456
used_memory_rss:7340032
used_memory_peak:8388608
maxmemory:0
如果 Redis 的 used_memory_rss 并未异常增长,但同时出现 Java、编译任务或其他批处理进程占满内存,就应把“其他进程竞争”列为主要嫌疑。若宿主机可用内存充足,却存在 memory cgroup out of memory,则应转向检查容器或服务的内存上限,而不是继续扩大宿主机容量。
如何形成可复核的根因结论
排查完成后,结论至少应能回答三个问题:谁被杀、为什么触发 OOM、当时谁在占用内存。例如“Redis 因 Linux OOM Killer 被杀”只完成了第一层,完整结论还应带上内核记录时间、Redis 的 RSS、高水位和同时间窗口内的竞争进程或 cgroup 限制。
不要把 maxmemory 达标、used_memory 很高与 OOM Killer 直接画等号。前者是 Redis 内部内存治理,后者是操作系统或 cgroup 层面的资源耗尽;只有把两个层级的证据对齐,才能决定后续是调整数据容量、降低进程竞争,还是治理宿主机与容器内存上限。