
Redis 与缓存 / 系统课时
建立内存变更门禁
建立内存变更门禁
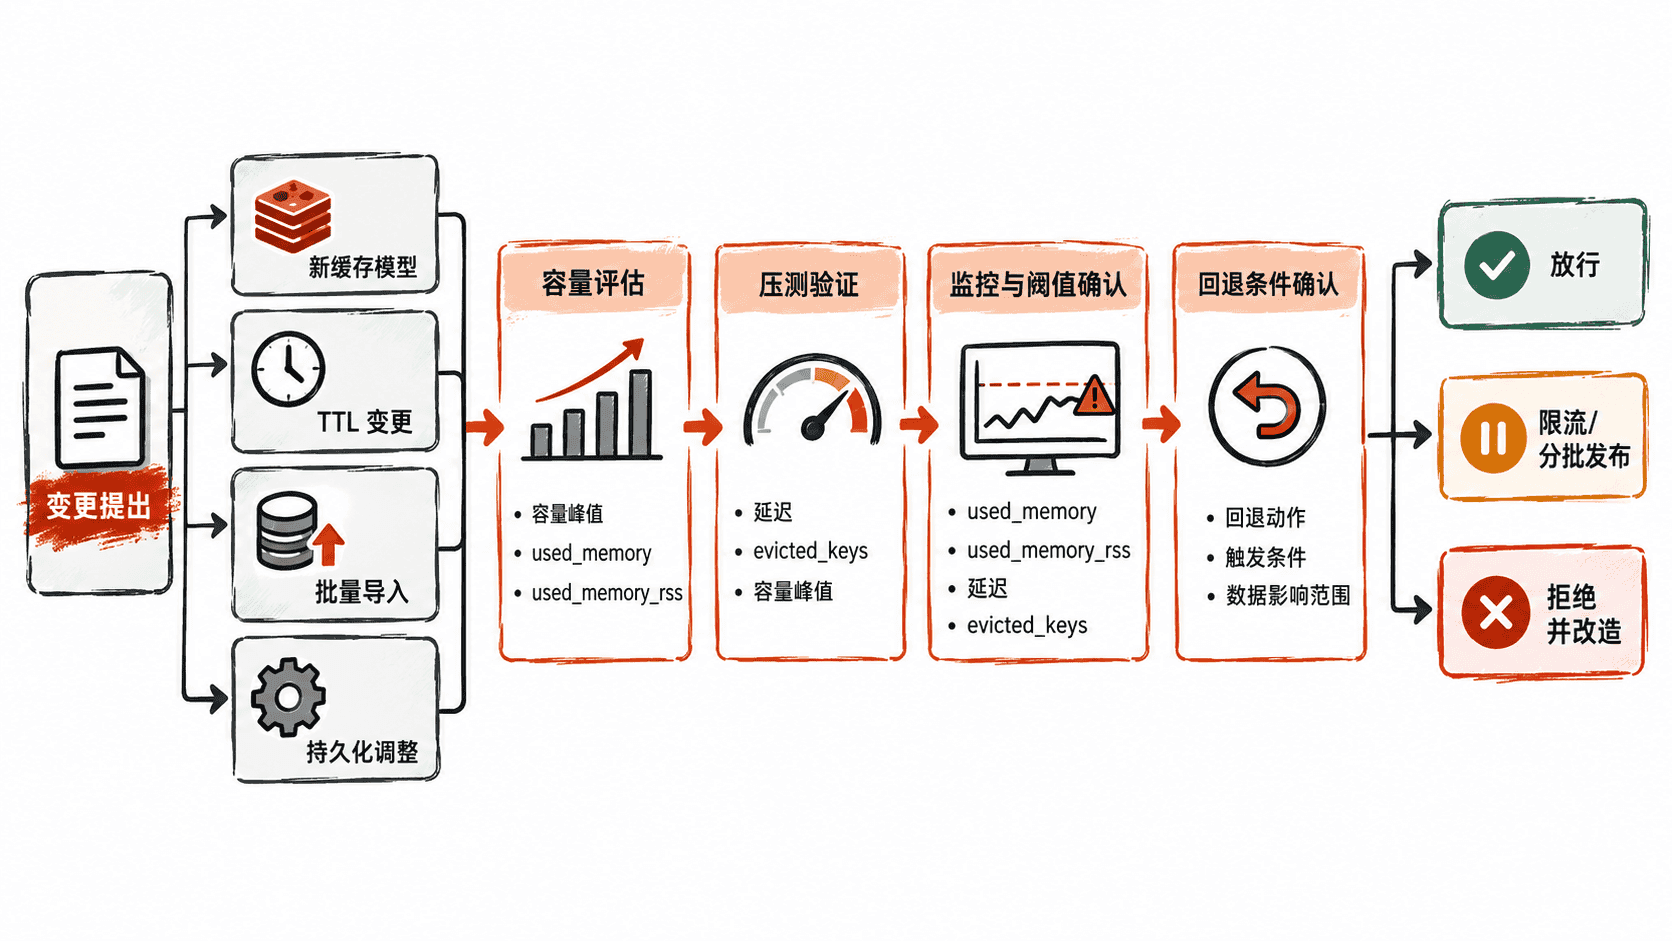
这篇解决“缓存改了以后为什么突然爆内存”的治理问题:把新缓存模型、TTL 变化、批量导入和持久化调整统一纳入容量评估、压测、发布门禁与回退流程,让内存变化在生产前就有可验证的安全边界。
学习目标
- 能为不同类型的 Redis 内存变更定义最小评估项
- 能用基线、压测和水位阈值判断变更是否放行
- 能为高风险变更准备可执行的回退条件与动作
先把变更分成四类
不是所有配置或数据模型变化都需要同样的审批深度。新缓存模型主要评估单 Key 大小、Key 数和结构开销;TTL 变化重点看存活时间、峰值 Key 数与淘汰压力;批量导入关注瞬时增长和并发写入;持久化调整则需要额外考虑 fork 与 Copy-on-Write 带来的内存峰值。
变更前必须建立容量基线
门禁至少要回答三个问题:当前用了多少内存、这次变化会增加多少、峰值时距离安全上限还有多少空间。不要只看 used_memory,还要同时关注 RSS,因为数据集增长、分配器保留空间以及后台操作可能让进程实际占用更高。
对于可估算的数据模型,可以先记录当前 Key 数 、平均单 Key 成本 ,再估算变更后的峰值:。这里的 表示其他固定或额外开销,实际容量评估应使用压测结果校正。
压测要验证峰值而不是平均值
门禁压测应尽量复现生产增长方式,包括真实 Key 分布、TTL 分布、批量大小和写入并发。重点记录增长期间的 used_memory、used_memory_rss、延迟、Key 数以及淘汰或拒写情况。
redis-cli INFO memory | grep -E 'used_memory:|used_memory_rss:|maxmemory:|mem_fragmentation_ratio:'
redis-cli INFO stats | grep -E 'evicted_keys:|rejected_connections:'
redis-cli DBSIZE
预期结果
used_memory:<VALUE>
used_memory_rss:<VALUE>
maxmemory:<VALUE>
mem_fragmentation_ratio:<VALUE>
evicted_keys:<VALUE>
rejected_connections:<VALUE>
<VALUE>
实际输出中的数值会随实例状态变化。门禁真正关心的是变更前后峰值、增长速度以及是否触碰既定水位,而不是某一个固定数值。
放行、分批与拒绝要有明确条件
建议至少设置三档结论。容量余量充足、压测峰值稳定且关键延迟指标无明显恶化时可直接放行;峰值接近高水位但仍可控制时,应采用小批量、分阶段或限速发布;一旦压测已经触发拒写、持续淘汰、延迟异常或接近容器内存上限,就不应把“线上继续观察”当成门禁,而应先改造模型或降低增长速度。
门禁记录不要只写“测试通过”,而要保存基线、变更前后峰值、压测时长、样本规模、阈值和负责人。这样下一次复用同类模型时,可以直接比较历史数据,避免每次从零估算。
回退条件必须能在运行时执行
高风险变更至少提前定义一项自动或人工触发条件,例如内存连续超过高水位、RSS 与 used_memory 差距异常扩大、延迟超过业务阈值,或出现持续拒写。回退动作应对应具体操作,例如停止继续导入、恢复旧 TTL、关闭新增写入路径或切回旧数据模型。
redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
redis-cli INFO memory | grep -E 'used_memory:|used_memory_rss:'
预期结果
1) "maxmemory"
2) "<VALUE>"
1) "maxmemory-policy"
2) "<VALUE>"
used_memory:<VALUE>
used_memory_rss:<VALUE>
这里的命令用于确认当前实例边界,不能替代变更本身的回退设计。尤其不要为了给新模型让出空间,临时扩大 maxmemory 却没有同步评估容器或主机可用内存。
真正可靠的内存门禁,不是审批表上多一项“已测试”,而是把容量预测、峰值验证、监控阈值和回退动作串成一条可执行链路。任何无法说明“最坏会涨到哪里、超过后怎么停、怎么退”的内存变更,都不应直接进入生产。