
Redis 与缓存 / 系统课时
演练系统级 OOM 故障
演练系统级 OOM 故障
本课在受控环境中制造系统级内存压力,练习区分 Redis 自身的 maxmemory 拒写与操作系统或容器层面的 OOM。核心判断不是“Redis 内存高不高”,而是确认到底是哪一层先达到边界,以及恢复后如何把容量余量重新设回安全区间。
学习目标
- 能区分 Redis
used_memory、进程 RSS 与系统或容器内存限制。 - 能通过 cgroup、进程和 Redis 指标判断 OOM 发生在哪一层。
- 能完成受控恢复,并把演练结果转化为新的容量门槛。
先建立三层观测
系统级 OOM 演练至少同时观察 Redis、进程和限制层。Redis 的 maxmemory 是应用层治理边界,并不等于进程绝对不会继续占用更多物理内存;RSS 还会受到分配器保留空间、峰值使用等因素影响。:contentReference[oaicite:5]{index=5}
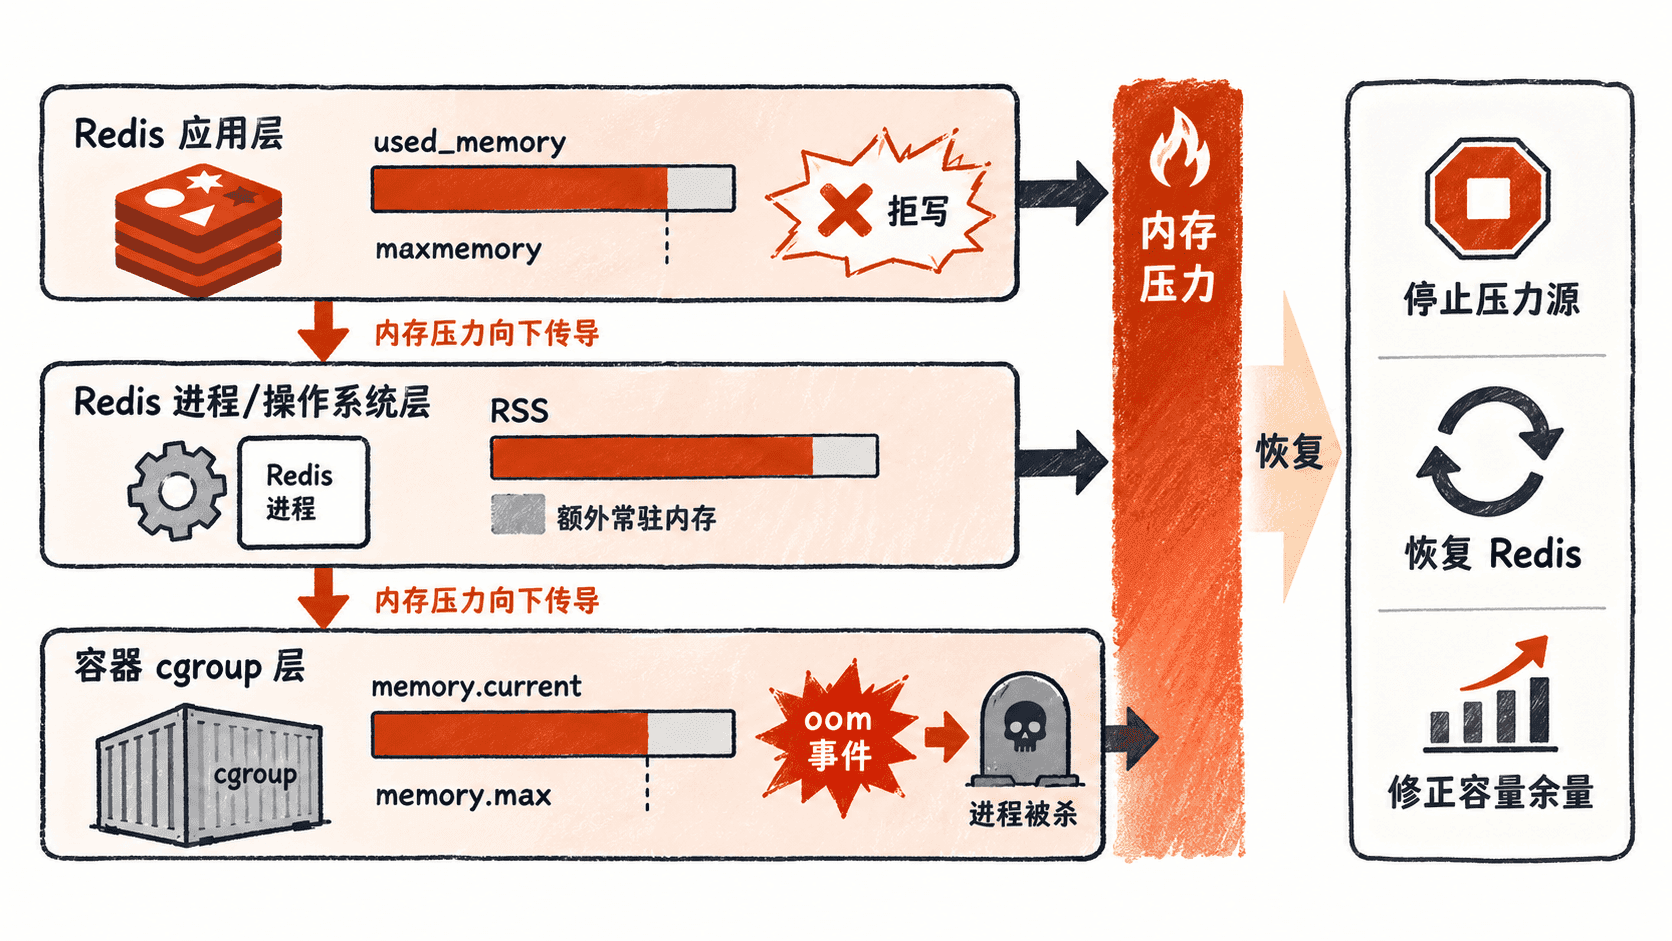
实验开始前先读取当前限制与 Redis 基线。下面命令以 Linux cgroup v2 为例;实际部署若使用其他运行时,路径可能不同。
printf 'Redis\n'
redis-cli -p <PORT> INFO memory | grep -E 'used_memory:|used_memory_rss:|maxmemory:'
printf '\nCgroup v2\n'
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.max
预期结果
Redis
used_memory:<基线值>
used_memory_rss:<基线值>
maxmemory:<配置值>

Cgroup v2
<memory.current 基线值>
<memory.max 或 max>
受控注入系统内存压力
演练重点是让“其他内存消耗”逼近系统或容器边界,而不是把 Redis 数据集本身无限做大。这样才能观察 used_memory 与 RSS、cgroup 限制之间可能出现的差异。容器内存限制最终由内核通过 cgroup 执行;发生内存压力时,进程可能被 OOM kill。:contentReference[oaicite:6]{index=6}
在专用实验容器中,可以使用一个受控的压力进程占用指定大小的匿名内存。不要在生产主机直接执行。
python3 - <<'PY'
import time
size_mb = 256
buf = bytearray(size_mb * 1024 * 1024)
for i in range(0, len(buf), 4096):
    buf[i] = 1
print(f"allocated={size_mb}MB")
time.sleep(600)
PY
预期结果
allocated=256MB实际能否达到 OOM 取决于实验容器的剩余内存、其他进程和 cgroup 配置。这个脚本的目的只是建立稳定、可停止的压力源,不应把某个固定 MB 数视为 OOM 阈值。
判断是哪一层先失败
看到 Redis 连接中断后,按“Redis 指标 → cgroup → 内核日志”的顺序核对。若 Redis 仍显示服务进程存活、只是写命令被 maxmemory 拒绝,更接近应用层容量问题;若进程直接消失并伴随 OOM kill 证据,则应继续查系统或容器层限制。Kubernetes 的容器内存 limit 在 Linux 上最终由 cgroup 与内核实施,内存压力下可能触发 OOM kill。:contentReference[oaicite:7]{index=7}
printf 'Process\n'
ps -eo pid,comm,rss,vsz,args | grep '[r]edis-server'
printf '\nCgroup events\n'
cat /sys/fs/cgroup/memory.events
printf '\nKernel evidence\n'
journalctl -k -n 100 --no-pager | grep -Ei 'oom|killed process|out of memory'
预期结果
Process
<PID> redis-server <RSS_KB> <VSZ_KB> ...

Cgroup events
low <N>
high <N>
max <N>
 oom <N>
 oom_kill <N>

Kernel evidence
<若发生系统级 OOM,可看到与 OOM 相关的内核日志;若未发生,则可能没有匹配行>
不要只凭 used_memory_rss 就断定“Redis 超过了 maxmemory”。maxmemory 与实际进程 RSS 不是同一统计口径;在持久化、分配器保留等情况下,物理内存使用可能高于 Redis 逻辑数据口径。:contentReference[oaicite:8]{index=8}
恢复与容量修正
先停止压力源,再确认 Redis 进程和客户端连接是否恢复;若进程已被杀,则按部署方式重新拉起并检查数据加载状态。恢复完成后,不要只记录“这次 OOM 被处理了”,还要把峰值 RSS、cgroup 上限与 Redis 的 maxmemory 放到同一张容量表里,重新计算安全余量。
一个实用原则是:maxmemory 不应直接顶到容器或主机可用内存上限。Redis 官方文档也提醒,持久化和复制等场景存在未计入淘汰判断的缓冲内存,因此容量规划需要为这些额外内存留下余量。:contentReference[oaicite:9]{index=9}
redis-cli -p <PORT> PING
redis-cli -p <PORT> INFO memory | grep -E 'used_memory:|used_memory_rss:|maxmemory:'
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.max
预期结果
PONG
used_memory:<恢复后的值>
used_memory_rss:<恢复后的 RSS>
maxmemory:<修正后的应用层上限>
<memory.current 已回落>
<memory.max <容器限制值或 max>
系统级 OOM 的演练结果最终应落到一个明确结论:Redis 的逻辑容量边界、进程物理内存峰值和容器或主机限制必须分别监控、分别告警,再用峰值关系设置容量余量;这样下一次故障出现时,才能迅速判断是 Redis 自身拒写,还是更外层的系统内存被耗尽。