
Redis 与缓存 / 系统课时
监控 Key 与淘汰趋势
监控 Key 与淘汰趋势
本课建立一套面向 Redis 内存治理的趋势监控方法:不只看当前内存值,而是同时观察 Key 数、过期、淘汰、命中率和命名空间增长,从时间变化中提前发现缓存模型或生命周期异常。
学习目标
- 能用 Redis 指标判断 Key 数、过期和淘汰是否出现异常趋势
- 能区分流量增长、缓存穿透、TTL 失效和容量压力等不同信号
- 能建立按命名空间拆分的趋势观测与告警基线
先看趋势,而不是只看单点
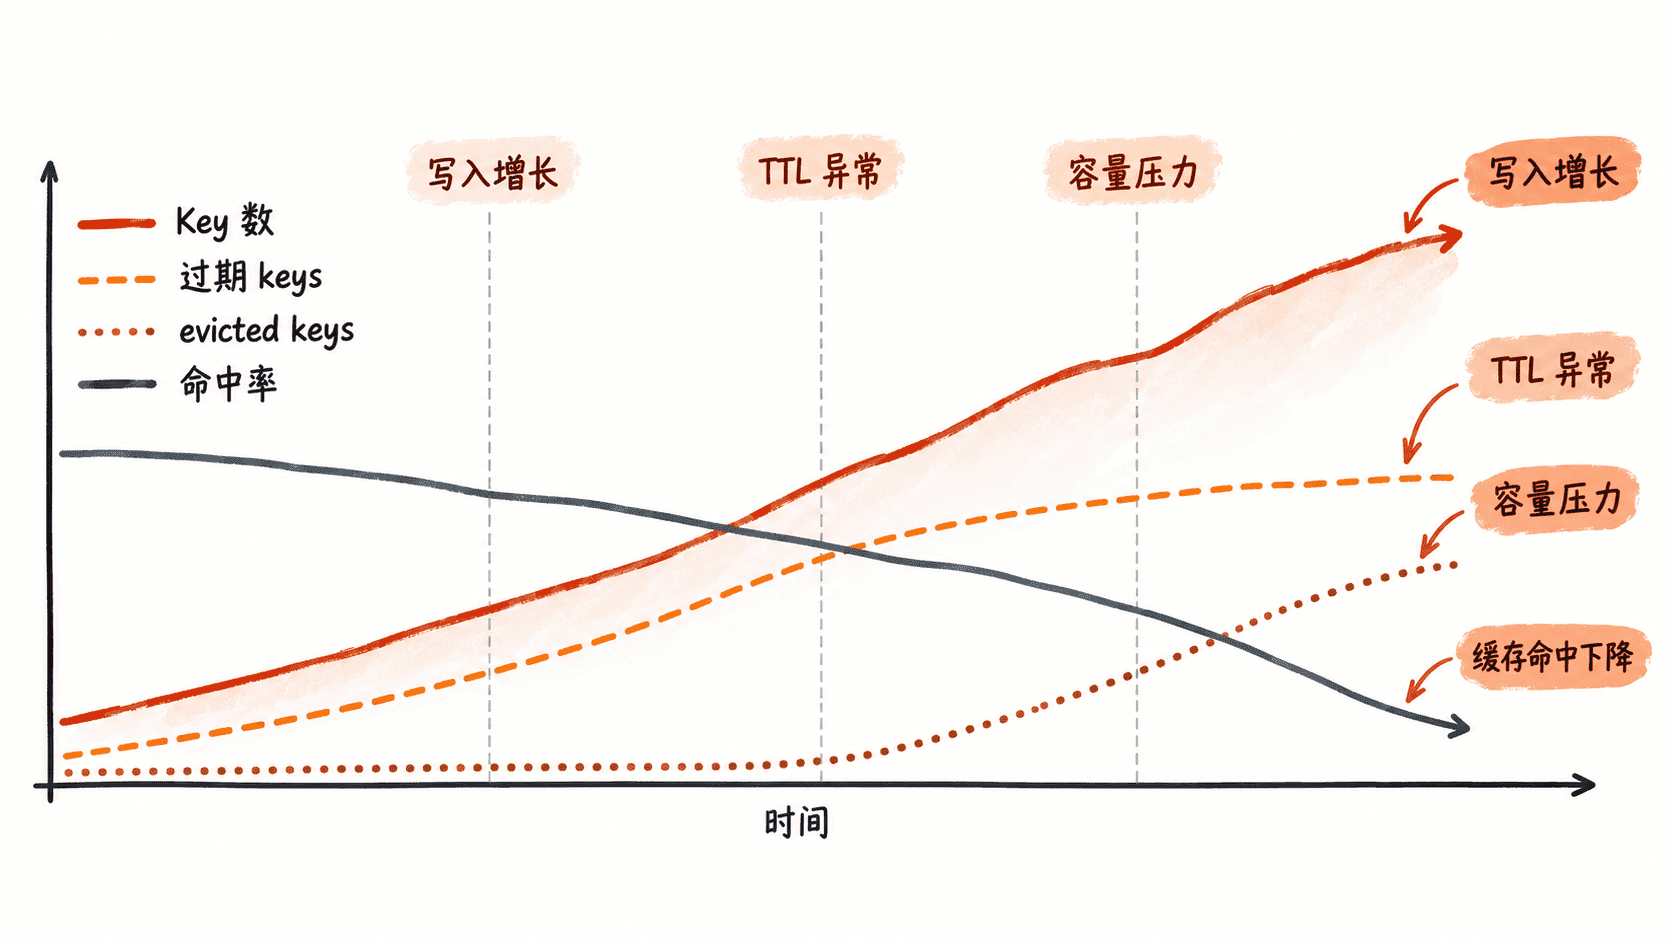
Redis 内存达到高位时,通常已经是结果,不一定是最早的信号。更有价值的是观察一段时间内的增长斜率:Key 数是否持续增加、过期是否跟不上写入、淘汰是否突然出现,以及命中率是否同步下降。
把这些指标放在同一时间窗口里看,才能判断“业务真的在增长”还是“缓存生命周期出了问题”。例如 Key 数快速上升、过期数量几乎不变、内存持续增加,更像是 TTL 缺失或生命周期变长;淘汰量突然升高,则说明已开始依赖 maxmemory 淘汰策略维持运行。
用 INFO 先建立基线
Redis 的 INFO stats、INFO keyspace 和 INFO memory 可以提供趋势监控所需的核心原始指标。先保存周期快照,再计算单位时间的变化量,比直接盯着当前值更容易发现异常。
redis-cli INFO stats | grep -E 'keyspace_hits|keyspace_misses|expired_keys|evicted_keys'
redis-cli INFO keyspace
redis-cli INFO memory | grep -E 'used_memory:|used_memory_peak:|maxmemory:'
预期结果
keyspace_hits:184203
keyspace_misses:12987
expired_keys:45210
evicted_keys:318
# Keyspace

# db0
keys=842315,expires=801244,avg_ttl=173842
# Memory
used_memory:612345678
used_memory_peak:698765432
maxmemory:1073741824
这些值会随业务持续变化,实际数字不同属于正常现象。关键不是某个固定阈值,而是把连续采样结果放进同一时间序列中比较。
重点看五组信号
Key 数反映对象规模,expires 反映带过期时间的 Key 数,expired_keys 反映已经自然过期的累计数量,evicted_keys 反映因达到内存策略而被淘汰的累计数量,命中与未命中则帮助判断缓存效果。
监控累计计数器时,不要直接把当前累计值当成“当前速率”。例如在 5 分钟窗口内计算:
命中率可用命中数与未命中数近似计算:
真正值得关注的是组合关系。Key 数增长而命中率稳定,可能只是业务规模扩大;Key 数增长、过期率下降且内存持续上涨,更应检查 TTL;淘汰率上升并伴随命中率下降,则需要优先处理容量压力或缓存模型变化。
把命名空间增长拆开
只看整个 Redis 实例容易掩盖局部异常。生产环境应尽量按业务前缀、数据库或数据结构建立命名空间维度,例如 session:*、product:*、feed:*。对每个命名空间记录 Key 数、占用内存和增长速度,才能定位“是谁在长大”。
一个简单的采样脚本可以先把关键实例指标落盘,后续交给监控系统做时间序列计算。
printf '%s ' "$(date -u +%FT%TZ)"
redis-cli INFO stats | tr '\r' '\n' | grep -E 'expired_keys|evicted_keys|keyspace_hits|keyspace_misses'
redis-cli DBSIZE
预期结果
<TIME> expired_keys:45210 evicted_keys:318 keyspace_hits:184203 keyspace_misses:12987 842315这里的 <TIME> 代表实际采样时间,DBSIZE 只反映当前数据库 Key 数,不能代替按命名空间拆分的统计。命名空间级内存分析还需要结合 Key 前缀或业务侧统计,不能仅凭 DBSIZE 推断某个前缀占用了多少内存。
哪些趋势值得提前处理
最典型的风险是“增长很快但没有回落”。例如写入量稳定增长,而 expires 占比越来越低,说明越来越多 Key 可能没有设置 TTL;若同时出现 used_memory 快速接近 maxmemory,就应该在发生大量淘汰前处理缓存生命周期。
另一个风险是淘汰突然出现。少量 evicted_keys 并不一定意味着故障,但如果淘汰速率持续升高,并与命中率下降、请求延迟升高同时出现,就应视为容量治理信号,而不是单纯的 Redis 指标波动。
告警不要只设置“Key 数超过某个固定值”。更实用的规则通常包含持续时间和组合条件,例如“Key 数连续增长、内存使用率连续高位、淘汰速率持续非零”同时满足时升级告警。这样可以减少业务高峰造成的短暂误报。
最终要形成的是一条可解释的趋势链:业务写入增长带来 Key 增长,生命周期决定 Key 是否自然退出,容量上限决定是否发生淘汰,而命中率和延迟负责验证淘汰是否已经影响业务。只有把这几类指标放在同一时间窗口分析,监控才真正能承担 OOM 之前的预警职责。