
Redis 与缓存 / 系统课时
拆解数据集与结构开销
拆解数据集与结构开销
Redis 里的“数据量”不等于实际占用的内存。除了键和值本身,数据库字典、对象元数据、编码结构以及过期时间索引都会消耗空间。本课把这些组成拆开,并用 Redis 自带命令观察单个键和整个数据集的内存成本。
学习目标
- 区分有效数据、Redis 对象与数据库索引等主要内存组成
- 理解相同业务数据为什么可能产生不同的真实内存占用
- 使用
MEMORY USAGE、OBJECT ENCODING和INFO memory建立观测基线
从业务数据到真实内存占用
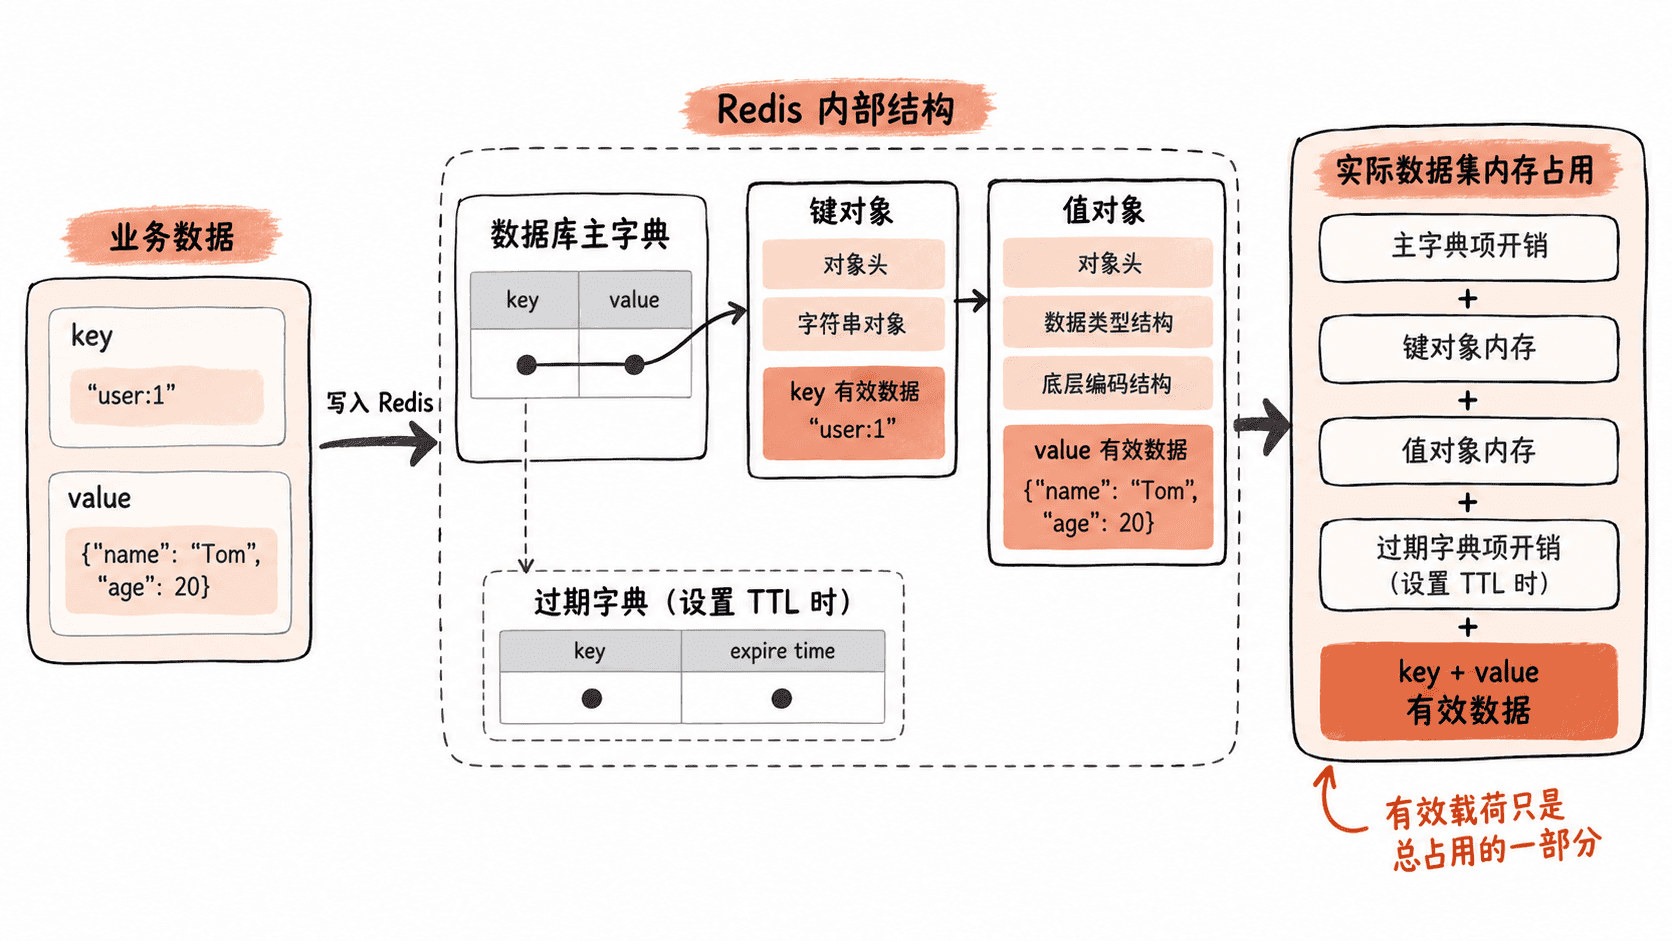
业务通常只关心“存了多少字节”,例如一个字符串值有 100 字节。但 Redis 必须维护能够定位、解释和管理这些数据的结构,因此内存中还会存在键对象、值对象、字典节点、哈希表桶,以及某些数据类型自身的内部索引。
对于设置了 TTL 的键,Redis 还需要在独立的过期字典中记录键与过期时间的关系。因此,同一个键既会出现在数据库主字典的索引关系中,也可能出现在过期管理结构中。不能简单把 STRLEN、集合成员长度或序列化后的业务字节数当作 Redis 的真实内存占用。
对象编码会改变结构开销
Redis 的 String、Hash、List、Set、Sorted Set 等逻辑类型,不一定始终使用同一种底层编码。Redis 会根据元素数量、元素大小以及版本支持的编码策略,在紧凑表示与更适合大规模访问的结构之间选择。
例如,小型 Hash 往往能使用紧凑编码减少指针和哈希表开销;当数据规模超过相应阈值后,编码可能切换,单元素平均成本随之上升。因此两个“字段和值完全等长”的 Hash,只要元素数量或编码不同,总内存就可能差很多。
可以直接观察键的编码和估算内存占用。下面创建两个键,其中第二个键额外设置 TTL:
redis-cli SET profile:1 'alice'
redis-cli SET session:1 'token-123' EX 3600
redis-cli OBJECT ENCODING profile:1
redis-cli MEMORY USAGE profile:1
redis-cli MEMORY USAGE session:1
预期输出
OK
OK
<ENCODING>
<VALUE>
<VALUE>
<ENCODING> 会随 Redis 版本和对象内容而变化;<VALUE> 是以字节为单位的估算结果,也会受运行版本、构建方式和分配器影响。这里重点不是比较两个数字的绝对大小,而是确认 MEMORY USAGE 观察的是 Redis 为键及其值维护的内存,而不是单纯的业务字符串长度。
字典和过期字典为什么不能忽略
每个 Redis 数据库都需要主字典把键映射到值。即使业务值非常小,键越多,字典节点、哈希桶和键对象等固定或半固定成本累计得越明显。因此大量几十字节的小 Key,往往比少量大 Value 更容易出现“业务有效数据不多,但 Redis 已经用了很多内存”的现象。
TTL 也不是免费的。只有设置了过期时间的键才需要进入过期字典,所以大量短生命周期 Key 除了频繁创建和删除,还会引入额外的过期管理成本。实际治理时应同时关注键数量、平均键值大小和带 TTL 键的比例,而不是只看业务数据文件或序列化后的字节数。
可以通过数据库统计快速确认键和过期键的规模:
redis-cli INFO keyspace预期输出
# Keyspace
db0:keys=<VALUE>,expires=<VALUE>,avg_ttl=<VALUE>
其中 keys 是当前数据库键数量,expires 是带过期时间的键数量。实际环境可能存在多个 db<N> 行;avg_ttl 以及具体数字会随运行状态变化。
用整体指标建立内存基线
单键分析只能说明局部结构,治理 OOM 还需要知道整个实例的数据集究竟占了多少。INFO memory 提供了后续分析会频繁使用的入口:
redis-cli INFO memory预期输出
# Memory
used_memory:<VALUE>
used_memory_human:<VALUE>
used_memory_dataset:<VALUE>
used_memory_dataset_perc:<VALUE>
<OTHER_MEMORY_FIELDS>
used_memory 表示 Redis 通过分配器申请并计入统计的内存规模;used_memory_dataset 更接近数据集及其相关开销,而不是整个 Redis 进程的全部内存。字段集合会因 Redis 版本而有所不同,因此排障时应以当前实例实际返回结果为准。
不要把 used_memory_dataset 理解成“纯 Value 字节数”。它依旧包含支撑数据集存在所需要的内部结构,只是排除了部分不属于数据集本身的内存。真正评估业务数据密度时,应把键数量、编码、TTL 比例和 MEMORY USAGE 抽样结果一起看。
判断结构开销是否异常
如果实例有几千万个很小的 Key,即使单个值只有十几字节,固定结构开销累计后也可能成为主要内存来源。这时优化方向通常不是继续压缩某个已经很小的 Value,而是减少 Key 数、合并过细粒度对象,或重新选择更紧凑的数据组织方式。
反过来,如果少量 Key 承载很大的字符串、集合或压缩后仍很大的序列化对象,那么 Value 本身才可能是主要矛盾。先判断内存究竟消耗在“有效数据”还是“为了管理大量对象产生的结构成本”上,后续的淘汰策略、数据建模和容量治理才不会选错方向。