
消息队列 / 系统课时
超过重试次数转入死信队列
超过重试次数转入死信队列
延迟重试只能解决暂时故障,不能让永久失败的订单无限循环。本节在重试链路上增加次数上限:每次失败递增 x-retry-count,未到上限就延迟回投,达到上限后写入最终异常队列,为人工核查、补偿或重新驱动保留完整消息依据。
学习目标
- 区分“继续重试”和“终止自动重试”的判定位置。
- 实现带最大次数限制的延迟重试,并把持续失败订单送入最终异常队列。
- 保留重试次数与最后失败原因,便于后续人工处理和审计。
用次数上限切断重试循环
本例把“最多重试 3 次”解释为:第一次正常消费失败后,还允许 3 次重新尝试;如果第 4 次处理仍失败,则不再进入重试队列,而是发布到 order.failed。
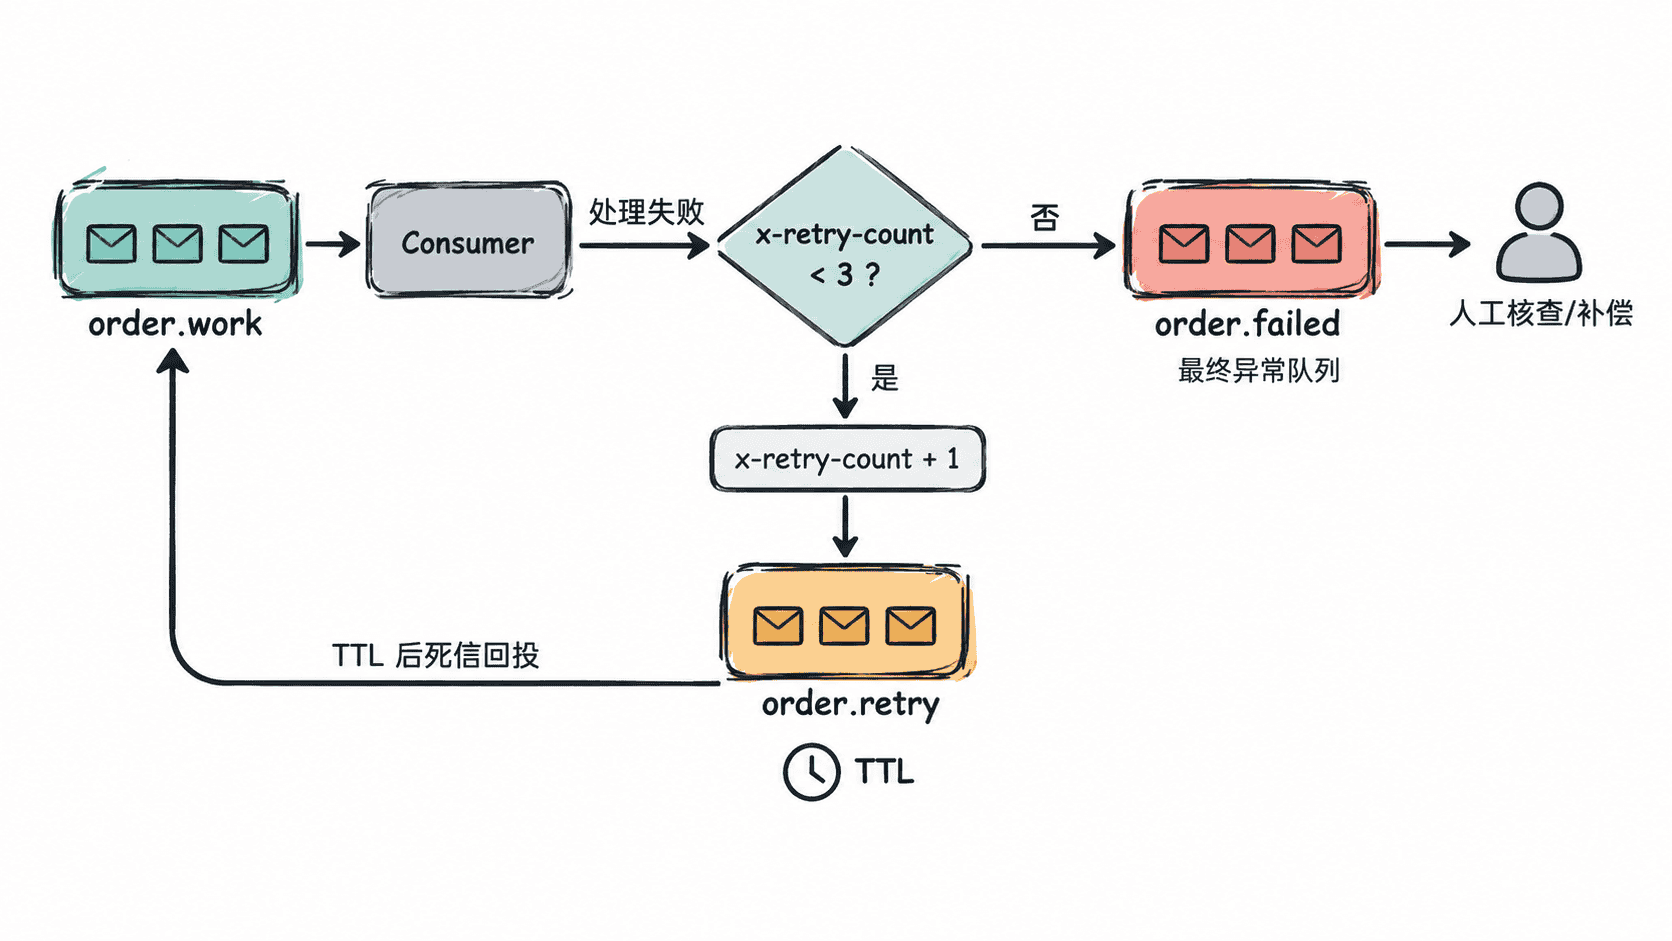
这里使用自定义消息头计数,而不是让队列无限自循环。计数由消费者在每次重新发布前递增,因此“第几次重试”的业务含义清晰,也方便最终异常队列直接读取。
实现三次重试与最终异常队列
下面的完整示例沿用固定 TTL 重试队列,并新增 order.failed。process_order 故意始终抛出超时异常,用来演示 3 次重试后进入最终异常队列。
import pika

MAX_RETRIES = 3
RETRY_MS = 3000

connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost", port=5672)
)
channel = connection.channel()
channel.exchange_declare(
    exchange="order.direct",
    exchange_type="direct",
    durable=True,
)

channel.queue_declare(queue="order.work", durable=True)
channel.queue_declare(
    queue="order.retry",
    durable=True,
    arguments={
        "x-message-ttl": RETRY_MS,
        "x-dead-letter-exchange": "order.direct",
        "x-dead-letter-routing-key": "order.work",
    },
)
channel.queue_declare(queue="order.failed", durable=True)

for queue_name, routing_key in (
    ("order.work", "order.work"),
    ("order.retry", "order.retry"),
    ("order.failed", "order.failed"),
):
    channel.queue_bind(
        queue=queue_name,
        exchange="order.direct",
        routing_key=routing_key,
    )

channel.confirm_delivery()

def process_order(body):
    raise TimeoutError("payment timeout")

def publish_and_confirm(routing_key, body, headers):
    channel.basic_publish(
        exchange="order.direct",
        routing_key=routing_key,
        body=body,
        properties=pika.BasicProperties(
            headers=headers,
            delivery_mode=2,
        ),
        mandatory=True,
    )

def handle_order(ch, method, properties, body):
    headers = dict(properties.headers or {})
    retry_count = int(headers.get("x-retry-count", 0))

    try:
        process_order(body)
        ch.basic_ack(delivery_tag=method.delivery_tag)
    except TimeoutError as exc:
        headers["x-last-error"] = str(exc)

        if retry_count < MAX_RETRIES:
            next_count = retry_count + 1
            headers["x-retry-count"] = next_count
            publish_and_confirm("order.retry", body, headers)
            print(f"处理失败,安排第 {next_count} 次重试")
            ch.basic_ack(delivery_tag=method.delivery_tag)
            return

        publish_and_confirm("order.failed", body, headers)
        print(f"已重试 {retry_count} 次仍失败,转入 order.failed")
        ch.basic_ack(delivery_tag=method.delivery_tag)
        ch.stop_consuming()

channel.basic_publish(
    exchange="order.direct",
    routing_key="order.work",
    body=b'{"orderId":"A2001"}',
    properties=pika.BasicProperties(
        headers={"x-retry-count": 0},
        delivery_mode=2,
    ),
    mandatory=True,
)
channel.basic_consume(
    queue="order.work",
    on_message_callback=handle_order,
    auto_ack=False,
)
channel.start_consuming()
connection.close()
预期输出:
处理失败,安排第 1 次重试
处理失败,安排第 2 次重试
处理失败,安排第 3 次重试
已重试 3 次仍失败,转入 order.failed
每次重试之间约间隔 3 秒。脚本先确认新消息发布成功,再确认当前消息;如果重新发布阶段抛出异常,原消息不会走到 basic_ack,连接关闭后仍有机会被重新投递。
最终异常队列要保留什么
order.failed 不是普通重试队列,它代表自动处理已经停止。至少应保留原始消息体、稳定的业务标识、重试次数和最后失败原因。示例把 x-retry-count 与 x-last-error 一起带入最终队列,人工处理程序可以据此筛选问题。
不要把完整堆栈、超长响应体或敏感凭据直接塞进消息头。更稳妥的做法是保留简短错误码、关联 ID,并把详细异常写入日志或观测系统。这样既能定位问题,也不会让消息属性无限膨胀。
验证停止重试而不是继续循环
运行示例后,控制台只应出现 3 次“安排重试”和 1 次“转入 order.failed”。如果之后仍持续出现新的重试日志,说明次数判断、消息头复制或路由键存在问题。
还应确认最终异常队列没有配置自动回到业务队列的 TTL 或死信回路。最终队列的职责是隔离持续失败消息,后续应由人工审批、补偿任务或专门的重放工具决定是否再次投递,而不是自动无限循环。