
消息队列 / 系统课时
死信队列里的消息怎么处理
死信队列里的消息怎么处理
死信队列不是“消息坟场”,而是自动处理失败后的隔离区。本节建立一条可操作的处理闭环:先观察积压和失败原因,再修复根因,最后小批量重新发布或归档,避免把问题消息直接倒回主链路再次制造故障。
学习目标
- 判断死信积压是单条异常还是系统性故障
- 为死信记录足够的排查与审计信息
- 按安全顺序修复、重放并验证处理结果
先把死信变成可观察对象
先看队列是否持续增长、是否有消费者正在处理,而不是立即 purge 或批量重放。下面命令查看默认虚拟主机中的队列状态,重点关注最终死信队列的 Ready、Unacked 和消费者数量。
rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers arguments预期输出
name                messages_ready    messages_unacknowledged    consumers    arguments
orders.final.dlq    <COUNT>           <COUNT>                    <COUNT>      <ARGUMENTS>
实际队列名、数量和参数内容会不同;只要能看到目标死信队列及这些关键列,就完成了第一步观察。若 messages_ready 持续上升,应先判断上游是否仍在产生同类失败,再决定是否启动人工处理。
处理单条死信时,建议至少记录消息 ID 或业务主键、原始交换机与路由键、失败时间、最后错误类型、应用重试次数以及 x-death 信息。消息体可能包含敏感数据,不要为了排障把完整内容无条件写入普通日志。
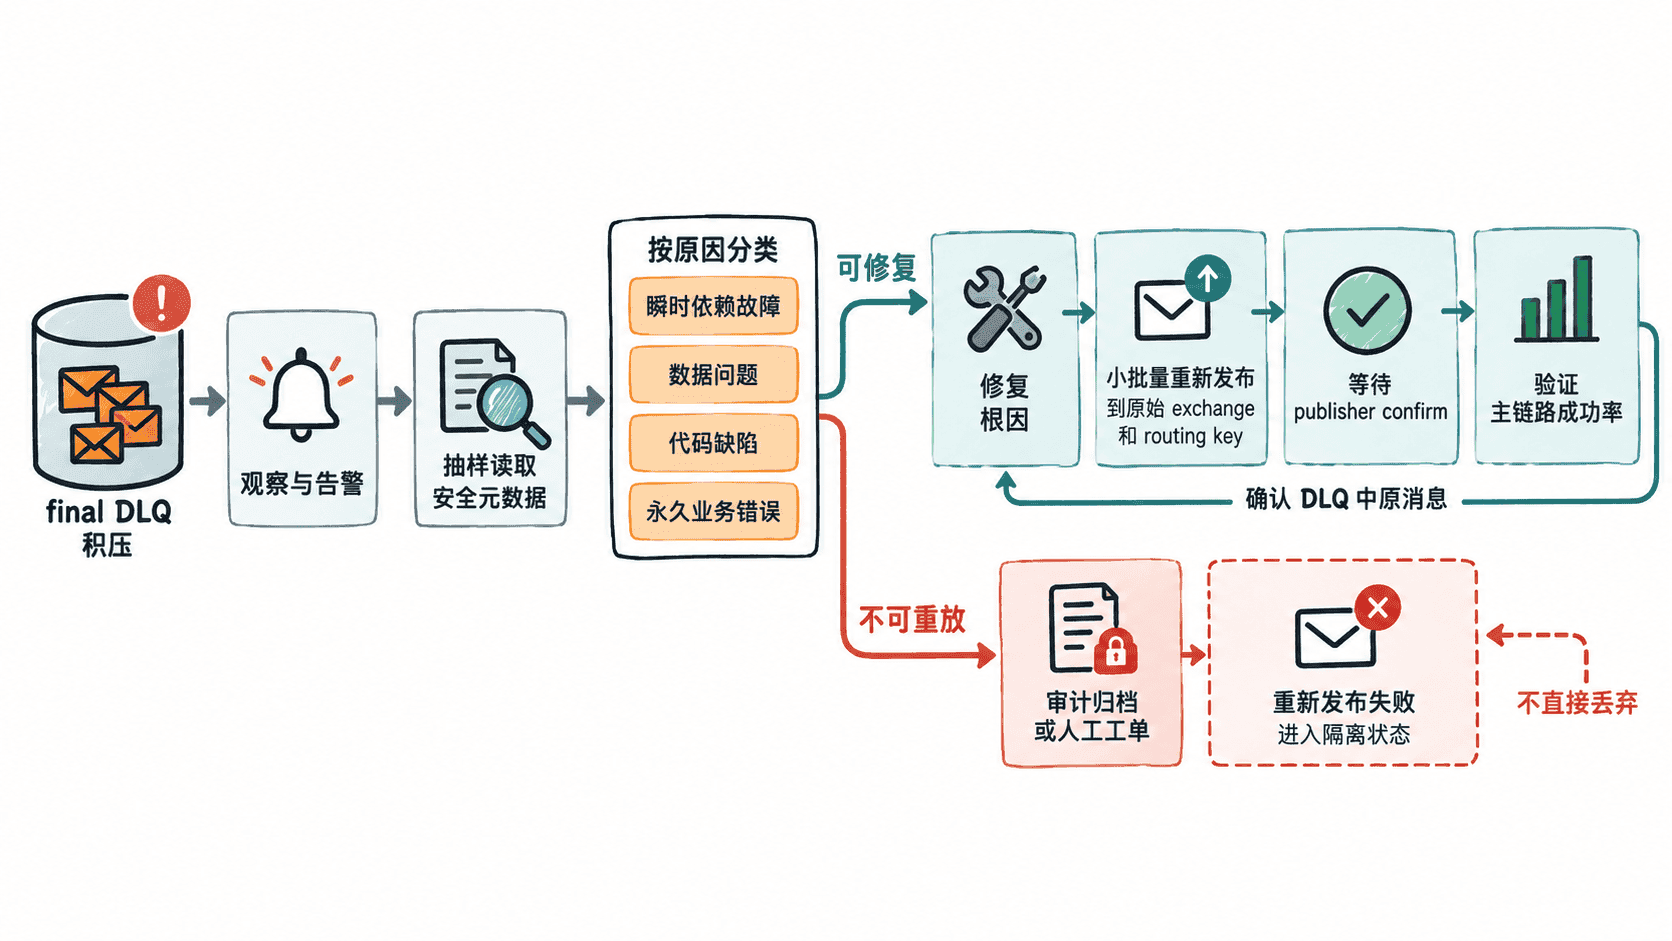
按原因分类再决定动作
死信的处理动作取决于根因,而不是取决于“它在 DLQ 里待了多久”。常见情况可以分成四类:外部依赖短时不可用、消息数据不符合当前约束、消费者代码缺陷、以及业务上永远无法成功的请求。
外部依赖已经恢复时可以重放;数据问题应先修正数据或兼容逻辑;代码缺陷应先发布修复版本;永久业务错误则应保留审计记录后归档或丢弃。只要根因还存在,重放就只是把同一个失败重新执行一遍。
修复后按小批量重新发布
重放时应把消息重新发布到原始交换机和路由键,让现有绑定重新决定目标队列,而不是直接写入某个业务队列。若系统会修改路由,最好在最初发布时就保存业务需要的原始路由元数据,避免后续只能依赖不完整的现场信息恢复路径。
安全的重放工具应使用手动确认:从 DLQ 取出消息,发布到目标交换机,等待 publisher confirm;只有确认新发布成功后,才 ack DLQ 中的原消息。若发布失败,则保留或重新入列原死信。这个顺序可能产生重复但能避免静默丢失,因此业务消费者仍需依赖业务主键或幂等键去重。
重放不要一次放开全部积压。先选择少量样本验证成功率、延迟和下游负载,再逐步扩大批次;如果同一错误再次出现,应立即停止重放并回到根因分析。
不应做的几件事
不要把 purge 当成“处理完了”,因为它只删除 Ready 消息,不会留下业务层的处理结论。不要在根因未修复时自动把最终死信重新路由回主队列,也不要为了让消息“过掉”而无审计地改写消息体。
对于涉及支付、库存、通知等副作用的消息,重放前还要确认幂等策略仍然有效。历史消息可能跨越代码版本或数据版本,能够消费并不等于应该再次执行业务动作。
验收处理结果
完成一批处理后,要同时看三个结果:最终死信队列积压按预期下降,主业务队列没有出现同类失败回潮,下游业务状态与幂等记录一致。仅看到 DLQ 数量变少,不能证明问题已经解决。
一条成熟的死信处理链路应该让每条异常消息都有明确结论:已修复并重放、确认永久失败并归档,或仍处于人工调查中。只有这样,死信队列才是故障隔离和恢复机制,而不是长期无人管理的消息堆积区。