
消息队列 / 系统课时
消息为什么会集中到一个消费者
消息为什么会集中到一个消费者
同一个队列挂了多个 Consumer,并不意味着每个 Consumer 最终处理的消息一定一样多。真正影响分配结果的,是消息何时被投递、是否需要确认,以及某个 Consumer 何时释放自己的未确认额度。本篇用快慢消费者对比,解释“某个消费者吃掉大部分任务”为什么可能是正常现象。
学习目标
- 理解 RabbitMQ 不会持续计算“平均处理条数”,而是按可投递状态继续发消息
- 观察快慢消费者在
prefetch_count=1下为何会获得不同数量的任务 - 区分“消息被快速消费者多处理”和“消息堆在慢消费者的 unacked 中”两种现象
分配不等于平均处理
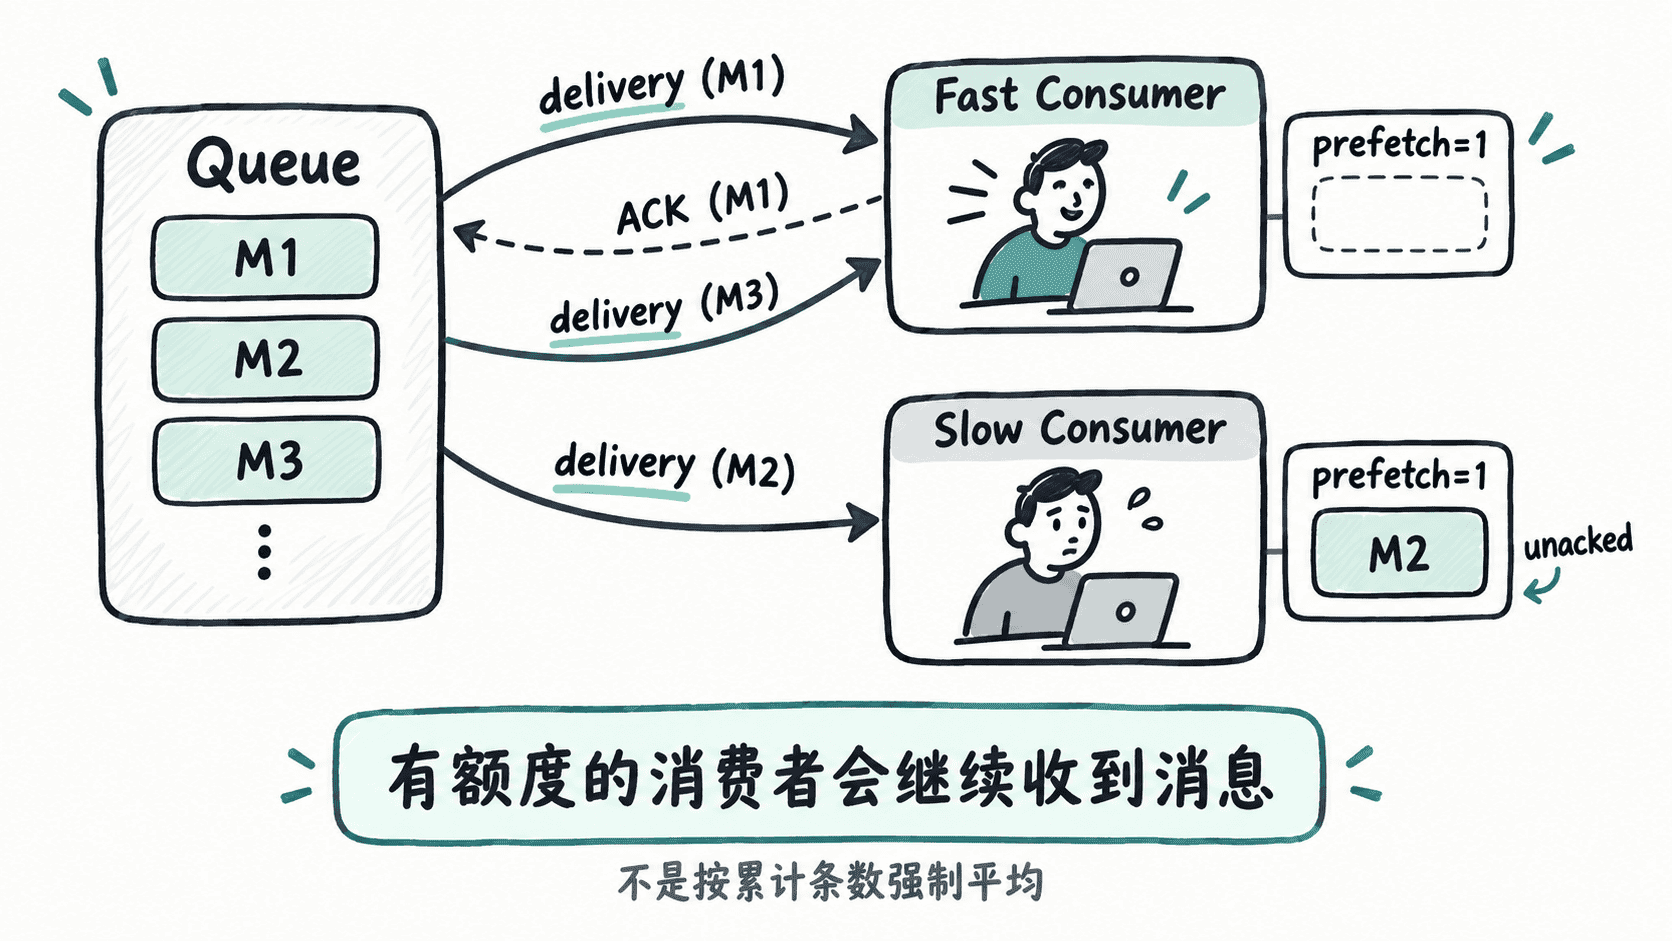
RabbitMQ 向同一队列的多个 Consumer 投递消息时,初始分发可以看起来很均匀,但最终处理量还取决于确认速度。使用手动确认并把 Prefetch 设为 1 后,每个 Consumer 同时最多占用 1 条未确认消息。
快 Consumer 很快完成任务并发送 ACK,于是它立即腾出一个投递额度;慢 Consumer 仍在处理上一条消息,没有空闲额度。接下来的消息就更容易继续交给快 Consumer。RabbitMQ 并不是读取了你的业务耗时,而是通过“是否还有未确认额度”间接体现消费能力。
用快慢消费者观察差异
下面的完整示例假设 RabbitMQ 可通过 localhost:5672 连接,并已安装 Python 的 pika 包。程序启动两个独立 Consumer:fast 每条任务处理 0.05 秒,slow 每条处理 0.5 秒;两者都使用手动 ACK 和 prefetch_count=1。
import multiprocessing as mp
import time

import pika

QUEUE = "speed_demo"

def worker(name: str, delay: float) -> None:
    connection = pika.BlockingConnection(
        pika.ConnectionParameters(host="localhost")
    )
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=False, auto_delete=True)
    channel.basic_qos(prefetch_count=1)

    idle_rounds = 0
    for method, properties, body in channel.consume(
        QUEUE,
        inactivity_timeout=1,
        auto_ack=False,
    ):
        if method is None:
            idle_rounds += 1
            if idle_rounds >= 2:
                break
            continue

        idle_rounds = 0
        print(f"{name} <- {body.decode()}", flush=True)
        time.sleep(delay)
        channel.basic_ack(delivery_tag=method.delivery_tag)

    connection.close()

def main() -> None:
    connection = pika.BlockingConnection(
        pika.ConnectionParameters(host="localhost")
    )
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=False, auto_delete=True)
    channel.queue_purge(queue=QUEUE)

    fast = mp.Process(target=worker, args=("fast", 0.05))
    slow = mp.Process(target=worker, args=("slow", 0.5))
    fast.start()
    slow.start()

    # 先让两个 Consumer 都进入等待,再开始投递任务。
    time.sleep(0.5)
    for i in range(1, 13):
        channel.basic_publish(
            exchange="",
            routing_key=QUEUE,
            body=f"task-{i}",
        )

    connection.close()
    fast.join()
    slow.join()

if __name__ == "__main__":
    main()
预期输出
fast <- task-<ID>
slow <- task-<ID>
fast <- task-<ID>
fast <- task-<ID>
...
具体任务编号与顺序会受进程调度影响,但通常 fast 处理的条数明显更多,因为它更频繁地 ACK 并释放 Prefetch 额度。
两种“集中”不要混为一谈
如果 Prefetch 很小,例如 1,快速 Consumer 更容易不断释放额度,因此最终处理量可能明显偏向它。这是一种基于消费能力形成的动态分配,通常正是希望看到的结果。
如果 Prefetch 很大或完全不限制,Broker 可能提前把很多消息推给某个较慢 Consumer。此时这些消息已经离开 ready 状态,却长期停留在该 Consumer 的 unacked 中;其他 Consumer 即使后来空闲,也不能直接“抢走”这些已投递消息。
判断分配是否异常时,不要只看“每个 Consumer 最后处理了几条”。还要同时看 Prefetch、ACK 模式,以及消息是停留在 ready 还是 unacked。真正要优化的是任务在消费者之间的流动和等待时间,而不是机械追求每个消费者条数完全相等。