
消息队列 / 系统课时
为什么可靠投递会产生重复消息
为什么可靠投递会产生重复消息
可靠投递通常遵循“没有拿到确认就重试”的原则,这能降低消息丢失概率,却无法保证发送方准确知道上一次操作是否已经成功。因此,同一业务消息被再次发布或重新投递,是可靠链路中的正常现象。
学习目标
- 理解确认丢失为什么会把“不确定”转化为重复消息
- 区分生产者重发与消费者重新投递两种重复来源
- 使用稳定业务标识设计幂等消费
没确认并不等于没执行
网络系统中最棘手的情况不是明确失败,而是结果未知。生产者发送消息后,RabbitMQ 可能已经成功接管消息,但返回的 Publisher Confirm 在网络中丢失。此时生产者只知道“没有收到确认”,却无法证明 Broker 没有收到第一次发布。
如果生产者为了避免丢消息而重新发送,Broker 就可能得到两份代表同一业务操作的消息。这不是确认机制失效,而是重试策略为了获得至少一次投递而接受的副作用。
消费端也存在同样的窗口。消费者可能已经完成扣库存、写数据库或调用下游接口,但在发送 ACK 前连接断开,或者 ACK 没有成功到达 RabbitMQ。Broker 看见的只是消息仍处于未确认状态,因此会再次投递它。
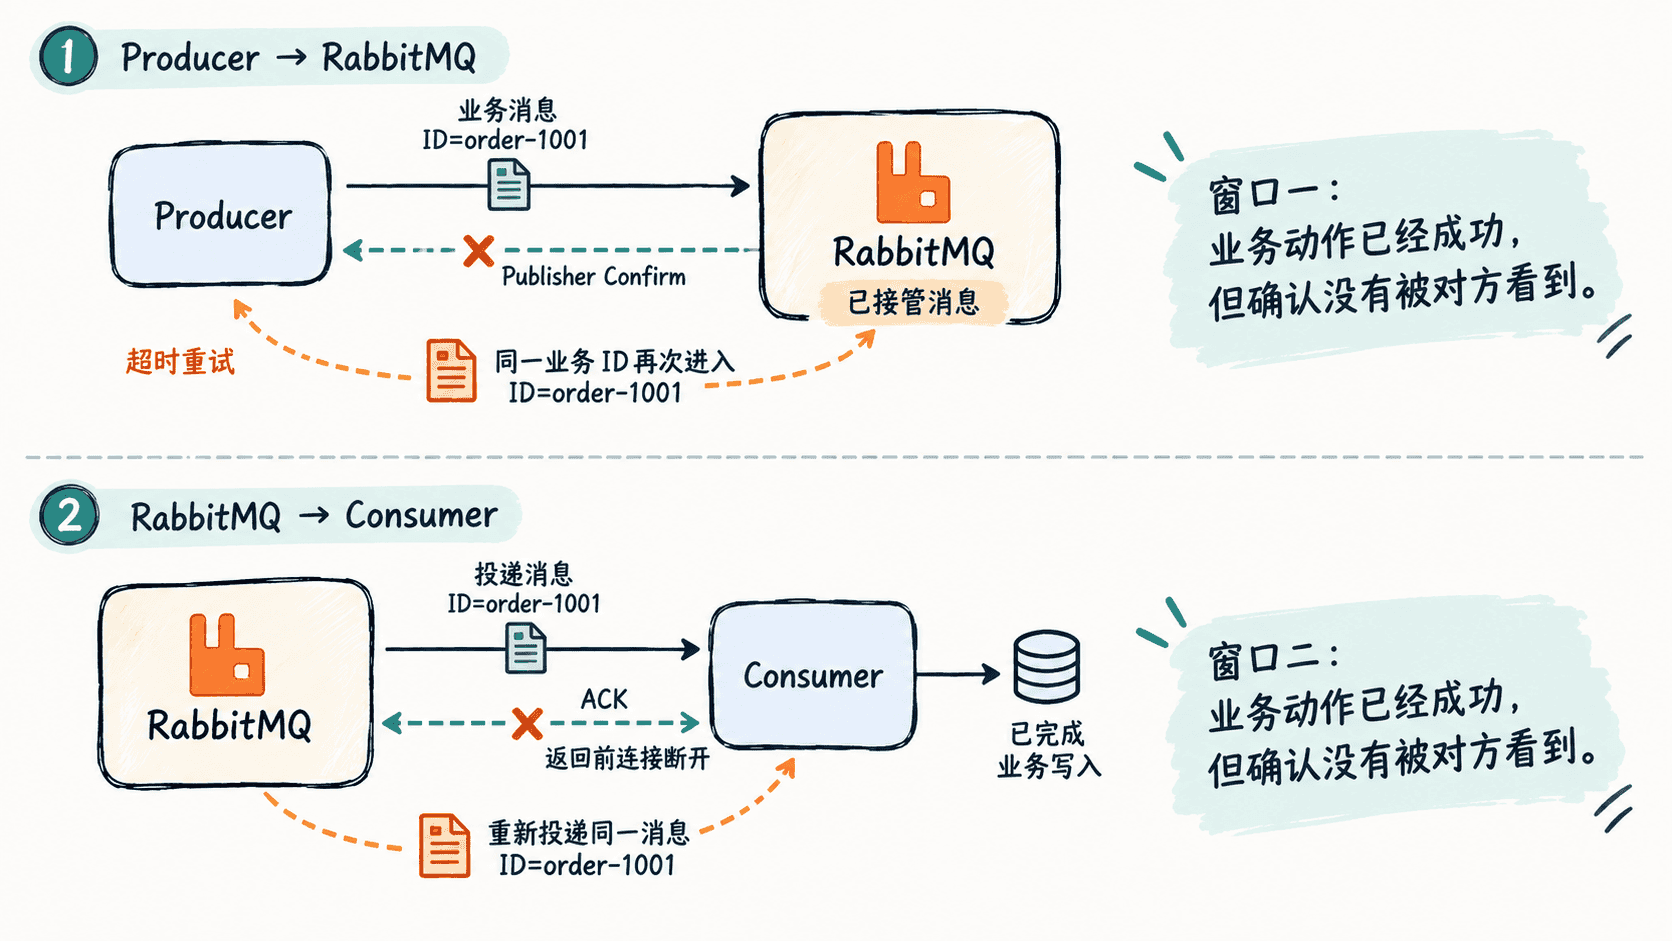
可靠性与重复是同一项取舍
如果系统选择“超时后绝不重试”,确实可以减少重复,但第一次操作实际上失败时,消息就可能永久丢失。可靠系统通常选择另一侧:在结果不确定时允许重试,再让下游能够识别重复。
这类语义通常称为 at-least-once:消息应该至少有机会被处理一次,但在故障和恢复过程中可能出现多次投递。RabbitMQ 的重新投递机制可以帮助避免未确认消息直接消失,却不会自动理解“两条消息是不是同一笔订单”。
redelivered 标记可以帮助观察某次投递是否属于重新投递,但它不应该成为业务去重的唯一依据。真正稳定的去重键通常来自消息中的 messageId、订单号、支付流水号等业务唯一标识。
用业务 ID 把重复执行变成幂等处理
下面程序主动发布两条具有相同 messageId 的消息,模拟生产者因为确认结果未知而重试。消费者使用这个 ID 判断业务是否已经执行过。示例中的内存集合只用于演示;生产环境需要把幂等记录放到数据库或其他能够跨进程、跨重启保存的存储中。
import com.rabbitmq.client.AMQP;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

import java.nio.charset.StandardCharsets;
import java.util.Set;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;

public class IdempotentConsumerDemo {
    public static void main(String[] args) throws Exception {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("localhost");

        try (Connection connection = factory.newConnection();
             Channel channel = connection.createChannel()) {
            String queue = "demo.idempotency";
            channel.queueDeclare(queue, true, false, false, null);
            channel.queuePurge(queue);

            String messageId = "order-1001";
            AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
                    .messageId(messageId)
                    .deliveryMode(2)
                    .build();
            byte[] body = messageId.getBytes(StandardCharsets.UTF_8);

            // 两次发布代表发送方在结果未知时进行了一次重试。
            channel.basicPublish("", queue, props, body);
            channel.basicPublish("", queue, props, body);

            Set<String> processed = ConcurrentHashMap.newKeySet();
            CountDownLatch latch = new CountDownLatch(2);

            String consumerTag = channel.basicConsume(queue, false,
                    (tag, delivery) -> {
                        String id = delivery.getProperties().getMessageId();
                        if (processed.add(id)) {
                            System.out.println("处理业务: " + id);
                        } else {
                            System.out.println("跳过重复: " + id);
                        }
                        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
                        latch.countDown();
                    },
                    tag -> { });

            latch.await(5, TimeUnit.SECONDS);
            channel.basicCancel(consumerTag);
        }
    }
}
预期输出
处理业务: order-1001
跳过重复: order-1001
这里两条 RabbitMQ 消息都被消费并 ACK,但业务动作只执行一次。关键不是“发现第二次投递后拒绝 RabbitMQ”,而是让重复消息再次到达时能够安全地产生与第一次相同的最终结果。
生产环境要把判断和业务结果绑在一起
内存 Set 在进程重启后会丢失,因此不能作为真正的幂等方案。常见做法是在数据库中为业务唯一 ID 建唯一约束,或者建立消费记录表,并让“检查是否处理过”和“写入业务结果”处于能够保证一致性的事务边界内。
可靠投递的目标不是让重复永远不出现,而是在发布确认丢失、消费者 ACK 丢失和连接恢复等情况下仍尽量不丢业务消息。只要系统允许重试,就应该把重复视为正常输入,并用稳定业务 ID 与幂等约束保证重复到达不会重复产生业务结果。