
消息队列 / 系统课时
重试次数怎样限制
重试次数怎样限制
重试如果没有上限,临时故障会演变成消息热循环、下游雪崩和日志洪峰。本节用应用级重试计数控制尝试次数,并说明何时把消息送入最终死信队列,避免失败消息无限返回主链路。
学习目标
- 明确“初次消费”和“重试次数”的计数口径
- 使用消息头保存并判断应用级重试次数
- 在超过上限后安全转入最终死信或人工处理流程
先定义重试次数
先统一口径:x-retry-count 表示消息已经进入过重试流程的次数。初次投递时字段不存在或为 0;第一次处理失败后,如果允许重试,就重新发布为 1。若上限为 3,表示初次处理之外最多再尝试三次。
判断顺序应固定为“读取计数 → 判断是否达到上限 → 决定重试或终止”。不要把 redelivered 当计数器,它只能说明消息是否曾被再次投递,不能告诉你已经失败了几次。
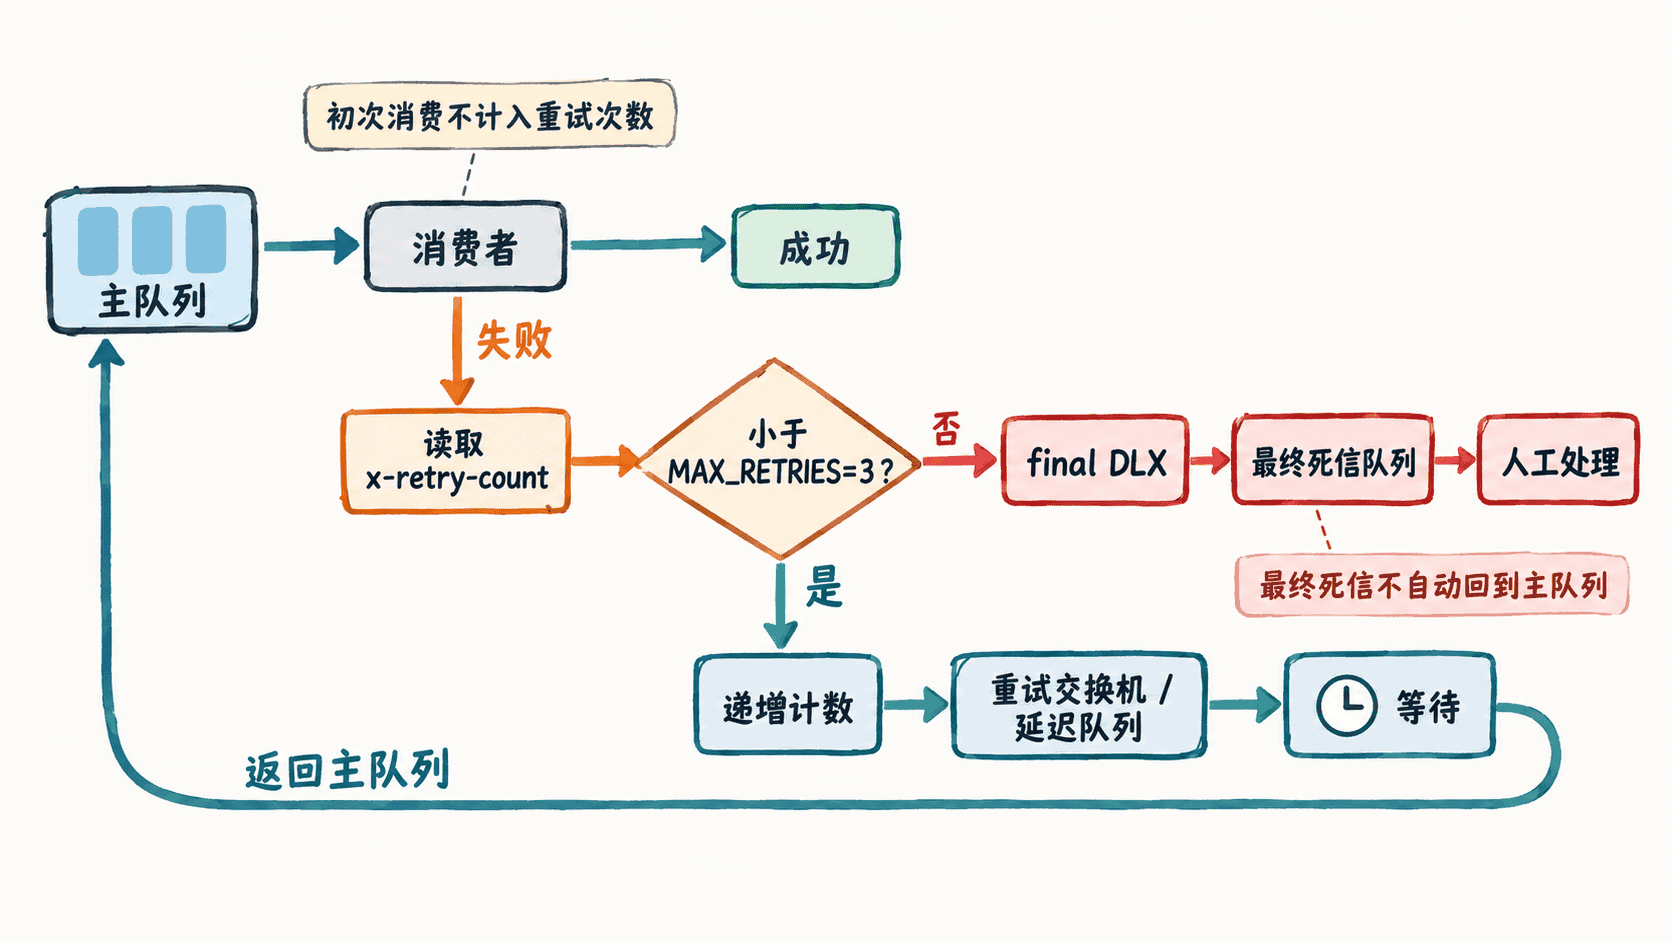
用消息头记录应用级重试次数
下面的 Python 程序只演示计数和分流决策,可直接运行,不连接 RabbitMQ。实际消费者需要把返回的消息头带到重新发布的消息中,并把 retry.exchange、final.dlq 替换为真实拓扑中的目标。
MAX_RETRIES = 3

def decide(headers: dict[str, object]) -> tuple[str, dict[str, object]]:
    retry_count = int(headers.get("x-retry-count", 0))

    # 已经完成最大次数的重试后,不再回到重试链路。
    if retry_count >= MAX_RETRIES:
        return "final.dlq", headers.copy()

    # 只有继续重试时才递增计数。
    next_headers = headers.copy()
    next_headers["x-retry-count"] = retry_count + 1
    return "retry.exchange", next_headers

def main() -> None:
    # 覆盖初次失败、最后一次允许重试、达到上限三种情况。
    for current in (0, 2, 3):
        route, headers = decide({"x-retry-count": current})
        print(
            f"before={current}, route={route}, "
            f"after={headers['x-retry-count']}"
        )

if __name__ == "__main__":
    main()
预期输出
before=0, route=retry.exchange, after=1
before=2, route=retry.exchange, after=3
before=3, route=final.dlq, after=3
实际值由业务策略决定。支付、扣库存等有副作用的操作通常应采用更保守的重试次数,并配合幂等键;网络抖动类操作可以适当多重试,但应使用延迟或退避,避免立即 requeue 形成高频循环。
结合 x-death 与 broker 限制
如果重试链路通过 TTL 和 DLX 往返,RabbitMQ 在 AMQP 0-9-1 消息中会维护 x-death 历史。一个消息可能因为不同队列、不同原因多次死信,因此其中的 count 是按队列和原因记录的,不应把整个数组简单相加后当作统一业务重试次数。
Quorum Queue 还可以设置 broker 级 delivery-limit,用于阻止毒消息长期反复投递。它适合作为第二道保护,但不应替代业务自己的重试计数,因为不同失败方式是否计入 broker 的投递计数与协议行为有关。
超过上限后进入最终处理
最终死信队列应与普通重试队列分开,并且默认不要自动回流。消息进入这里,意味着自动恢复路径已经结束,需要保留足够信息供排查,例如业务消息 ID、原始路由信息、重试次数、最后错误类型和失败时间。
如果确认是永久性业务错误,例如引用了已删除的资源,可以记录原因后归档或丢弃;如果是可修复的数据问题,应先修复根因,再由人工或受控工具重新发布,而不是直接把整个死信队列批量倒回主队列。
发布与确认的可靠性边界
当消费者采用“重新发布到重试交换机,再确认原消息”的方式时,顺序很重要:先等待新消息获得 publisher confirm,再 ack 原消息。若先确认原消息、后发布失败,消息会丢失;若新消息已确认但原消息确认前连接断开,则可能出现重复,因此消费者仍要保证幂等。
有限重试的核心不是“失败三次”这个数字,而是建立明确终点:可恢复错误经过有限、带间隔的重试后成功;不可恢复或持续失败的消息退出自动链路,进入可观察、可审计、可人工处理的最终死信流程。