
消息队列 / 系统课时
消费成功后再确认订单消息
消费成功后再确认订单消息
订单消费者最关键的边界不是“收到消息”,而是“业务结果已经可靠落库”。本节用一个可运行的 RabbitMQ 消费示例,把数据库提交、ACK 和失败处理放到正确顺序,避免订单尚未处理完成却被提前确认。
学习目标
- 理解为什么 ACK 必须发生在数据库事务提交之后
- 能实现成功确认、失败回滚并拒绝消息的处理分支
- 能用日志验证消息确认与业务提交的先后关系
确认点必须放在提交之后
手动确认模式下,RabbitMQ 会一直把消息视为“未确认”,直到消费者发送 ACK。订单处理时应先完成参数校验、数据库写入和事务提交,再执行 ACK;如果在提交前确认,进程随后崩溃,就可能出现“消息已消失、订单却没处理完”的永久丢失。
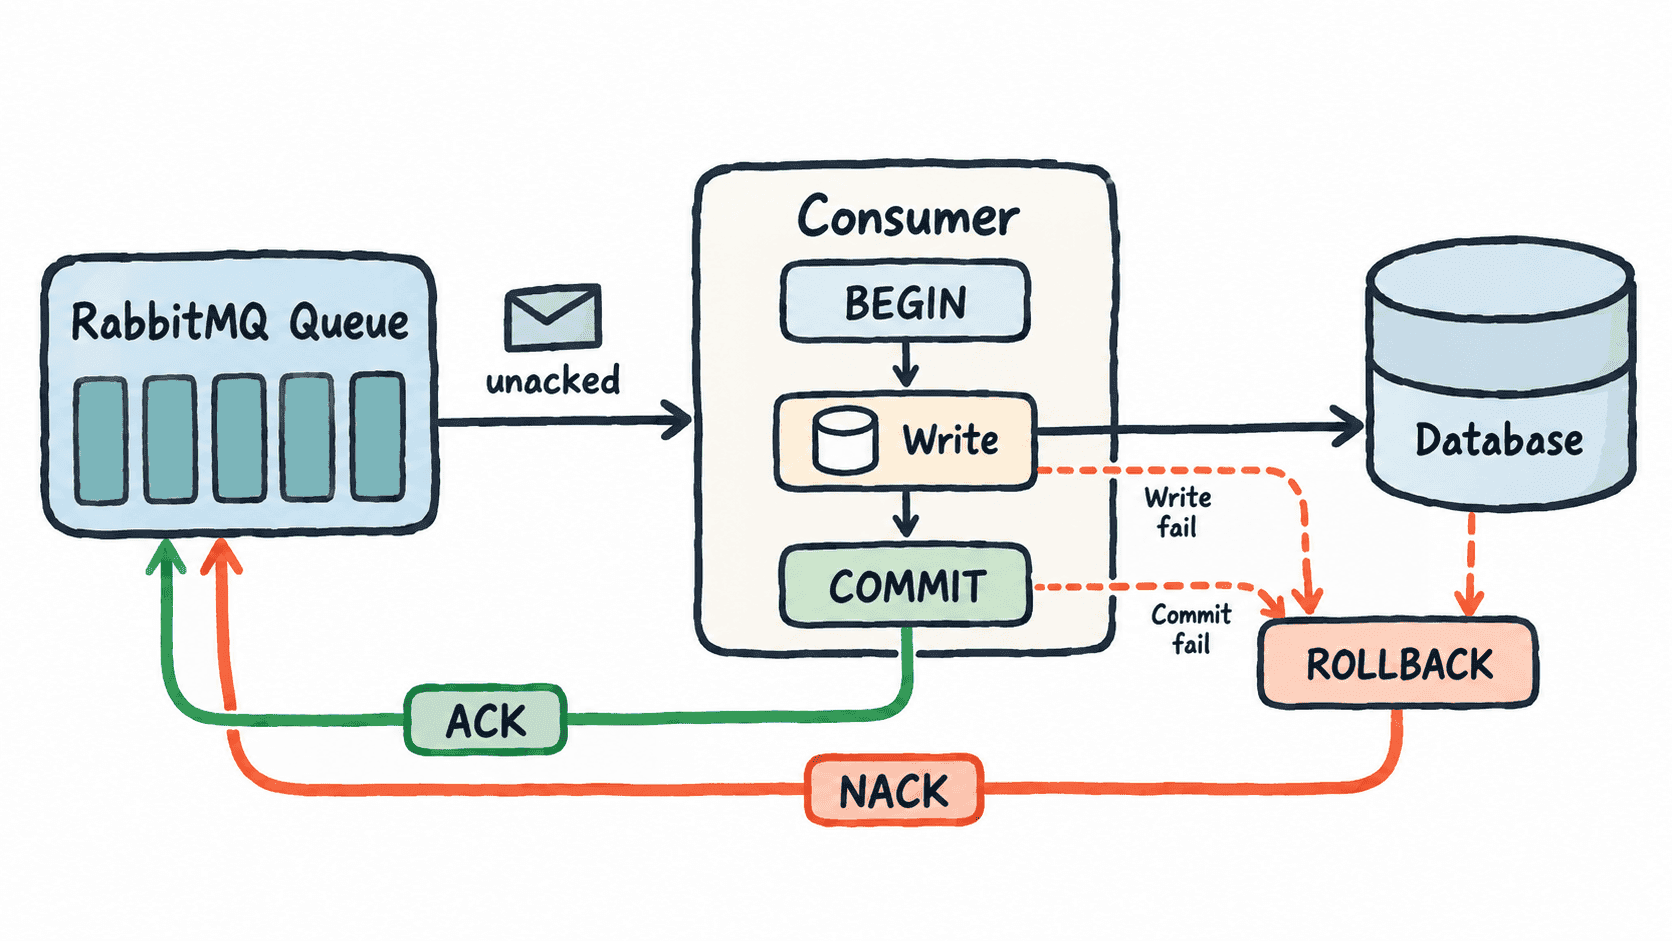
这个顺序解决的是“业务成功后才删除消息”的问题,但它不会自动保证失败消息最终去哪。若执行 basic_nack(..., requeue=False),只有队列已经配置死信交换机时消息才会进入死信链路,否则会被丢弃;生产环境必须明确选择重试、死信或人工补偿策略。
用最小程序验证顺序
下面程序使用 pika 连接本机 RabbitMQ,并用 SQLite 模拟订单数据库。程序先发布一条测试消息,再以 auto_ack=False 拉取它;只有数据库 commit() 成功后才发送 ACK。运行前需要可访问的 RabbitMQ localhost:5672,并已安装 Python 包 pika。
import json
import sqlite3
import uuid

import pika

connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost", port=5672)
)
channel = connection.channel()

# 独占临时队列避免旧测试消息影响本次验证。
queue_name = channel.queue_declare(queue="", exclusive=True).method.queue
order_id = str(uuid.uuid4())
message = json.dumps({"orderId": order_id, "status": "PAID"}).encode()

channel.basic_publish(exchange="", routing_key=queue_name, body=message)
method, _, body = channel.basic_get(queue=queue_name, auto_ack=False)
if method is None:
    raise RuntimeError("未读取到测试消息")

db = sqlite3.connect("order-ack-demo.db")
db.execute(
    "CREATE TABLE IF NOT EXISTS orders "
    "(order_id TEXT PRIMARY KEY, status TEXT NOT NULL)"
)

try:
    payload = json.loads(body.decode())
    db.execute("BEGIN")
    db.execute(
        "INSERT INTO orders(order_id, status) VALUES (?, ?) "
        "ON CONFLICT(order_id) DO UPDATE SET status = excluded.status",
        (payload["orderId"], payload["status"]),
    )
    db.commit()
    print(f"DB COMMIT: order_id={payload['orderId']}, status={payload['status']}")

    # 事务提交成功后再确认消息。
    channel.basic_ack(delivery_tag=method.delivery_tag)
    print(f"ACK: delivery_tag={method.delivery_tag}")
except Exception as exc:
    db.rollback()
    channel.basic_nack(delivery_tag=method.delivery_tag, requeue=False)
    print(f"NACK: {type(exc).__name__}")
finally:
    db.close()
    connection.close()
预期输出:
DB COMMIT: order_id=<ID>, status=PAID
ACK: delivery_tag=<ID>
其中订单 ID 和 delivery_tag 的实际值每次运行可能不同。关键验证点是 DB COMMIT 必须先于 ACK 出现。
失败分支要保证事务和消息状态一致
数据库写入、业务校验或提交发生异常时,不应继续 ACK。示例先执行 rollback(),再发送 basic_nack(..., requeue=False),这样至少能保证“数据库没有成功提交时,不把消息当成成功消费”。
若错误属于数据库短暂不可用,可以设计有限次数重试,但不要简单无限 requeue=True,否则同一坏消息可能立即反复投递形成热循环。更稳妥的做法是结合死信队列、延迟重试次数和告警,把可恢复故障与永久业务错误分开处理。
验证可靠性边界
可以在 db.commit() 之前主动抛出异常,确认输出走 NACK 分支且数据库没有新增订单;再恢复代码验证成功路径。还应记住,进程可能在“数据库已经提交、ACK 尚未送达”之间崩溃,这时 RabbitMQ 会重新投递同一消息,因此仅把 ACK 放对位置还不够,订单业务仍需要幂等保护。