
消息队列 / 系统课时
requeue 为什么可能形成死循环
requeue 为什么可能形成死循环
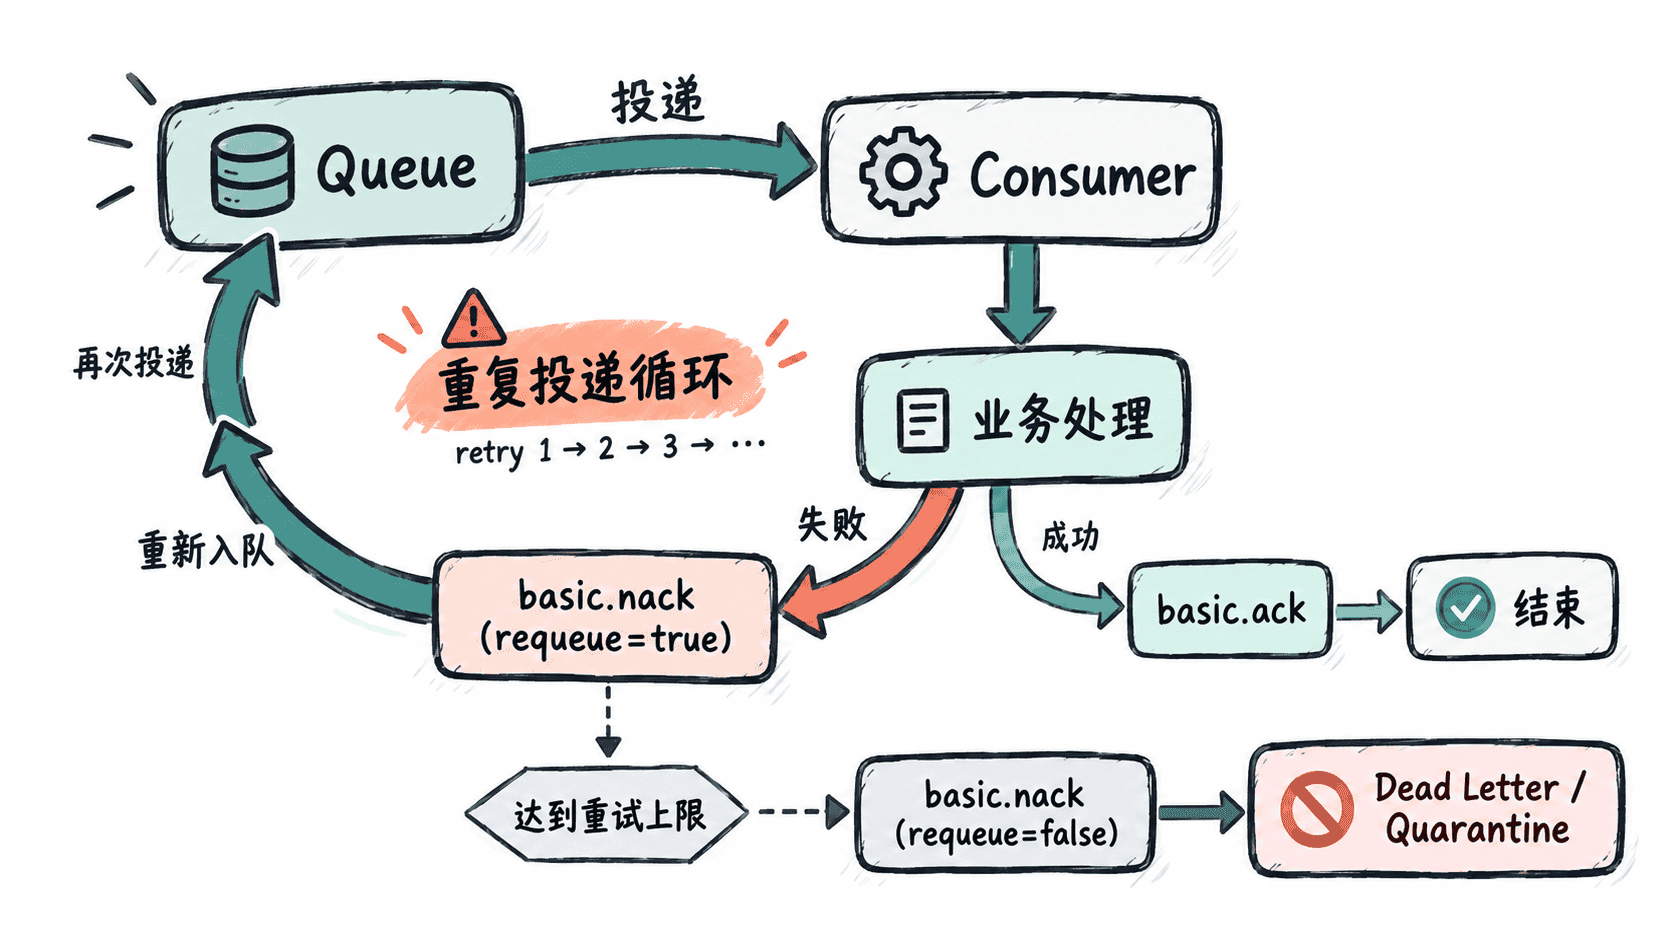
requeue=true 看起来像“失败后再试一次”,但 RabbitMQ 并不会自动限制同一条消息被重新投递多少次。如果业务错误是确定性的,Consumer 每次收到它都会再次失败、再次入队,最终形成高速重投递循环,持续占用 CPU、网络和消费并发。
学习目标
- 看懂“消费失败 → 重新入队 → 再次消费”的循环如何形成
- 区分暂时性故障与确定性坏消息
- 能设计带次数上限或隔离出口的失败处理路径
死循环是怎样形成的
最常见的危险写法,是捕获所有异常后统一执行 basic.nack(..., requeue=true)。下面是 Java RabbitMQ Client 的片段示例,假设已经处于手动确认的消费回调中。
long deliveryTag = delivery.getEnvelope().getDeliveryTag();

try {
    process(delivery.getBody());
    channel.basicAck(deliveryTag, false);
} catch (Exception ex) {
    // 如果 process 对这条消息每次都会失败,这里会不断把它送回队列。
    channel.basicNack(deliveryTag, false, true);
}这段逻辑对短暂故障可能有效,例如下游服务刚好超时一次;但如果消息本身格式非法,process 每次都会失败,那么重新入队并不会改变任何条件。
为什么它会拖垮消费者
循环中的每一次重投递都是真实的消息传输和业务执行。若队列里混入少量“必定失败”的消息,它们可能反复抢占 Consumer 的处理机会,使正常消息延迟升高。
在多个 Consumer 并发时,重新入队的消息还可能被另一个 Consumer 立即取走。它不保证回到原来的消费位置,因此实际表现可能是同一条坏消息在多个实例之间高速流转,而不是安静地排到队尾等待。
RabbitMQ 的 redeliver 标志可以帮助判断消息是否可能被再次投递,但它不是“重试次数计数器”,不能直接拿来实现最多重试 N 次的完整策略。
哪些错误适合重试
判断 requeue 前,先判断失败是否有机会因为“外部条件变化”而恢复。
暂时性故障包括数据库短暂不可用、HTTP 下游超时、限流或网络抖动。这类错误可以重试,但应配合退避和次数上限。确定性错误包括 JSON 结构损坏、业务字段非法、无法识别的版本号。这类消息再次执行通常仍会失败,应尽快退出主消费链路。
给失败处理加出口
更稳妥的做法通常是把失败分成三种结果:成功就 ACK;可恢复错误进入有限重试;超过上限或确定性错误不再重新入队,并转到死信队列或隔离队列。
如果需要延迟重试,可以使用重试队列配合 TTL 与死信路由,或由应用记录重试次数后重新发布。无论采用哪种方式,都应确保主队列中的同一条消息不会无限立即回流。
验证这套设计时,可以故意发送一条必定失败的测试消息,观察它是否只重试预期次数,最终离开主队列;同时确认正常消息仍能持续被消费。这样才能证明系统真正摆脱了 requeue 死循环。