
消息队列 / 系统课时
单节点队列故障时会发生什么
单节点队列故障时会发生什么
当一个队列的数据只存在于单个 RabbitMQ 节点时,这个节点就是队列的故障边界。节点宕机后,真正要区分的是“暂时不可用”“重启后可恢复”和“永久丢失”,而不是只看队列是否声明为 durable。
学习目标
- 说明单副本队列在节点宕机、重启和磁盘损坏时的不同后果
- 区分 durable、持久化消息、publisher confirm 与数据复制的职责
- 理解 Quorum Queue 为什么能改变单节点故障下的可用性模型
单副本队列的故障边界
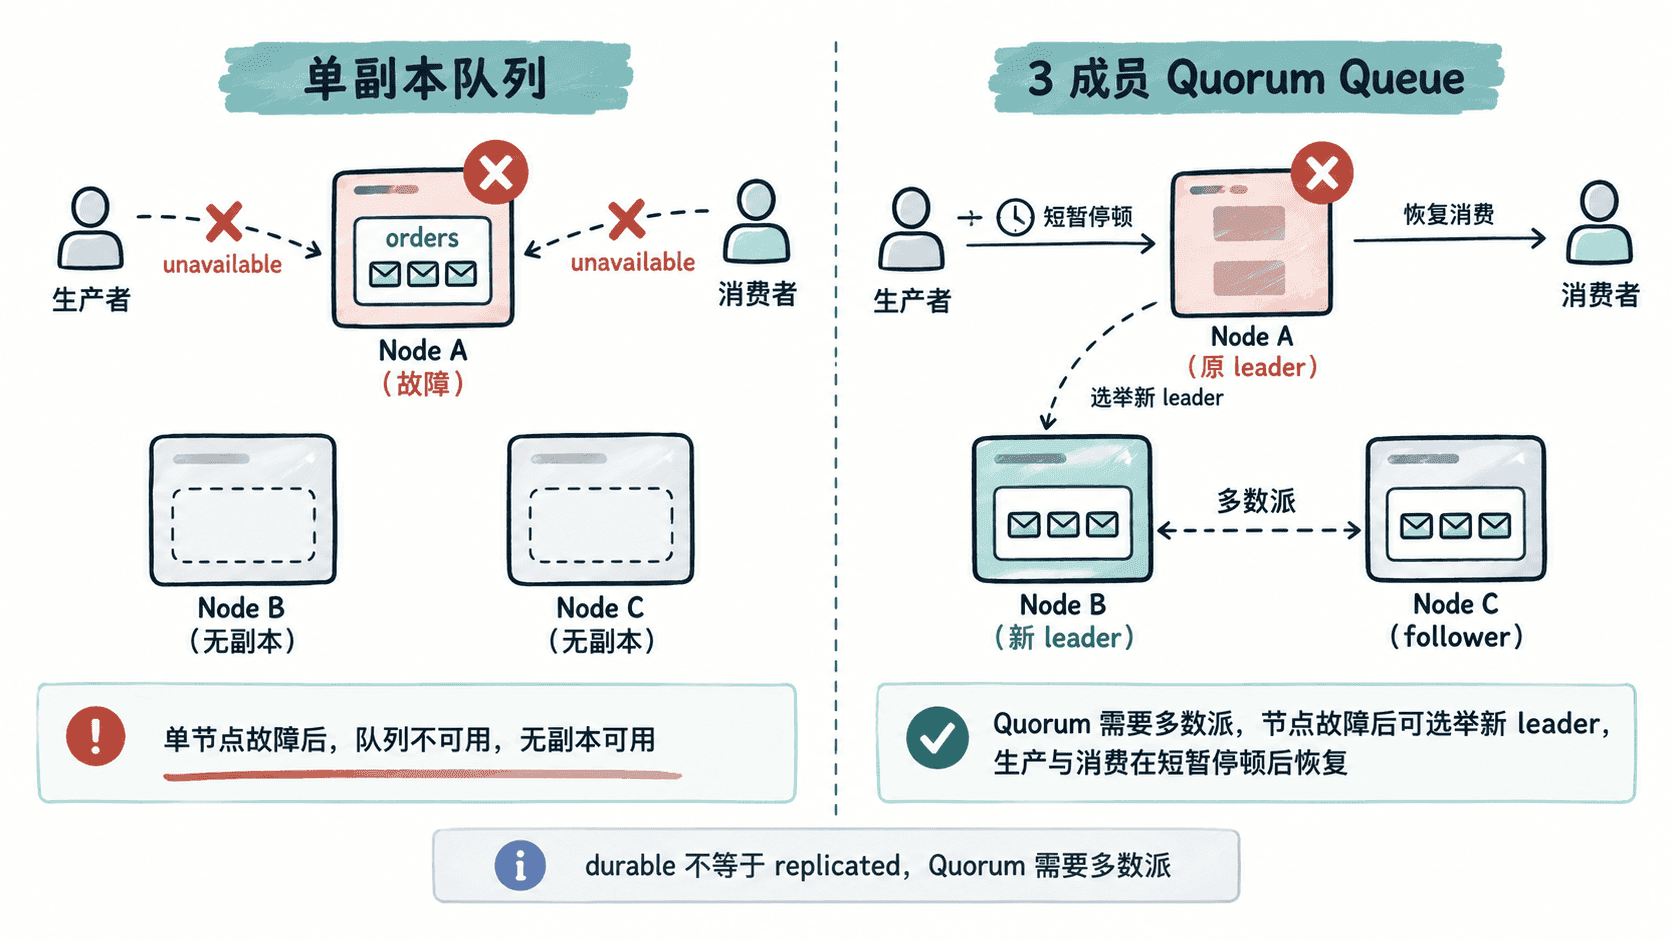
如果队列内容只保存在节点 A 上,即使 RabbitMQ 集群中的交换机、绑定等定义能在其他节点看到,队列消息本身也没有第二份可接管的副本。节点 A 不可达时,这个队列会不可用;生产者或消费者即使连到了仍在线的节点,也不能凭空从另一台机器读取那份消息数据。
如果只是进程重启,而节点磁盘完整,durable 队列配合需要跨重启保存的消息,可以在节点恢复后重新出现。若承载唯一副本的节点或磁盘永久损坏,则没有其他副本可用于恢复,数据安全取决于外部备份或业务补偿。
持久化和复制解决的是不同问题
durable 主要描述队列定义能否跨 broker 重启存在;消息是否需要跨重启保存,还取决于消息的持久化语义。publisher confirm 用于让发布端知道消息是否被 RabbitMQ 接受并按对应队列机制完成确认,但它不会把单副本队列自动变成多副本。
因此,“durable 队列 + 持久化消息 + confirm”可以显著降低进程重启或发布链路上的丢失风险,却仍然留下单机、单磁盘这一故障点。高可用与数据冗余需要复制型队列,而不是继续堆叠单节点持久化选项。
用 CLI 识别不可用队列
在多节点集群中,如果 rabbitmqctl 能连接到仍在线的节点,可以列出当前 leader 所在节点不可用的 durable 队列。下面的命令查询默认 vhost /:
rabbitmqctl -p / list_queues --offline name type state预期输出示例:
name	type	state
orders	classic	down
实际队列名和类型会不同;如果没有离线队列,结果只会保留表头或为空。这里的关键不是把 down 当作“消息已经丢失”,而是先确认队列当前无法提供服务,再结合故障节点的磁盘状态判断它是可恢复停机还是永久数据损失。
Quorum Queue 改变了什么
Quorum Queue 会把一个队列维护为多个成员副本,并通过多数派维持一致状态。典型的 3 成员 Quorum Queue 在其中 1 个节点故障、其余 2 个成员仍可通信时,可以选举新的 leader;投递可能短暂停顿,但不再依赖原节点重新启动后才能继续服务。
这种复制也有边界:如果可用成员不足多数派,队列会停止提供正常服务,以避免多个分区各自接受冲突的数据。对于重要消息,仍应配合 publisher confirm、手动消费确认和幂等处理,因为节点故障可能导致连接重建、未确认消息重新投递等正常恢复行为。
判断方案时可以用一句话区分:持久化解决“同一份数据在重启后还在不在”,复制解决“承载这一份数据的节点坏了以后,还有没有另一份可继续工作”。只要业务不能接受单节点恢复期间的停机或永久磁盘损坏带来的风险,就不应把单副本队列当作高可用方案。