
消息队列 / 系统课时
同步等待 Confirm 有什么代价
同步等待 Confirm 有什么代价
同步等待 Confirm 最容易写对,但它会把“发送消息”变成“发送一条,再等一次 Broker 往返”。当每次只有一条消息在途时,网络 RTT 和 Broker 确认延迟直接落到每条消息上,因此吞吐量往往远低于 RabbitMQ 本身的处理能力。
学习目标
- 理解逐条同步 Confirm 为什么会限制吞吐量
- 能用
waitForConfirms测量逐条等待的执行时间 - 知道何时应改用批量等待或异步 Confirm
逐条等待会把往返延迟串起来
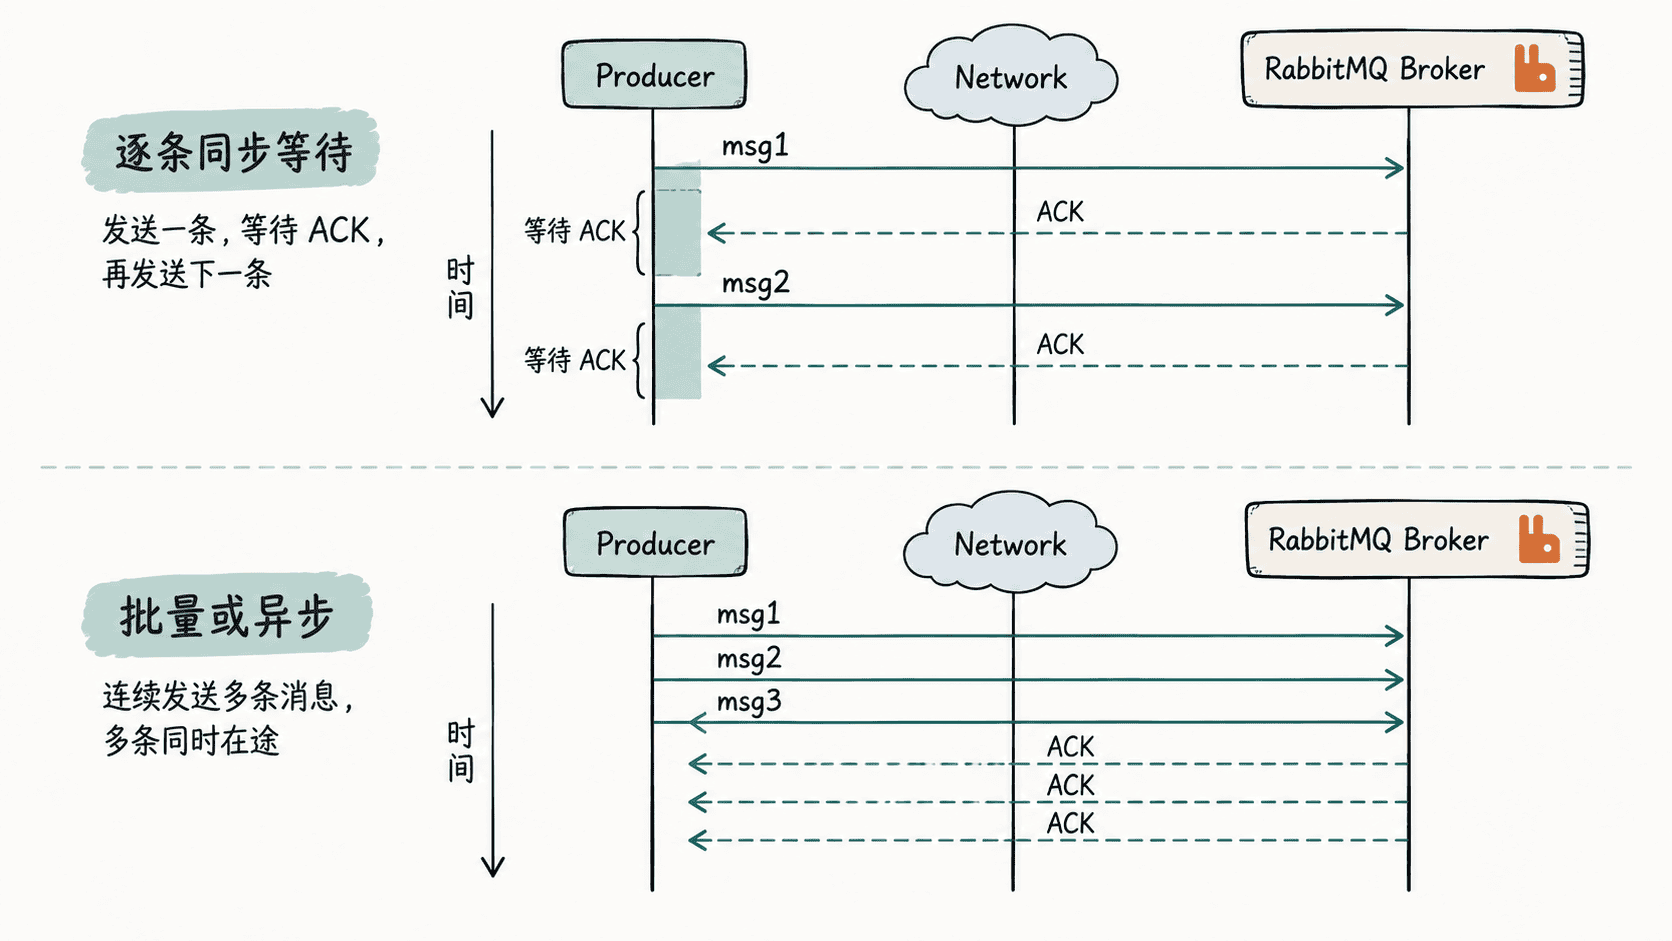
最直接的写法是:basicPublish 发送一条消息,随后立即调用 waitForConfirms,确认返回后才发送下一条。此时同一 Channel 上几乎只有 1 条未确认消息,生产者无法利用网络和 Broker 的流水线能力。
如果一次确认往返平均需要 RTT 秒,那么这种模式的吞吐上限可粗略看成 。例如 RTT 为 2 ms 时,上限约为 500 条/秒;RTT 为 10 ms 时,则只剩约 100 条/秒。真实环境还会叠加序列化、线程调度、磁盘或副本确认等开销。
用 waitForConfirms 观察代价
下面示例发送 100 条消息,并在每次 basicPublish 后立即等待确认。它适合用来观察“逐条同步”的结构性成本,不适合作为高吞吐生产代码。运行前请确保本机 RabbitMQ 已启动,且项目已经加入 RabbitMQ Java Client 依赖。
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

import java.nio.charset.StandardCharsets;

public class SyncConfirmCostDemo {
    public static void main(String[] args) throws Exception {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("localhost");

        try (Connection connection = factory.newConnection();
             Channel channel = connection.createChannel()) {

            String queue = channel.queueDeclare("", false, true, true, null).getQueue();
            channel.confirmSelect();

            int messageCount = 100;
            long start = System.nanoTime();

            for (int i = 1; i <= messageCount; i++) {
                byte[] body = ("message-" + i).getBytes(StandardCharsets.UTF_8);
                channel.basicPublish("", queue, null, body);

                // 每条消息都等待确认,下一条发布无法提前进入流水线。
                boolean confirmed = channel.waitForConfirms(5_000);
                if (!confirmed) {
                    throw new IllegalStateException("第 " + i + " 条消息收到 NACK");
                }
            }

            long elapsedNanos = System.nanoTime() - start;
            long elapsedMs = elapsedNanos / 1_000_000;
            double rate = messageCount * 1_000_000_000.0 / elapsedNanos;

            System.out.printf(
                    "发送 %d 条并逐条确认,总耗时 %d ms,平均吞吐 %.1f msg/s%n",
                    messageCount,
                    elapsedMs,
                    rate
            );
        }
    }
}
预期输出
发送 100 条并逐条确认,总耗时 <TIME> ms,平均吞吐 <RATE> msg/s<TIME> 和 <RATE> 会随本机负载、RabbitMQ 配置、网络延迟和存储方式变化。这里需要关注的是模式:即使单次确认只多等待几毫秒,重复 100 次后也会线性累积。
批量等待怎样摊薄 RTT
一种简单改进是先连续发送一批消息,再调用一次 waitForConfirms。这样一批消息可以同时在途,单次 RTT 被多条消息共同摊薄。代价是失败定位会变粗:只要这一批里出现 NACK,就需要知道哪些消息仍未被确认,才能安全重试。
异步 Confirm 进一步取消“发送线程等待确认”的阻塞。生产者持续发布,确认回调根据发布序号移除待确认记录,通常能获得更高吞吐,但代码也需要处理并发状态、超时、NACK 和连接中断。
| 模式 | 在途消息 | 实现复杂度 | 典型取舍 |
|---|---|---|---|
| 每条同步等待 | 通常 1 条 | 最低 | 易理解,但吞吐受 RTT 强约束 |
| 批量同步等待 | 一批 | 中等 | 吞吐更高,失败定位需要额外处理 |
| 异步 Confirm | 多条持续在途 | 最高 | 吞吐最好,需要可靠的序号跟踪与超时处理 |
什么时候同步等待仍然合适
逐条同步 Confirm 并不是错误方案。低频管理脚本、教学演示、吞吐量要求很低但实现越简单越好的任务,都可以接受这种写法。它的问题出现在高频发布链路:当生产者本可连续发送时,却主动把每次网络往返串行化。
因此,判断标准不是“能不能收到 ACK”,而是“业务吞吐是否允许每条消息都支付一次等待成本”。只要确认等待已经成为瓶颈,就应优先考虑批量 Confirm 或异步 Confirm,而不是继续堆发送线程。