
消息队列 / 系统课时
手动 ACK 应该放在哪里
手动 ACK 应该放在哪里
手动 ACK 的关键不是把 basic_ack 写进回调函数,而是让它准确落在业务成功边界之后:数据库事务已经提交、必要操作已经完成,再告诉 RabbitMQ 可以删除消息。ACK 太早会丢消息,太晚则可能产生重复处理。
学习目标
- 根据业务成功边界确定手动 ACK 的正确位置
- 使用
auto_ack=False在业务提交成功后发送 ACK - 理解处理失败、重新入队以及重复消费之间的关系
ACK 应该对应业务成功边界
对于需要可靠处理的消息,消费者通常采用 auto_ack=False。RabbitMQ 投递消息后会暂时保留其未确认状态,只有收到消费者针对该 delivery_tag 发出的确认后,才认为这次处理完成。
如果消费者在 ACK 之前断开连接,尚未确认的消息可以重新进入可投递状态,由当前或其他消费者再次处理。因此,ACK 最合理的位置通常是不可丢失的业务结果已经成功落地之后。
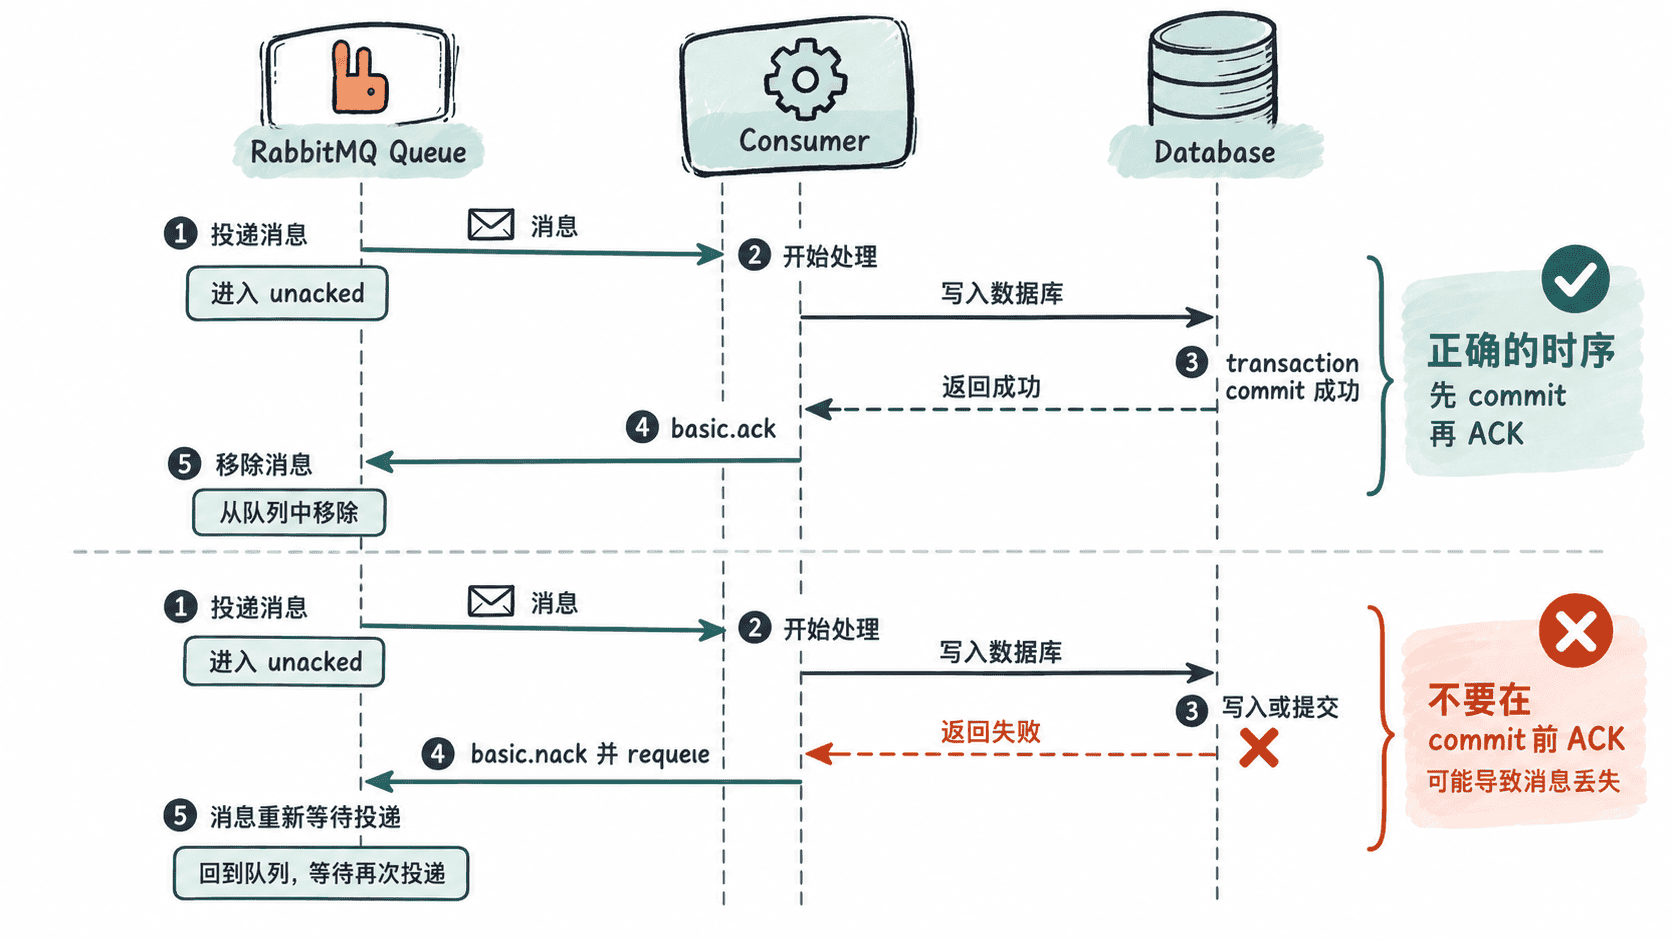
把 ACK 放到提交之后
下面示例用 SQLite 模拟数据库业务写入。程序发布一条测试消息,消费者开启手动确认;只有 with db: 块正常结束、事务提交成功后,才调用 basic_ack。同时使用消息 ID 唯一约束,让重复投递时不会重复插入同一业务记录。
import sqlite3
import pika

QUEUE = "ack-manual-demo"
MESSAGE_ID = "order-1001"

db = sqlite3.connect("orders.db")
db.execute(
    """
    CREATE TABLE IF NOT EXISTS processed_messages (
        message_id TEXT PRIMARY KEY
    )
    """
)
db.commit()

connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost")
)
channel = connection.channel()
channel.queue_declare(queue=QUEUE, durable=False)
channel.queue_purge(queue=QUEUE)
channel.basic_qos(prefetch_count=1)

channel.basic_publish(
    exchange="",
    routing_key=QUEUE,
    body=MESSAGE_ID.encode(),
)


def on_message(ch, method, properties, body):
    message_id = body.decode()

    try:
        # 退出 with 块时事务提交成功,随后才能确认消息。
        with db:
            db.execute(
                "INSERT OR IGNORE INTO processed_messages(message_id) VALUES (?)",
                (message_id,),
            )

        ch.basic_ack(delivery_tag=method.delivery_tag)
        print(f"committed and acked: {message_id}", flush=True)
        ch.stop_consuming()
    except Exception:
        # 业务没有完成时不应 ACK;这里让消息重新进入可投递状态。
        ch.basic_nack(delivery_tag=method.delivery_tag, requeue=True)
        ch.stop_consuming()
        raise


channel.basic_consume(
    queue=QUEUE,
    on_message_callback=on_message,
    auto_ack=False,
)
channel.start_consuming()

row = db.execute(
    "SELECT message_id FROM processed_messages WHERE message_id = ?",
    (MESSAGE_ID,),
).fetchone()
state = channel.queue_declare(queue=QUEUE, passive=True)

print(f"db row: {row[0]}")
print(f"queue ready: {state.method.message_count}")

connection.close()
db.close()
预期输出
committed and acked: order-1001
db row: order-1001
queue ready: 0这里最重要的顺序是:业务提交成功 → ACK。如果 SQLite 提交抛出异常,代码会进入异常分支并执行 basic_nack(..., requeue=True),而不是把尚未完成的业务误报为成功。
失败时不要无条件确认
把 ACK 写进 finally 是常见错误,因为 finally 无论成功还是异常都会执行。这样即使数据库写入失败、远程接口超时,RabbitMQ 仍可能收到 ACK,最终效果与提前确认没有区别。
对于暂时性错误,可以选择 basic_nack 或 basic_reject 并重新入队;对于格式错误、永久失败等不可恢复问题,则不应无限重试,通常要结合重试次数和死信队列处理。
ACK 之后仍要防重复处理
手动 ACK 解决的是“业务没完成却把消息删掉”的问题,但不能保证绝对只处理一次。一个典型边界是:数据库已经提交成功,消费者却在发送 ACK 之前崩溃。RabbitMQ 看不到确认,就可能再次投递同一消息。
因此可靠消费者通常同时具备两层保护:先让业务操作具备幂等性,再在业务成功后发送 ACK。数据库唯一键、业务状态检查或消息 ID 去重都可以用于实现幂等。这样即使发生重复投递,也不会把同一笔业务重复执行。