
消息队列 / 系统课时
用死信队列实现延迟重试
用死信队列实现延迟重试
业务消费失败后如果直接使用 requeue=true,消息可能立刻再次投递,形成高频失败循环。更稳妥的基础做法是把失败消息送入重试队列,停留一段 TTL,再由 DLX 路由回业务队列,从而得到可控的延迟重试。
学习目标
- 理解业务队列、重试队列、TTL 与 DLX 如何组成延迟重试链路。
- 能用
basic_nack(..., requeue=False)触发失败消息进入死信路由。 - 能识别无限重试、路由键不匹配和多延迟级别等边界问题。
重试链路如何工作
业务队列负责正常消费;消费失败时,消息通过业务队列配置的 DLX 进入重试队列。重试队列不启动消费者,只设置消息 TTL;TTL 到期后,消息再次成为死信,并通过重试队列的 DLX 路由回业务队列。消费成功后正常 ack,链路结束。
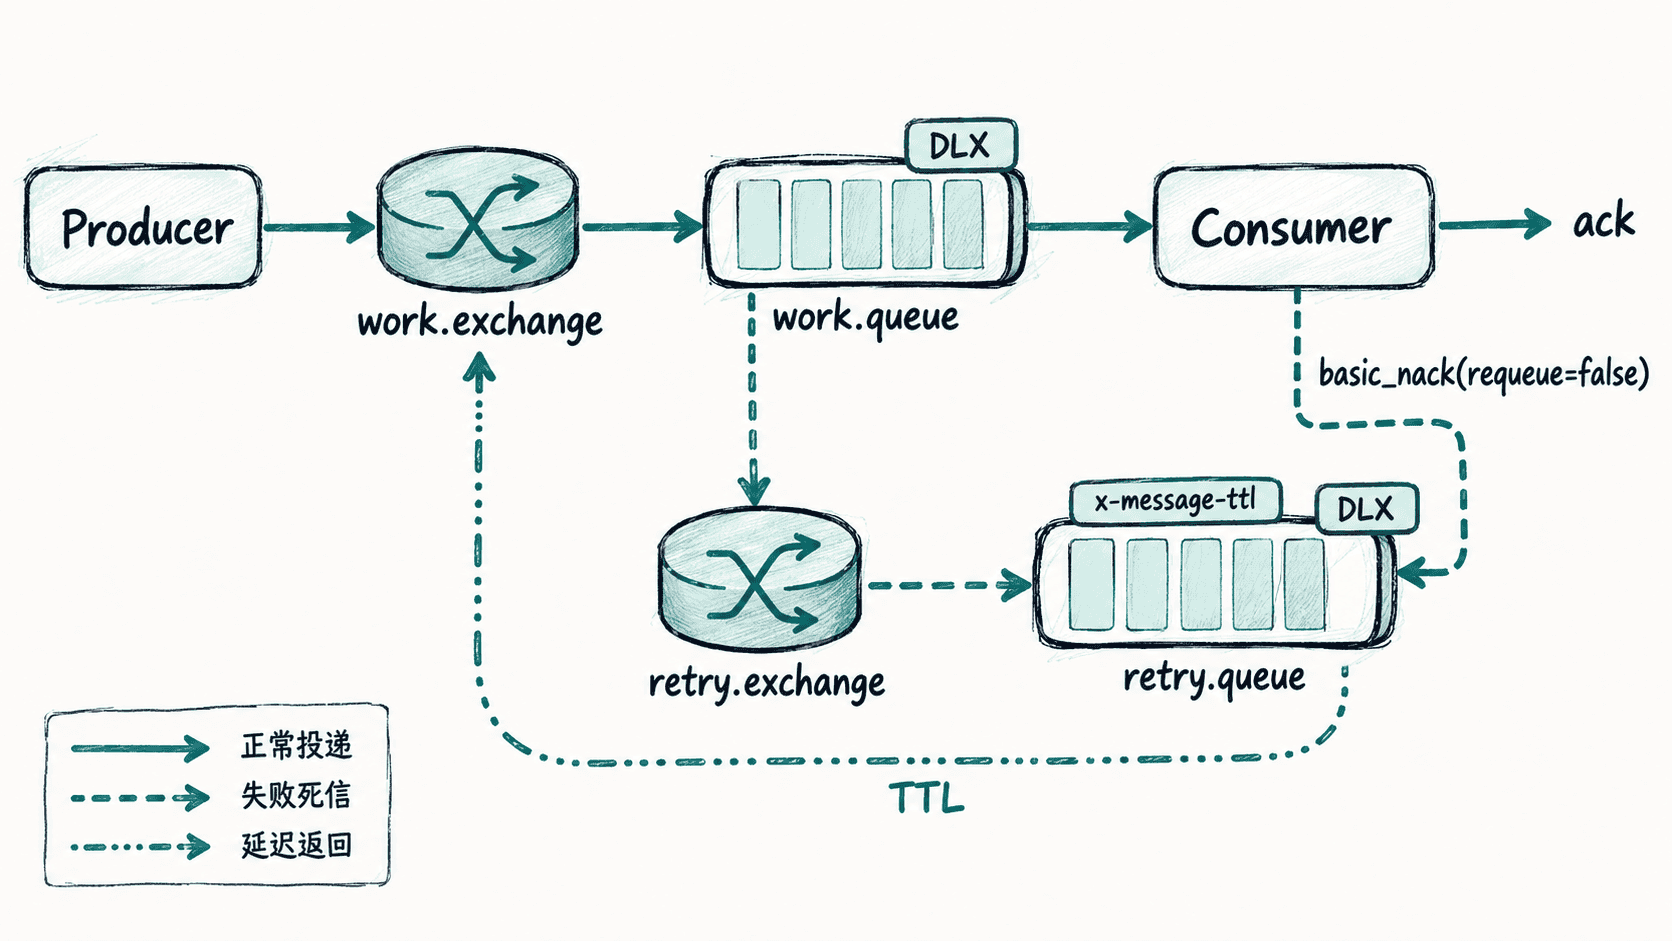
这个结构把“等待”放在 Broker 中完成,消费者线程不需要 sleep,也不会因为立即重入同一业务队列而持续打满 CPU、日志或下游服务。
搭建最小可运行示例
下面示例要求本机 RabbitMQ 可通过 localhost:5672 访问,并已安装 pika。程序让前两次处理主动失败,第三次成功;重试队列 TTL 为 3 秒,因此两次失败之间会出现明显等待。
import uuid
import pika

def as_text(value):
    return value.decode() if isinstance(value, bytes) else value

suffix = uuid.uuid4().hex[:8]
work_exchange = f"demo.work.ex.{suffix}"
retry_exchange = f"demo.retry.ex.{suffix}"
work_queue = f"demo.work.q.{suffix}"
retry_queue = f"demo.retry.q.{suffix}"

connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost")
)
channel = connection.channel()

channel.exchange_declare(exchange=work_exchange, exchange_type="direct")
channel.exchange_declare(exchange=retry_exchange, exchange_type="direct")

channel.queue_declare(
    queue=work_queue,
    arguments={
        "x-dead-letter-exchange": retry_exchange,
        "x-dead-letter-routing-key": "retry",
    },
)
channel.queue_bind(
    queue=work_queue,
    exchange=work_exchange,
    routing_key="work",
)

channel.queue_declare(
    queue=retry_queue,
    arguments={
        "x-message-ttl": 3000,
        "x-dead-letter-exchange": work_exchange,
        "x-dead-letter-routing-key": "work",
    },
)
channel.queue_bind(
    queue=retry_queue,
    exchange=retry_exchange,
    routing_key="retry",
)

def rejected_count(properties):
    headers = properties.headers or {}
    for item in headers.get("x-death", []):
        if (
            as_text(item.get("queue")) == work_queue
            and as_text(item.get("reason")) == "rejected"
        ):
            return int(item.get("count", 0))
    return 0

def handle(ch, method, properties, body):
    attempt = rejected_count(properties) + 1
    print(f"attempt={attempt}")

    if attempt < 3:
        print("result=failed -> retry queue")
        ch.basic_nack(delivery_tag=method.delivery_tag, requeue=False)
        return

    print("result=success")
    ch.basic_ack(delivery_tag=method.delivery_tag)
    ch.stop_consuming()

channel.basic_qos(prefetch_count=1)
channel.basic_consume(queue=work_queue, on_message_callback=handle)
channel.basic_publish(
    exchange=work_exchange,
    routing_key="work",
    body=b"order-1001",
)

channel.start_consuming()

channel.queue_delete(queue=work_queue)
channel.queue_delete(queue=retry_queue)
channel.exchange_delete(exchange=work_exchange)
channel.exchange_delete(exchange=retry_exchange)
connection.close()
预期输出
attempt=1
result=failed -> retry queue
attempt=2
result=failed -> retry queue
attempt=3
result=success
第二次和第三次 attempt 不会紧跟上一行立即出现,中间会受 3 秒 TTL 影响。实际调度可能略有误差,因此这里关注“不会立刻重新消费”,而不是把 RabbitMQ 当作毫秒级定时器。
延迟真正由哪两处配置形成
业务队列上的 x-dead-letter-exchange 决定失败消息去哪里。只有拒绝或否定确认时使用 requeue=False,消息才会按死信规则离开当前队列;若使用 requeue=True,它通常会直接回到原队列,延迟链路就被绕开了。
重试队列上的 x-message-ttl 决定等待多久,而它自己的 x-dead-letter-exchange 决定等待结束后回到哪里。这个重试队列通常不配置消费者,否则消息可能在 TTL 到期前就被取走。
控制重试次数与延迟层级
示例通过 RabbitMQ 自动维护的 x-death 头统计业务队列因 rejected 产生的死信次数,所以第三次处理时可以停止失败。真实业务不应无限循环:达到最大次数后,应转入失败队列、人工处理流程或其他明确的终止路径。
如果需要 5 秒、30 秒、5 分钟等不同退避时间,常见做法是准备多个固定 TTL 的重试队列,每一级都有自己的 DLX。不要把大量不同 TTL 的消息简单混进同一个普通 FIFO 重试队列并假设每条都能精确定时返回;分级队列更容易观察和预测。
验收时检查什么
运行示例时应看到同一条消息经历三次消费,前两次失败后不会立即重投,而是在重试队列中等待 TTL。第三次成功 ack 后链路停止。如果实际系统仍然快速刷屏,优先检查失败分支是否误用了 requeue=True,再检查业务队列和重试队列的 DLX、绑定键以及 TTL 是否声明在正确的队列上。