
消息队列 / 系统课时
Prefetch 设置太大有什么问题
Prefetch 设置太大有什么问题
Prefetch 决定消费者在确认之前最多可以持有多少条未确认消息。把它设得很大,短期看似能减少等待,但会把大量消息提前压到单个消费者,放大内存占用、分配不均和故障重投递,吞吐反而可能更不稳定。
学习目标
- 理解过大 Prefetch 如何增加未确认消息与客户端缓冲压力
- 识别慢消费者“囤消息”造成的任务分配不均
- 根据失败代价和并发能力把 Prefetch 调回可控范围
过大的本质是把队列搬到消费者旁边
RabbitMQ 只会继续向消费者投递未超过 Prefetch 上限的消息。若设为 1000,一个消费者最多可以同时占有大量尚未 ack 的投递。它们虽然已经离开 Ready 状态,却还没有真正完成业务处理。
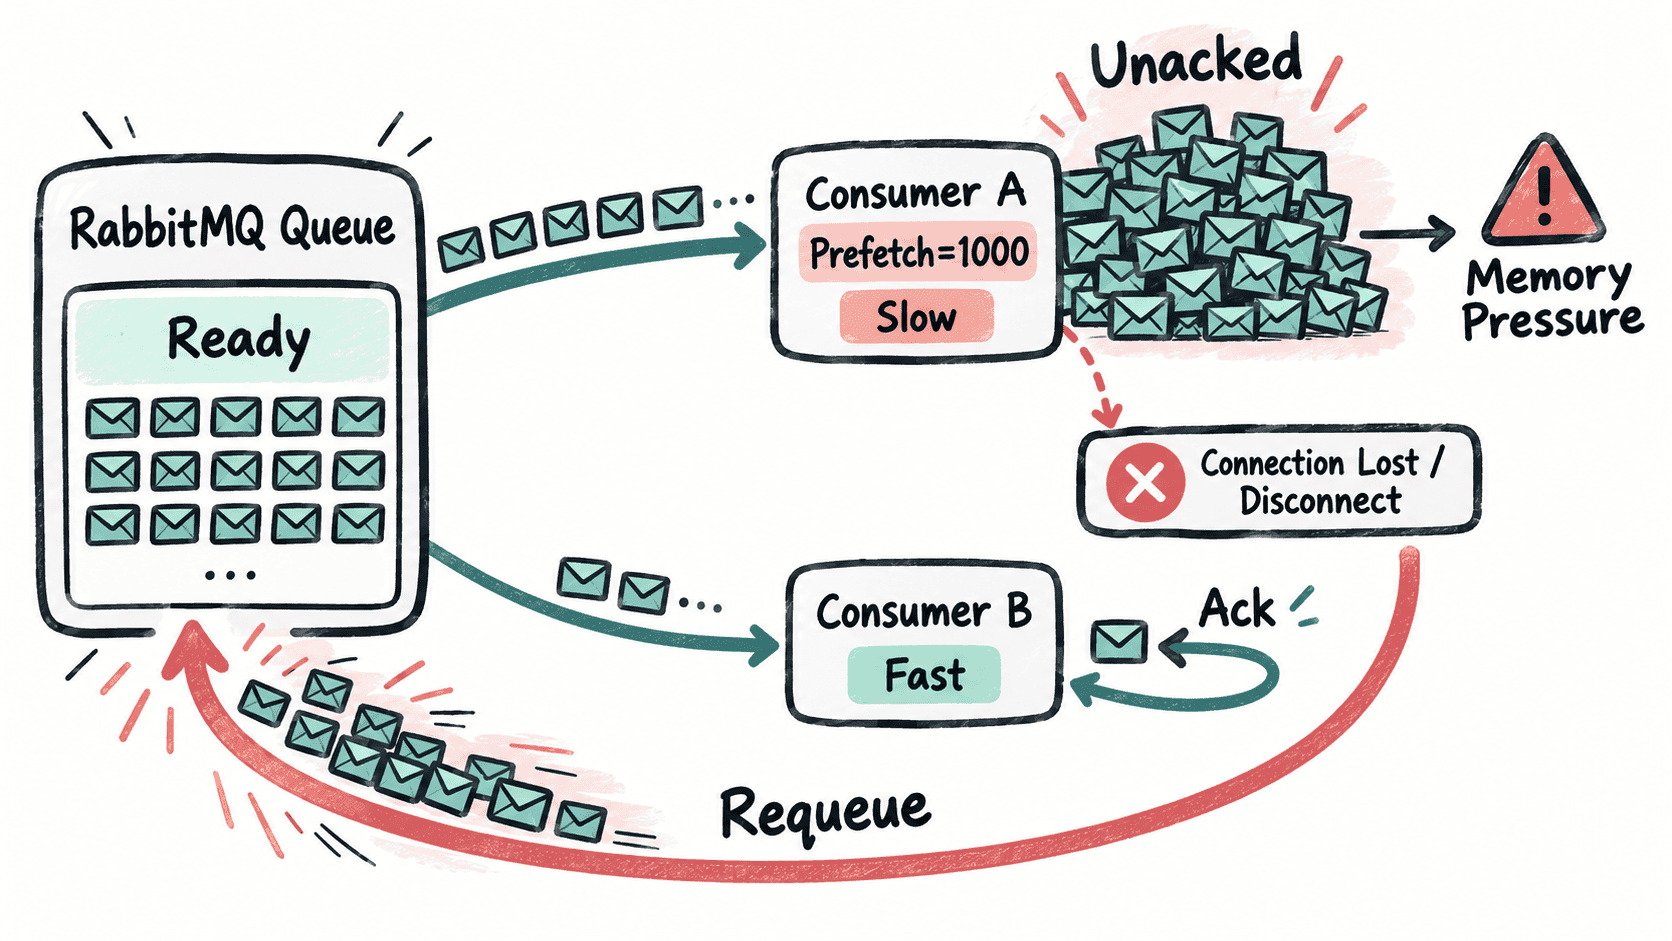
对长耗时任务,这种“提前搬运”尤其危险:客户端需要保存更多消息对象;Broker 需要维护更多未确认投递状态;如果消费者突然断线,这批未确认消息会重新入队,瞬间形成较大的 redelivery 波峰。
慢消费者会更容易囤住任务
Prefetch 很大时,Broker 可以在消费者刚建立连接时一次向它发送很多消息。若不同消费者处理速度差异明显,较慢的一方可能已经占住大量任务,而较快的一方随后空闲,造成“队列看起来不忙,但某个消费者很忙”的现象。
下面的示例会先发布 20 条任务,再用 prefetch_count=1000 逐条慢速处理。运行前需有本机 RabbitMQ,并已安装 pika。
import time
import pika

QUEUE = "prefetch-large-demo"
TOTAL = 20
PREFETCH = 1000

connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost")
)
channel = connection.channel()
channel.queue_declare(queue=QUEUE, durable=False)
channel.queue_purge(queue=QUEUE)

# 先放入一批小消息,便于观察消费者持有的未确认投递。
for i in range(TOTAL):
    channel.basic_publish(
        exchange="",
        routing_key=QUEUE,
        body=f"task-{i}".encode(),
    )

channel.basic_qos(prefetch_count=PREFETCH)
processed = 0
print(f"published={TOTAL}, prefetch={PREFETCH}")

def on_message(ch, method, properties, body):
    global processed
    processed += 1
    if processed == 1:
        print(f"first={body.decode()}")

    # 故意放慢处理,制造 Unacked 窗口。
    time.sleep(0.2)
    ch.basic_ack(delivery_tag=method.delivery_tag)

    if processed == TOTAL:
        print(f"processed={processed}")
        ch.stop_consuming()

channel.basic_consume(
    queue=QUEUE,
    on_message_callback=on_message,
    auto_ack=False,
)
channel.start_consuming()
connection.close()
预期输出
published=20, prefetch=1000
first=task-0
processed=20
脚本输出本身只证明 QoS 已设置并完成消费。处理过程中可在 RabbitMQ Management 的队列指标观察 Unacked;实际数值会随网络、客户端缓冲和采样时机变化。
故障时会放大重新投递
手动确认模式下,消息只有收到 ack 才算完成。如果消费者进程在持有大量 Unacked 时崩溃,RabbitMQ 会把这些消息重新排队,再交给其他消费者。因此 Prefetch 越大,单次故障可能回流的消息就越多。
这会带来两个直接后果:一是重复处理概率上升,所以消费逻辑必须具备幂等性;二是恢复瞬间会出现重新投递高峰,可能把下游数据库或接口再次压满。
把 Prefetch 调到“够用但不囤积”
没有适用于所有业务的固定数字。可以先按消费者真实并发度设置一个有限窗口,再做压测:单线程串行消费者通常从较小值开始;若内部有 N 个并发工作槽,可先尝试接近 N 或 2N,再观察吞吐、Unacked、处理时延和失败恢复。
合理的目标不是让消费者尽可能多拿消息,而是让它在正常处理时不断粮,同时把“尚未完成、故障后需要重来”的消息数量限制在可承受范围内。