
消息队列 / 系统课时
生产环境重点监控哪些指标
生产环境重点监控哪些指标
生产监控的目标不是“把所有 RabbitMQ 指标都采一遍”,而是尽早发现消息积压、消费者失速、连接异常和节点资源逼近极限。本节给出一份可落地的基础监控清单,并说明哪些指标必须结合趋势一起看。
学习目标
- 能围绕积压、吞吐、连接和节点资源建立最小监控集合。
- 能区分
messages_ready与messages_unacknowledged所代表的不同故障方向。 - 能把单点数值与发布、消费速率及资源趋势关联起来设置告警。
监控先回答四个问题
RabbitMQ 的监控可以沿消息路径组织:生产者是否持续发布,队列是否堆积,消费者是否持续取走并确认消息,以及承载这些工作的节点是否还有足够资源。这样做比按页面逐项记指标更容易定位异常。
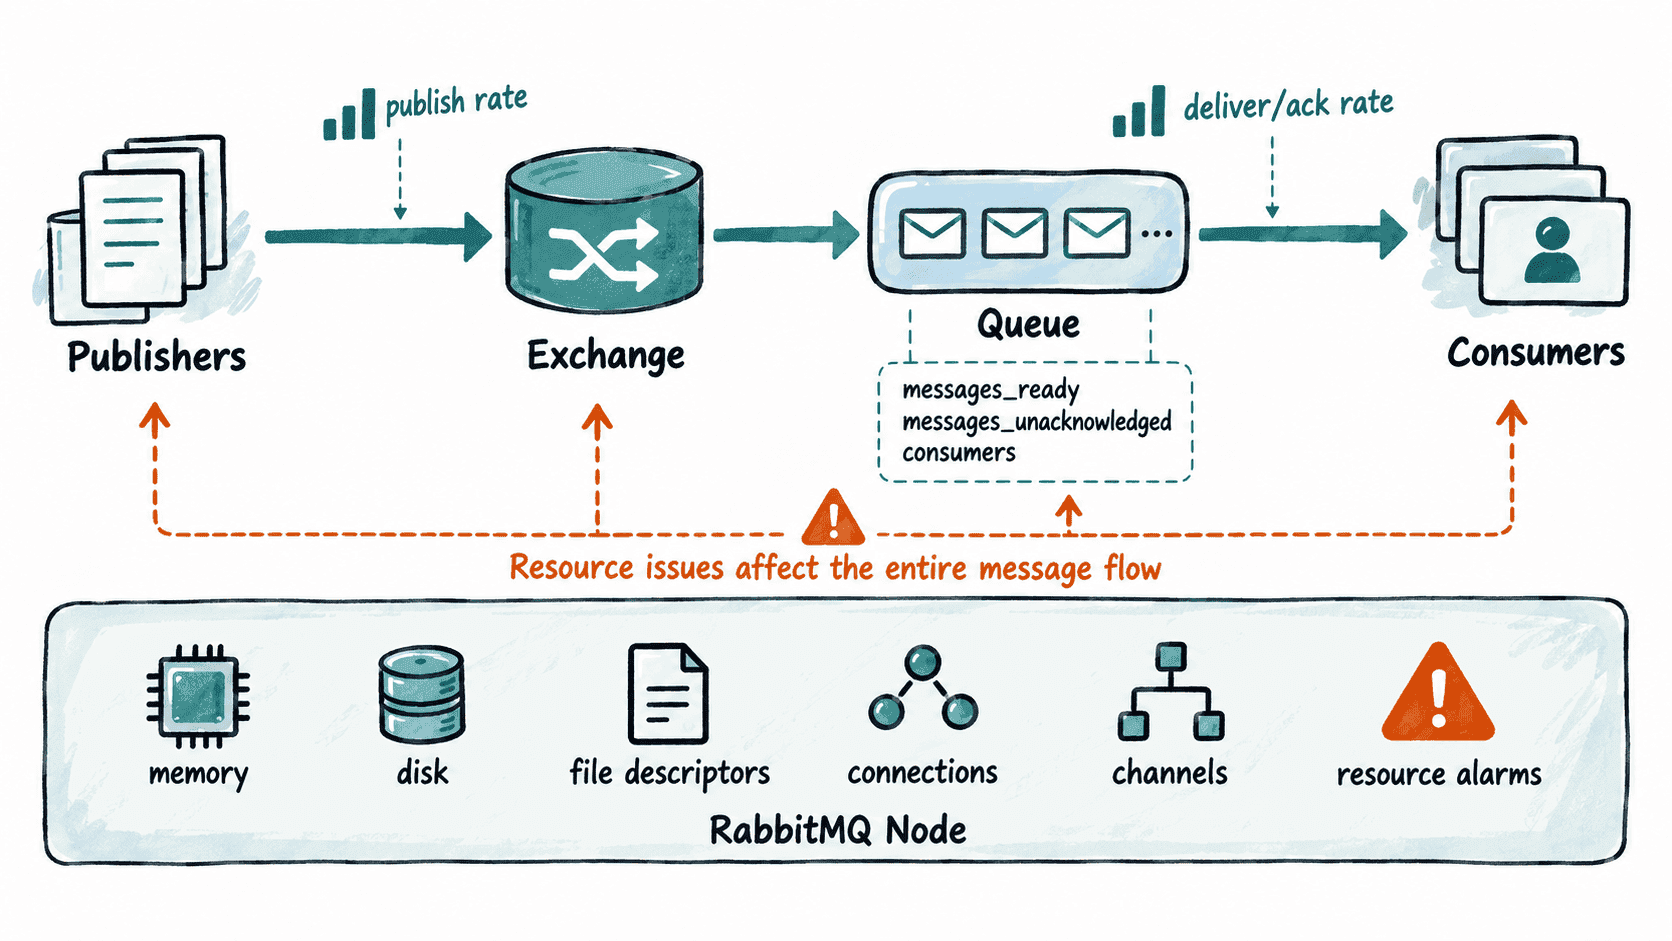
队列与吞吐是第一组信号
messages_ready 表示已经进入队列、尚未投递给消费者的消息。它持续增长,通常意味着消费能力低于发布速度、消费者离线,或消息被路由到没人处理的队列。
messages_unacknowledged 表示已经投递给消费者但尚未确认的消息。它持续偏高时,应检查消费者是否处理变慢、预取值过大、下游依赖阻塞,或业务代码忘记及时 ack。两者必须分开看,因为“还没投递”和“已经投递但没确认”对应完全不同的排查方向。
发布速率、投递速率和确认速率要看趋势关系。若发布速率长期高于确认速率,积压迟早会增长;若发布速率正常但投递速率突然接近零,更像消费者或队列侧故障。瞬时尖峰通常不可怕,持续背离才值得告警。
连接和消费者用于判断服务是否还在工作
至少监控连接数、Channel 数、消费者数量和它们的变化速度。连接数突然归零,常见于网络、认证或应用整体故障;连接数短时间快速增长又下降,往往提示重连风暴或错误的连接生命周期。
消费者数量应和业务部署规模有基本对应关系。队列有大量 messages_ready,同时 consumers 为 0,定位非常直接;如果消费者数量正常但 messages_unacknowledged 持续升高,则要继续看消费者处理耗时和下游服务。
节点资源决定 RabbitMQ 还能撑多久
节点侧至少关注内存、磁盘可用空间、文件描述符、Erlang 进程相关容量,以及 RabbitMQ 的资源告警。RabbitMQ 触发内存或磁盘告警时会采取流控或阻止发布等保护行为,因此资源告警本身应作为高优先级事件,而不是等队列已经停止增长后再处理。
CPU 也要监控,但不要只把“CPU 高”当成根因。高吞吐、TLS、持久化写入和大量连接都可能推高 CPU。更有价值的是把 CPU 与发布速率、磁盘 I/O、连接数和队列积压同时观察。
用命令做一次现场快照
发生异常时,CLI 快照可以快速确认队列是否积压、消费者是否存在,以及连接规模是否异常。以下命令不依赖管理后台页面。
rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers memory
rabbitmqctl list_connections name state channels user vhost
预期输出
Listing queues for vhost / ...
name    messages_ready    messages_unacknowledged    consumers    memory
orders    1200    80    4    <BYTES>

Listing connections ...
name    state    channels    user    vhost
<HOST>:<PORT> -> <HOST>:<PORT>    running    6    app    /
实际队列名、连接名、数值和字节数会不同。若 messages_ready 持续增长而消费者数量不变,应继续比较发布与消费速率;若消费者为 0,则先恢复消费者,而不是先扩 RabbitMQ 节点。
告警不要只依赖固定阈值
固定阈值适合资源底线,例如磁盘空间过低或出现资源告警;业务指标更适合“数值 + 持续时间 + 变化率”。例如队列偶尔堆积 1000 条可能完全正常,但连续十分钟净增长就更值得关注。
生产环境至少应形成这样的关联:队列深度告诉你“是否积压”,速率告诉你“积压会继续扩大还是正在回落”,消费者和连接告诉你“处理链路是否还活着”,节点资源告诉你“Broker 是否接近保护边界”。把这四组信号放在同一时间轴上,故障定位速度会明显快于只看单个指标。