
消息队列 / 系统课时
队列持续积压应该查什么
队列持续积压应该查什么
队列持续积压说明消息进入系统的速度长期高于被成功处理的速度,但根因不一定在 RabbitMQ 本身。有效的排查顺序是先确认生产与消费速率差,再检查消费者数量、单条处理耗时、Prefetch 和异常重试,逐层缩小瓶颈范围。
学习目标
- 按固定顺序定位 RabbitMQ 队列持续积压的主要原因
- 根据 Ready、Unacked 和消费者数量区分不同瓶颈
- 理解处理耗时、Prefetch 与异常重入队如何放大积压
先确认积压是否真的在扩大
不要只看到某一时刻有十万条消息就认定系统异常。批处理、流量高峰或消费者刚恢复时,队列可能暂时很大,但只要消费速率高于生产速率,积压就在被消化。
先查看队列当前状态:
rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers预期输出:
name	messages_ready	messages_unacknowledged	consumers
orders	<READY>	<UNACKED>	<CONSUMERS>
这些值会动态变化。连续采样时,如果 <READY> 一直增长,说明等待投递的消息越来越多;如果 <UNACKED> 长时间维持高位,则需要重点检查已经收到消息的消费者为什么没有及时完成确认。
按顺序检查吞吐瓶颈
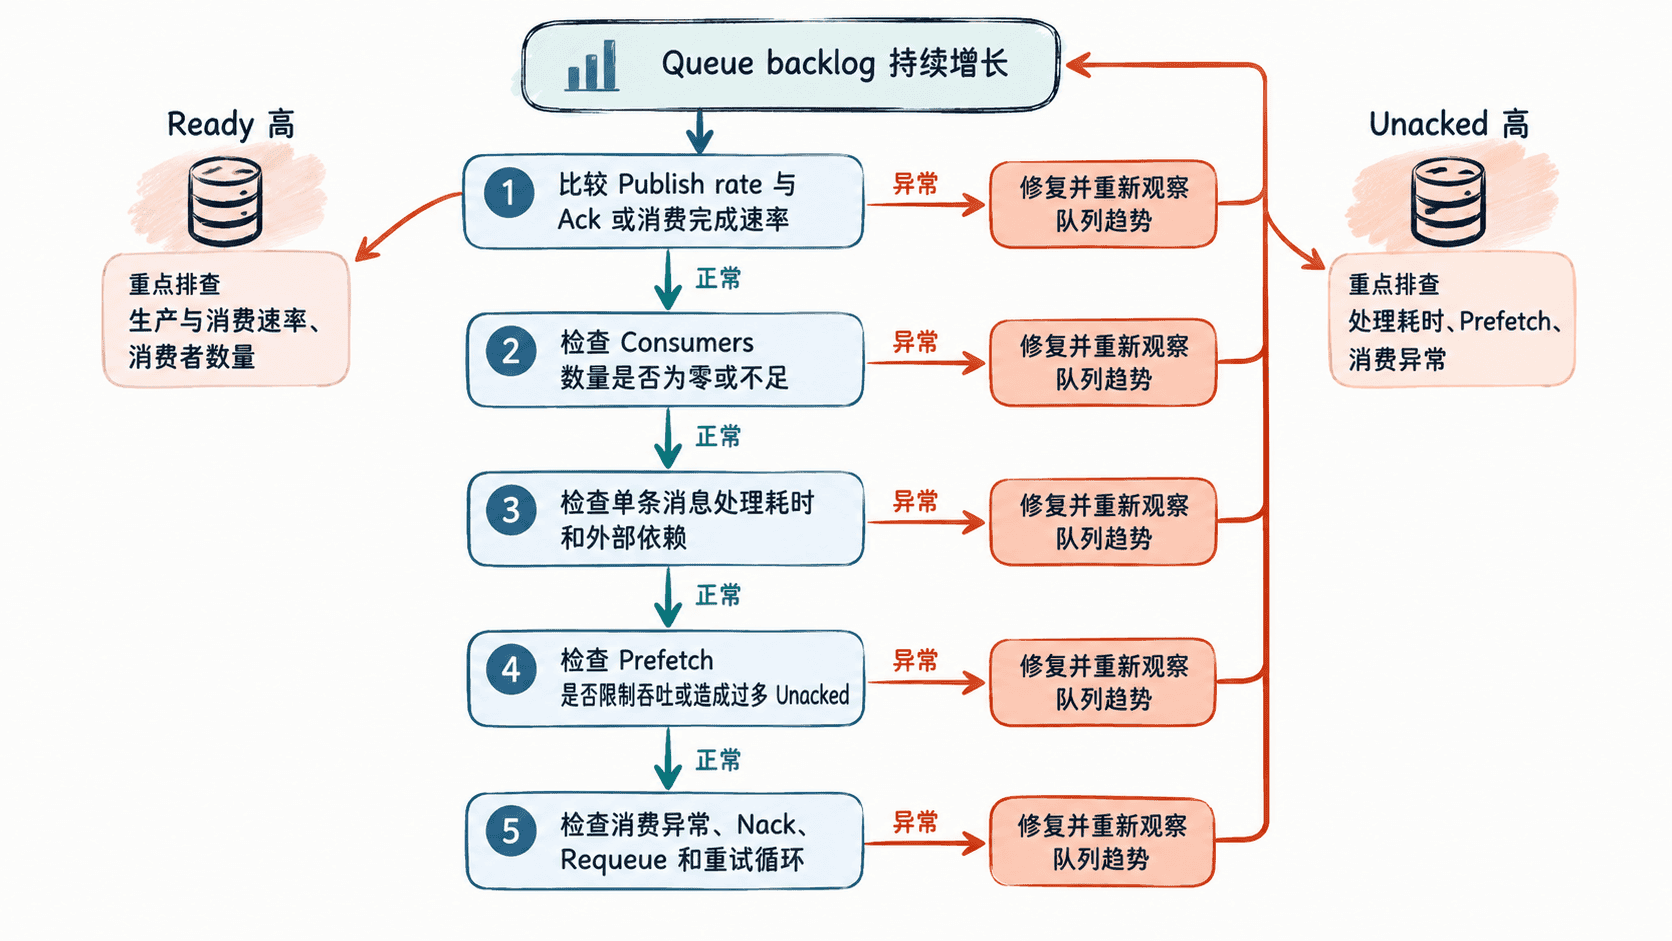
第一步是比较生产速率与成功消费速率。RabbitMQ Management 中可以观察消息 Publish、Deliver 和 Ack 的速率趋势。如果发布长期为每秒 1000 条,而消费者只能稳定确认每秒 700 条,那么即使 RabbitMQ 和消费者都没有报错,队列也会每秒增加约 300 条。
第二步检查消费者数量。消费者为 0 时,Ready 增长是必然结果;消费者数量比预期少,则应继续检查实例是否启动失败、连接是否断开、是否订阅了错误的虚拟主机或队列。
第三步检查单条消息处理耗时。数据库慢查询、调用外部 HTTP 服务、磁盘操作或锁竞争,都可能让一个消费者从每秒处理数百条降到个位数。此时简单增加消费者有时有效,但如果所有实例竞争同一个下游瓶颈,扩容只会把压力继续向后传递。
再检查 Prefetch 和 Unacked
Prefetch 控制一个消费者在尚未确认前最多可以持有多少条消息。值过小会让消费者频繁等待下一次投递,难以充分利用并发能力;值过大则可能让大量消息集中到少数消费者,造成 Unacked 很高、内存占用增加,并降低消息在多个消费者之间重新分配的灵活性。
例如有 10 个消费者,每个 Prefetch 为 100,那么在消费者都处于繁忙状态时,出现接近 1000 条 Unacked 并不一定异常。真正需要关注的是这些消息能否持续被 Ack,以及 Ready 是否仍在同步增长。
最后排查异常和重复入队
消费者日志可能没有完全停止,却在不断抛异常、执行 Nack 或 Reject,并把消息重新放回队列。此时同一批失败消息会被反复消费,表面上看“消费者一直有流量”,实际有效吞吐却很低。
重点确认错误是否集中在少数消息、重试是否有次数上限,以及失败消息是否应该进入死信队列而不是无限 Requeue。还要检查手动确认路径,确保成功处理后一定执行 Ack,失败路径则按照设计选择重试、拒绝或死信。
修复后用趋势验证
修复不能只以“消费者重新启动了”为结束条件。恢复后继续观察 Ready、Unacked、消费者数量以及发布和确认速率。如果成功消费速率稳定高于生产速率,Ready 应逐渐下降;如果只是停止增长但没有下降,说明当前吞吐仅与生产速度持平,历史积压仍无法被清空。
队列积压最有效的定位顺序是:先确认生产与消费速率差,再看消费者数量,然后检查处理耗时、Prefetch 和异常重试。按照这个顺序排查,可以避免一开始就盲目扩容消费者或修改 RabbitMQ 参数,却错过真正的下游性能问题。