
消息队列 / 系统课时
为失败订单配置延迟重试
为失败订单配置延迟重试
订单消费遇到数据库短暂抖动、第三方接口超时等临时故障时,立即重试往往只会再次失败。本节用“业务队列 + 重试队列 + TTL + 死信回投”实现固定延迟重试,让失败消息等待一段时间后再回到原消费链路。
学习目标
- 理解重试队列为什么不需要消费者,以及 TTL 与死信回投如何配合。
- 配置一条可验证的订单延迟重试链路。
- 在重新投递与确认原消息之间保持正确顺序,避免静默丢单。
延迟重试链路
核心不是让消费者 sleep,而是把等待交给 RabbitMQ。消费者发现临时故障后,把消息发布到 order.retry;该队列不配置消费者,只设置固定 TTL。消息到期后由 RabbitMQ 通过死信交换机重新路由到 order.work。
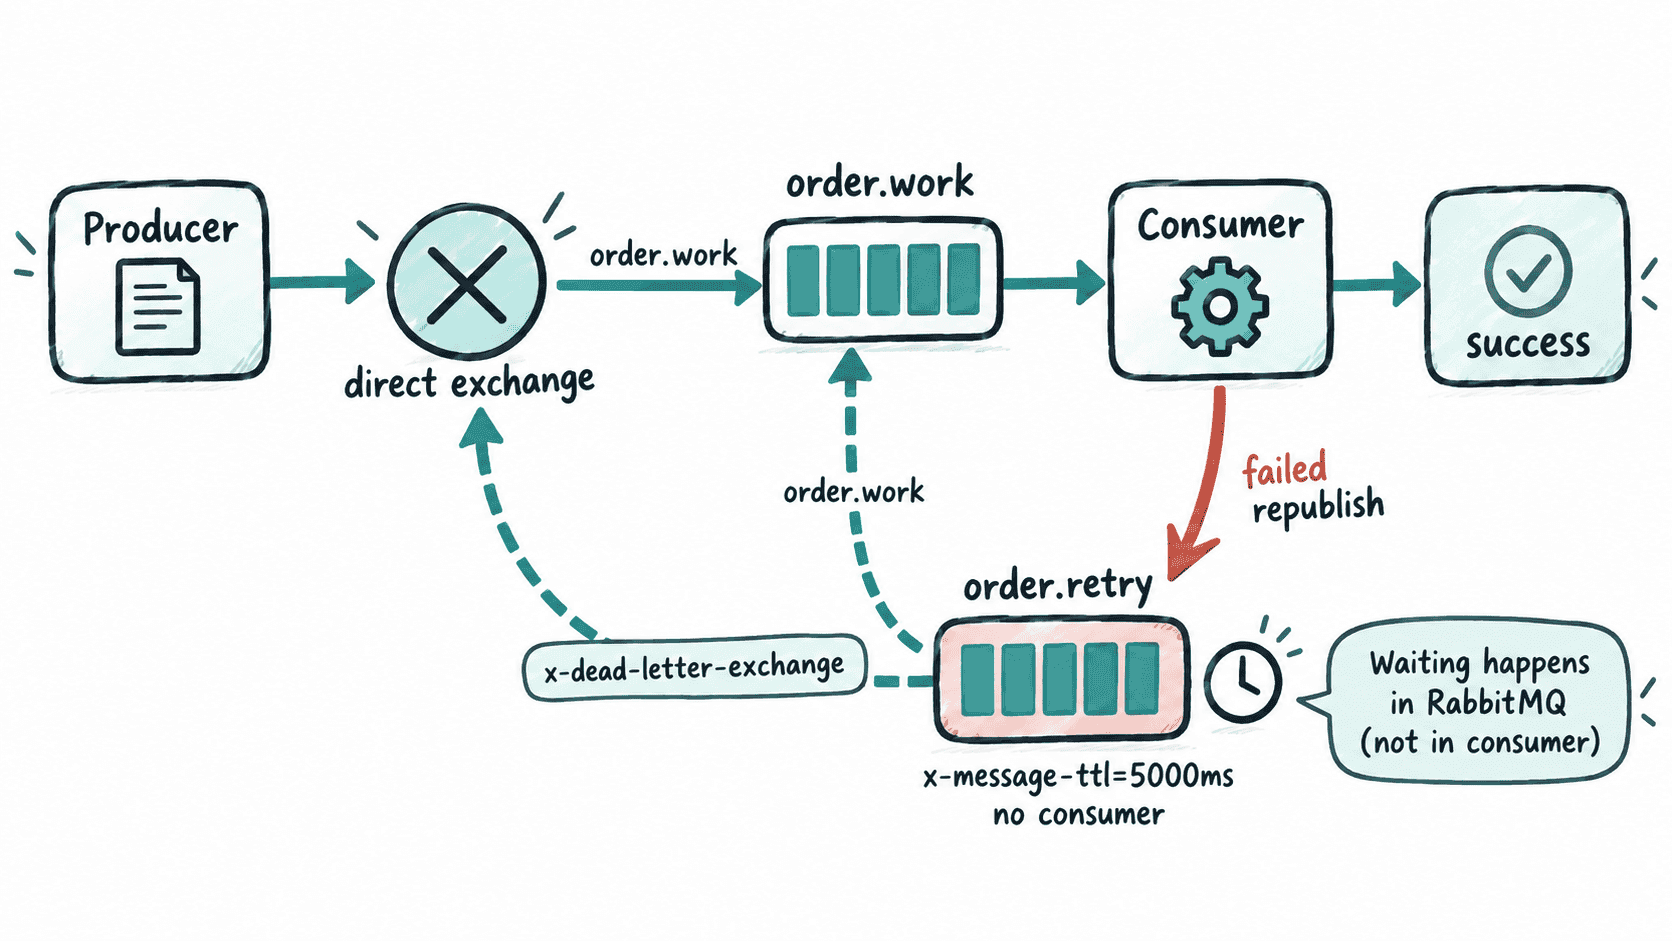
这种结构适合“过几秒再试大概率会恢复”的故障,例如瞬时网络超时、依赖服务短暂不可用。业务校验失败、订单数据永久缺失等确定性错误不应无限进入这条链路。
配置并验证固定延迟
下面的完整 Python 示例使用 pika 声明业务队列与重试队列。第一次消费时模拟临时失败并转入重试队列;5 秒 TTL 到期后,RabbitMQ 将消息重新路由到业务队列,第二次消费成功。
运行前需要本机 RabbitMQ 使用默认 AMQP 端口 5672 可连接,并已安装 Python 3 与 pika。随后保存并运行以下脚本;如果你的 Broker 地址或端口不同,应修改 ConnectionParameters。
import time
import pika

RETRY_MS = 5000
connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost", port=5672)
)
channel = connection.channel()

channel.exchange_declare(
    exchange="order.direct",
    exchange_type="direct",
    durable=True,
)
channel.queue_declare(queue="order.work", durable=True)
channel.queue_declare(
    queue="order.retry",
    durable=True,
    arguments={
        "x-message-ttl": RETRY_MS,
        "x-dead-letter-exchange": "order.direct",
        "x-dead-letter-routing-key": "order.work",
    },
)
channel.queue_bind(
    queue="order.work",
    exchange="order.direct",
    routing_key="order.work",
)
channel.queue_bind(
    queue="order.retry",
    exchange="order.direct",
    routing_key="order.retry",
)

# 发布确认成功后再 ack 原消息,避免“原消息已确认、重试消息却没发出去”。
channel.confirm_delivery()
started = time.monotonic()
attempts = 0

def handle_order(ch, method, properties, body):
    global attempts
    attempts += 1

    if attempts == 1:
        print(f"{time.monotonic() - started:.1f}s 第1次消费:模拟下游超时,转入重试队列")
        ch.basic_publish(
            exchange="order.direct",
            routing_key="order.retry",
            body=body,
            properties=pika.BasicProperties(delivery_mode=2),
            mandatory=True,
        )
        ch.basic_ack(delivery_tag=method.delivery_tag)
        return

    print(f"{time.monotonic() - started:.1f}s 第2次消费:处理成功")
    ch.basic_ack(delivery_tag=method.delivery_tag)
    ch.stop_consuming()

channel.basic_publish(
    exchange="order.direct",
    routing_key="order.work",
    body=b'{"orderId":"A1001"}',
    properties=pika.BasicProperties(delivery_mode=2),
    mandatory=True,
)
channel.basic_consume(
    queue="order.work",
    on_message_callback=handle_order,
    auto_ack=False,
)
channel.start_consuming()
connection.close()
预期输出:
<TIME> 第1次消费:模拟下游超时,转入重试队列
<TIME> 第2次消费:处理成功
第二行通常会比第一行晚约 5 秒,实际 <TIME> 会受调度和网络延迟影响。若脚本之前已经创建过同名队列但参数不同,RabbitMQ 会因队列参数不一致拒绝重新声明;练习时应删除旧测试队列或改用新的队列名。
为什么不要在消费者里直接等待
在消费者线程中 sleep(5) 会长期占用一个消费槽位。失败量增加后,大量线程都在等待,吞吐量会被重试拖垮;而重试队列把等待状态留在 Broker 中,消费者可以继续处理其他订单。
固定延迟还应优先使用队列级 x-message-ttl。如果同一队列混用差异很大的单消息过期时间,后到但已过期的消息可能要等待前面的消息先离开队头,延迟行为更难预测。需要 5 秒、30 秒、5 分钟等多档退避时,可以分别准备多个固定 TTL 的重试队列。
确认可靠性边界
重试消息不是“发出去就算完成”。消费者应先确认重试消息已经发布成功,再 basic_ack 原业务消息。示例启用了 publisher confirm,并使用 mandatory=True,当交换机无法路由或发布失败时不会继续执行正常确认路径。
队列和消息都设为持久化可以降低 Broker 重启导致的丢失风险,但它不能替代业务幂等。一次订单可能因为连接中断、确认丢失等原因被再次投递,因此真正的订单处理仍应以 orderId 等业务键做幂等保护。