
P2P 与分布式存储 / 系统课时
读取字节流时如何划分消息边界
读取字节流时如何划分消息边界
节点已经建立加密连接,却可能在一次读取中只收到半条消息,或者同时收到多条消息。如果把每次读取直接当成完整消息,解析就会随机失败。本课使用四字节长度前缀定义消息边界,实现能够处理部分读取、连续写入和异常长度的接收器,并通过可运行测试验证行为。
学习目标
- 解释为什么 TCP 或 libp2p 字节流中的一次读取不等于一条应用消息。
- 实现四字节大端长度前缀协议,正确处理拆分与合并的消息。
- 识别异常长度、半帧断流和正常连接关闭,验证接收器的安全边界。
字节流为什么不保留消息边界
TCP 提供的是可靠、有序的字节流,而不是按应用消息划分的数据包。发送方连续调用两次 sendall(),接收方可能一次获得两条消息,也可能需要多次 recv() 才能拿齐第一条。recv(4096) 中的 4096 只是单次最多读取的字节数,不保证返回 4096 字节,更不表示读取一条消息。
例如发送方依次写入 UTF-8 文本 HELLO 和 WORLD,接收方可能观察到以下任意分组方式:
| 接收情况 | 第一次读取 | 第二次读取 | 第三次读取 |
|---|---|---|---|
| 恰好分开 | HELLO | WORLD | 无 |
| 合并到达 | HELLOWORLD | 无 | 无 |
| 被拆分 | HE | LLOW | ORLD |
三种情况下,字节总序列都是 HELLOWORLD,传输并没有出错。真正的问题是应用不知道 HELLO 在哪里结束。如果直接对每次 recv() 的结果进行 JSON 解析或消息分发,就可能得到不完整的数据,或者把两条消息错误地当成一条。
用长度前缀定义一条完整消息
一种简单可靠的方案是在每条消息前增加固定四字节长度字段。长度表示后续载荷的字节数量,而不是整个帧的长度,也不是字符串字符数。
本课约定如下格式:
| 字段 | 大小 | 编码和含义 |
|---|---|---|
| Length | 4 字节 | 无符号整数,大端字节序 |
| Payload | Length 字节 | 原始二进制数据,可承载 UTF-8、JSON 或其他格式 |
例如 你好 的 UTF-8 编码需要 6 字节,长度字段为 00 00 00 06;PING 需要 4 字节,长度字段为 00 00 00 04。两条消息连续发送后,总长度为 4 + 6 + 4 + 4 = 18 字节。
接收方必须先累计完整的 4 字节首部,再解析长度,检查长度是否超过上限,最后累计指定数量的载荷字节。完成一帧后,继续从剩余字节中解析下一帧。
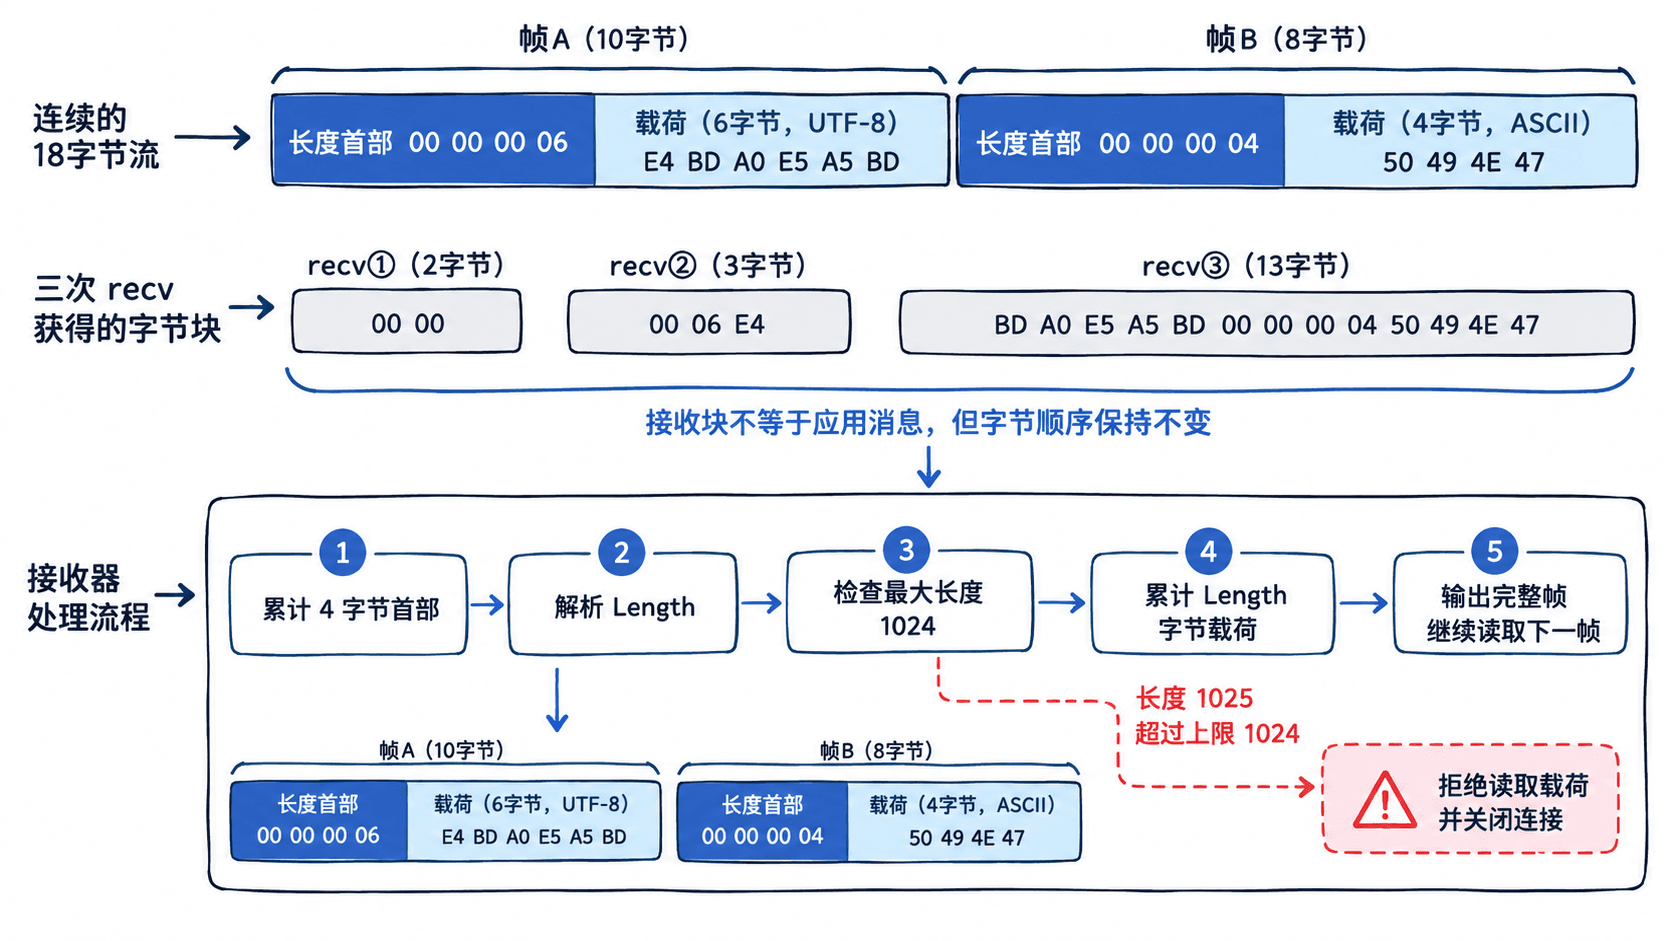
这里选择大端序,是为了让通信双方拥有明确的字节序约定。Python 的 struct.pack('!I', length) 可以生成对应首部,! 表示网络字节序,I 表示四字节无符号整数。
长度前缀属于应用层自定义帧格式,并不是所有 libp2p 协议统一使用的内置消息格式。真实项目必须让发送方和接收方遵循相同约定;如果接入已有协议,应优先使用该协议规定的消息封装方式。
实现按需累计的读帧器
下面使用 Python 3.8 及以上版本的标准库实现完整示例,不需要安装第三方依赖。encode_frame() 负责发送端编码,recv_exact() 负责循环累计指定字节数,read_frame() 负责解析帧首部和载荷。
为了让测试结果稳定,示例提供 ChunkedStream 模拟底层读取行为。它与真实阻塞式套接字使用相同的 recv(n) 调用形式,但允许人为指定每次返回的数据片段,从而重复验证消息拆分与合并。
import struct
from collections import deque

MAX_PAYLOAD = 1024


def encode_frame(payload: bytes) -> bytes:
    if len(payload) > MAX_PAYLOAD:
        raise ValueError('payload too large')
    return struct.pack('!I', len(payload)) + payload


def recv_exact(stream, n: int, *, allow_eof=False):
    # 循环读取,因为单次recv不保证返回所需的全部字节
    buf = bytearray()
    while len(buf) < n:
        chunk = stream.recv(n - len(buf))
        if not chunk:
            if allow_eof and not buf:
                return None
            raise EOFError('incomplete frame')
        buf.extend(chunk)
    return bytes(buf)


def read_frame(stream):
    header = recv_exact(stream, 4, allow_eof=True)
    if header is None:
        return None

    size = struct.unpack('!I', header)[0]
    # 读取载荷前验证长度,防止异常首部触发超大读取
    if size > MAX_PAYLOAD:
        raise ValueError(f'length {size} exceeds {MAX_PAYLOAD}')
    return recv_exact(stream, size)


class ChunkedStream:
    def __init__(self, chunks):
        self.chunks = deque(chunks)

    def recv(self, n):
        if not self.chunks:
            return b''
        part = self.chunks.popleft()
        if len(part) > n:
            self.chunks.appendleft(part[n:])
        return part[:n]


def main():
    wire = encode_frame('你好'.encode('utf-8')) + encode_frame(b'PING')
    # 故意拆开首部,同时让后续字节包含两个连续帧
    stream = ChunkedStream([wire[:2], wire[2:5], wire[5:]])
    print(read_frame(stream).decode('utf-8'))
    print(read_frame(stream).decode('utf-8'))
    print(read_frame(stream))

    try:
        read_frame(ChunkedStream([struct.pack('!I', 1025)]))
    except ValueError as exc:
        print('非法长度:', exc)

    try:
        read_frame(ChunkedStream([struct.pack('!I', 5), b'ab']))
    except EOFError as exc:
        print('消息截断:', exc)


if __name__ == '__main__':
    main()
将代码保存为 framing_demo.py,执行 python framing_demo.py。
预期输出:
你好
PING
None
非法长度: length 1025 exceeds 1024
消息截断: incomplete frame
第一条消息的首部被拆成两次读取,接收器仍然正确输出 你好。后续字节同时包含第一帧的剩余数据与完整第二帧,读取器也能正确输出 PING,不会吞掉下一条消息的开头。
这里的 None 表示在准备读取新帧首部时,流已经正常结束且没有残留半帧。它与返回空载荷 b'' 不同:如果协议允许零长度消息,长度为 0 的合法帧应返回 b'',而不是被判断为连接关闭。
如何定位部分读取和异常长度
实际网络中,部分读取本身不是故障,只要连接仍然有效,接收器就应该继续等待剩余字节。需要区别的是正常的分段到达、消息中途断流和非法首部。
| 观察到的情况 | 正确处理 | 不应采取的做法 |
|---|---|---|
| 首部只收到 2 字节 | 继续累计剩余 2 字节 | 立即按整数解析 |
| 声明载荷 100 字节,暂时收到 40 字节 | 继续接收剩余 60 字节 | 把前 40 字节交给业务层 |
| 一次收到两个完整帧 | 按长度依次解析两帧 | 把所有字节拼成一条业务消息 |
| 首部声明长度 1025,上限 1024 | 立即拒绝该连接上的帧 | 直接按 1025 字节读取 |
| 声明 5 字节,只收到 2 字节后 EOF | 报告消息截断 | 把 2 字节当成完整消息 |
真实阻塞式 TCP 套接字可直接复用 encode_frame() 和 read_frame()。发送端调用 sock.sendall(encode_frame(payload)),接收端调用 read_frame(sock);前者负责将编码后的全部字节交给套接字发送机制,后者负责重新划分应用消息边界。
需要注意,recv() 返回空字节串表示对端已经有序关闭发送方向或连接结束,不表示当前只是暂时没有新数据。若设置了套接字超时,读取还可能抛出 socket.timeout;超时并不等于 EOF,应由连接管理逻辑决定重试、终止还是保留已经读取的部分数据。上面的同步示例针对阻塞式读取,不直接适用于非阻塞套接字的事件循环。
为真实节点增加安全边界
四字节无符号长度理论上可表达接近 4 GiB 的载荷。如果应用盲目信任远端长度,攻击者只需发送一个巨大长度首部,就可能诱导接收器占用大量内存或长期等待数据。
本示例将 MAX_PAYLOAD 设为 1024 字节,只是为了便于测试。真实节点应根据业务设置限制,例如控制消息上限 64 KiB、大型业务消息上限 1 MiB,并让发送和接收双方使用一致的限制。不要未经测量就允许任意大小的消息。
接入真实 P2P 节点时,还应落实以下检查:
- 在解析长度后、读取载荷前检查最大允许长度。超出上限时拒绝该帧,通常直接关闭当前协议流,避免在未知边界上继续解析。
- 为整个帧设置读取期限或空闲超时,防止对端只发送合法首部却始终不发送完整载荷。对于长期慢速传输,还需要考虑总体速率限制。
- 对同一节点的并发流数量和累计缓冲字节数设置预算,避免大量合法小帧同时占用过多内存。
- 只在获得完整帧后再进行 UTF-8、JSON 或 Protobuf 解码,并分别处理帧格式错误与业务载荷错误。
- 对半帧 EOF、非法长度和超时记录不同的错误类别。日志保留远端 Peer ID、协议名、声明长度和已读取长度,但不要默认记录完整敏感载荷。
最后可以尝试将示例中的 wire[:2] 改为 wire[:1],并调整其余切分位置,使同一帧经过更多次读取。只要全部字节保持原有顺序且没有丢失,最终输出就应该保持不变。
正确的消息边界处理应满足三个可验证条件:任意分段不会改变解析结果、连续帧不会相互污染、非法或不完整帧不会被交付业务层。长度前缀负责确定边界,循环累计负责适应字节流,长度与超时限制则负责控制不可信远端带来的资源风险。