
P2P 与分布式存储 / 系统课时
FIND_NODE 如何逐轮收敛目标
FIND_NODE 如何逐轮收敛目标
已知目标节点的 Peer ID,却不知道它当前连接在哪些节点上时,可以使用 Kademlia 的 FIND_NODE 逐轮寻找更接近目标的候选节点。本课通过一个可运行的八位节点标识模拟器,观察并发查询、候选去重、距离收敛和查找终止的完整过程。
学习目标
- 根据 XOR 距离排列候选节点,解释为什么每轮优先查询距离较近的节点。
- 使用具体节点数据追踪 FIND_NODE 的请求、响应、候选集合和并发查询。
- 实现简化的迭代查找,判断何时可以结束以及超时节点应如何处理。
XOR 距离决定查询方向
Kademlia 将节点映射到标识空间,通过 XOR 距离衡量两个标识的接近程度。对于节点标识 a 和目标标识 t,距离就是 a ^ t,其中 ^ 表示按位异或。距离越小,节点在标识空间中越接近目标。
例如,目标标识为 0xA6,三个已知节点分别是 0xF0、0x20 和 0x70:
| 节点 | XOR 计算 | 十进制距离 |
|---|---|---|
| F0 | F0 XOR A6 = 56 | 86 |
| 20 | 20 XOR A6 = 86 | 134 |
| 70 | 70 XOR A6 = D6 | 214 |
因此,查询顺序优先考虑 F0,再考虑 20,最后才是 70。这里比较的是标识空间距离,而不是节点的物理距离、网络 RTT 或 IP 地址大小。
为了让算例能够手工核对,本课使用八位节点标识。真实 libp2p Kad-DHT 使用通过 SHA-256 映射的 256 位键空间,不能直接对 Peer ID 的可读字符串进行异或。示例只缩小标识位数,不改变迭代查找的基本思路。
FIND_NODE 请求怎样扩展候选集合
一次 FIND_NODE 请求携带目标节点的标识。收到请求的节点从自己的路由表中选出距离目标最近、最多 k 个已知节点,并将节点信息返回给查询发起者。在 libp2p Kad-DHT 的消息结构中,返回的候选节点位于 closerPeers 字段。
发起者不会要求被查询节点继续代为查找,而是自己维护候选集合并发送下一批请求,因此这是由发起者控制的迭代查找。
需要区分两个参数:
| 参数 | 本课取值 | 控制内容 |
|---|---|---|
k |
4 | 期望最终确认的最近节点数量,也是单次 FIND_NODE 回复的候选数量上限 |
α |
2 | 同时进行的 FIND_NODE 请求数量上限 |
这里的 k=4、α=2 是为了教学演示而缩小的参数。libp2p Kad-DHT 规范推荐复制参数 k=20,并定义默认并发参数 α=10;具体实现的配置和调度策略可能有所不同。
发起者至少需要维护三种信息:已发现的节点集合、已查询节点的状态、当前正在执行的请求。新响应到达后,先根据 Peer ID 去重,再按目标 XOR 距离排序,从最近且尚未查询的候选节点中继续选择请求对象。
请求结果可能是重复节点、较远节点、较近节点或超时错误。重复节点不应再次拨号查询;超时节点应标记失败并从可用候选中排除,同时按照并发上限补充其他候选。
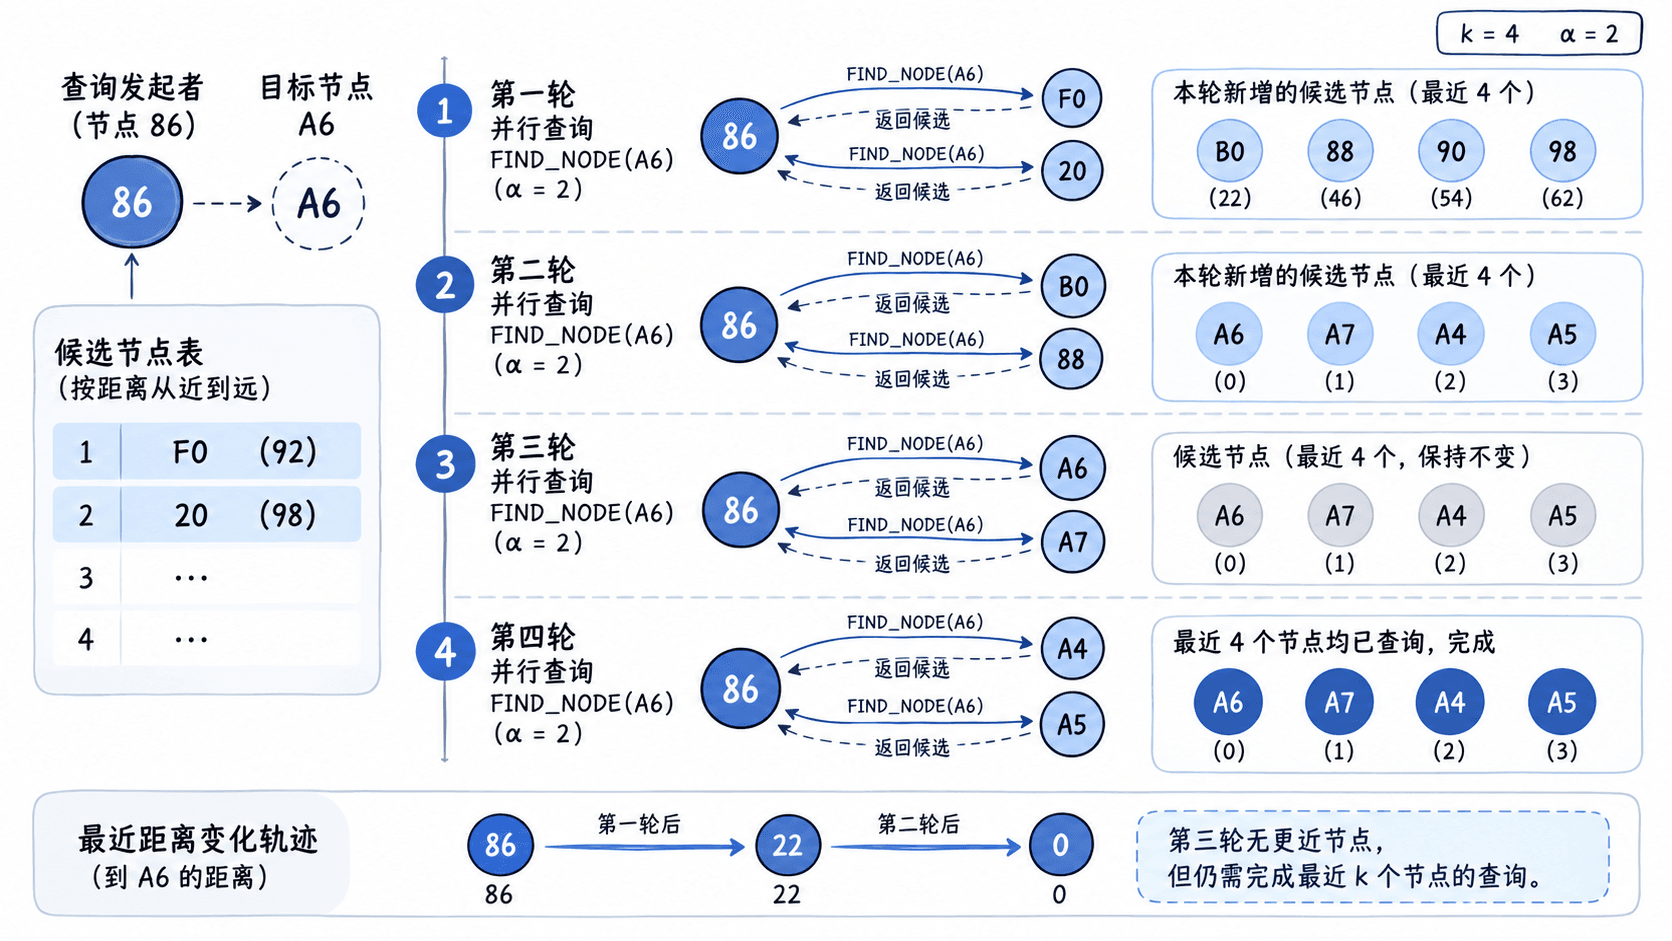
四轮查询如何逼近目标 A6
假设发起节点最初只知道 F0、20、70 三个节点,目标是找到接近 A6 的四个节点。本例所有节点均可响应,且每个节点只知道部分邻居。
初始候选中,F0 的距离为 86,20 的距离为 134。因为 α=2,第一轮可以同时向它们发送 FIND_NODE(A6)。
F0 返回 B0、88、90;20 返回 B0、E0、98。B0 虽然出现两次,但只保留一份。合并后,距离最近的四个候选为 B0、88、90、98。
接着向 B0 和 88 查询。B0 返回 A7、A4、A5、90;88 返回 A6、A7、A5。重新排序后,A6、A7、A4、A5 成为最近的四个候选,距离分别为 0、1、2、3。
完整轨迹如下:
| 轮次 | 本轮查询 | 合并后的最近四个节点及距离 | 最近距离 |
|---|---|---|---|
| 1 | F0、20 | B0(22)、88(46)、90(54)、98(62) | 22 |
| 2 | B0、88 | A6(0)、A7(1)、A4(2)、A5(3) | 0 |
| 3 | A6、A7 | A6(0)、A7(1)、A4(2)、A5(3) | 0 |
| 4 | A4、A5 | A6(0)、A7(1)、A4(2)、A5(3) | 0 |
这里有两个容易混淆的结果。
首先,第二轮已经发现 A6,说明目标标识出现在已知候选集合中;距离为零代表标识匹配,并不自动证明应用层连接已经建立。其次,第三轮没有出现更近的节点,但 A4 和 A5 仍未查询,因此仍需要第四轮来完成最近四个候选的确认。
可以看出,收敛不要求每轮距离严格下降。当发现更近的节点后,候选集合会重新排序;当距离不再改善时,算法仍可能继续查询尚未完成的近邻。
用 Python 复现迭代查找
下面使用 Python 3 标准库构造一个本地模拟器。neighbors 表示各节点知道的邻居;find_node 模拟 FIND_NODE 回复;ThreadPoolExecutor 使用两个工作线程模拟每轮最多两个并发请求。
保存为 find_node_demo.py,使用 Python 3.9 或更新版本运行。它不建立真实网络连接,所有回复均由固定邻接表提供,以便准确复现四轮轨迹。
from concurrent.futures import ThreadPoolExecutor

TARGET, K, ALPHA = 0xA6, 4, 2
neighbors = {
    0xF0: [0xB0, 0x88, 0x90],
    0x20: [0xB0, 0xE0, 0x98],
    0xB0: [0xA7, 0xA4, 0xA5, 0x90],
    0x88: [0xA6, 0xA7, 0xA5],
    0xA6: [0xA7, 0xA4],
    0xA7: [0xA6, 0xA4],
    0xA4: [0xA6, 0xA5],
    0xA5: [0xA6, 0xA7],
}
seen = {0xF0, 0x20, 0x70}
queried = set()

def dist(peer):
    return peer ^ TARGET

def find_node(peer):
    # 模拟远端返回自己已知的最多 K 个近邻。
    return sorted(neighbors.get(peer, []), key=dist)[:K]

with ThreadPoolExecutor(max_workers=ALPHA) as pool:
    round_no = 0
    while True:
        top = sorted(seen, key=dist)[:K]
        if all(peer in queried for peer in top):
            break

        batch = [p for p in top if p not in queried][:ALPHA]
        round_no += 1
        # 每轮并发查询,合并回复时由集合自动去重。
        for returned in pool.map(find_node, batch):
            seen.update(returned)
        queried.update(batch)

        closest = sorted(seen, key=dist)[:K]
        ids = ','.join(f'{p:02X}' for p in batch)
        ranked = ','.join(f'{p:02X}({dist(p)})' for p in closest)
        print(f'第{round_no}轮 查询:{ids} 最近:{ranked}')

    print('结束 最近4个:', ','.join(f'{p:02X}' for p in top))
执行命令:
python find_node_demo.py预期输出:
第1轮 查询:F0,20 最近:B0(22),88(46),90(54),98(62)
第2轮 查询:B0,88 最近:A6(0),A7(1),A4(2),A5(3)
第3轮 查询:A6,A7 最近:A6(0),A7(1),A4(2),A5(3)
第4轮 查询:A4,A5 最近:A6(0),A7(1),A4(2),A5(3)
结束 最近4个: A6,A7,A4,A5
重点检查第二轮和第四轮:第二轮结束时最近距离已达到零,第四轮结束时最近四个节点才全部完成查询。两者分别代表发现目标和满足本例查找终止条件。
这个模拟器把回复固定为成功,并采用整轮等待策略。实际网络中的请求可能先后完成,常见实现会在某个请求结束后立即补充下一条请求,使同时在途的请求数量不超过 α,而不必等待一整轮全部结束。
终止条件与真实网络边界
对于 FIND_NODE,不能简单把没有发现更近节点当成唯一终止条件。按照经典 Kademlia 查找规则,可以在已知的最近 k 个节点都完成查询并得到响应后结束;如果不足 k 个可用节点,则在已知候选已经查询完毕后结束。不同实现可能增加超时、查询预算和提前终止策略。
工程实现可以按以下顺序检查状态:
- 对候选节点按目标 XOR 距离排序,选出最近的
k个可用节点。 - 检查其中是否有尚未查询或者正在等待响应的节点;如有,继续调度,保持在途请求数量不超过
α。 - 响应成功时合并新的 Peer ID 和可用地址,去重后重新排序;响应失败或超时时记录失败状态,不把超时当作成功。
- 如果最近
k个可用节点均已成功查询,或者所有允许查询的候选已经耗尽,则返回目前能够确认的最近节点集合。
实际网络还需处理三类情况。
| 情况 | 错误做法 | 推荐处理 |
|---|---|---|
| 节点超时 | 无限等待一个最近节点 | 设置单请求超时和有限重试,并查询下一个可用候选 |
| 返回重复节点 | 对相同 Peer ID 不断拨号 | 按 Peer ID 去重,分别记录查询和连接状态 |
| 返回无效地址 | 直接认为节点可连接 | 校验 Peer ID、地址格式和拨号结果,并通过安全连接验证远端身份 |
例如,可以先为实验环境设置单次请求超时 3 秒、最多重试 1 次、整次查找预算 15 秒。这些是应用层实验参数,并非 libp2p 统一规定的默认值。发生整体超时时,应将结果标记为不完整,而不是把已经发现的最近节点误称为整个网络的最优结果。
还要区分两种查找目标:FIND_NODE 用于获得接近某个节点标识的节点信息;内容记录检索和内容提供者发现分别涉及 GET_VALUE、GET_PROVIDERS 等操作,不能因为 FIND_NODE 找到了最近节点,就认为已经取回内容。
真实 libp2p 的消息字段、键空间规则和查找机制可以对照 libp2p Kad-DHT 协议规范。
如果修改模拟器,将 88 的邻接表中的 A6 删除,并确保其他节点也不返回 A6,算法仍会继续查询并最终返回已发现的最近节点,但不会声称找到精确目标。这正是 FIND_NODE 的重要边界:它依据分布式节点掌握的局部路由信息逐步逼近目标,返回的是本次查询能够发现并确认的近邻集合。