
P2P 与分布式存储 / 系统课时
节点离线后如何修复路由表
节点离线后如何修复路由表
本篇用一个四槽 K 桶模拟节点离线:先让 FIND_NODE 查询遇到超时,再引入新候选、复探旧节点并更新路由表。完成后能区分临时查询失败与真正需要替换的陈旧记录,还能用一次定向刷新检查修复效果。
学习目标
- 识别 FIND_NODE 超时对候选查询顺序和并发名额的影响。
- 按经典 Kademlia 策略处理满桶探活、保留与替换分支。
- 运行可复现的模拟脚本,并用 XOR 距离验证刷新结果。
一次超时如何影响 FIND_NODE
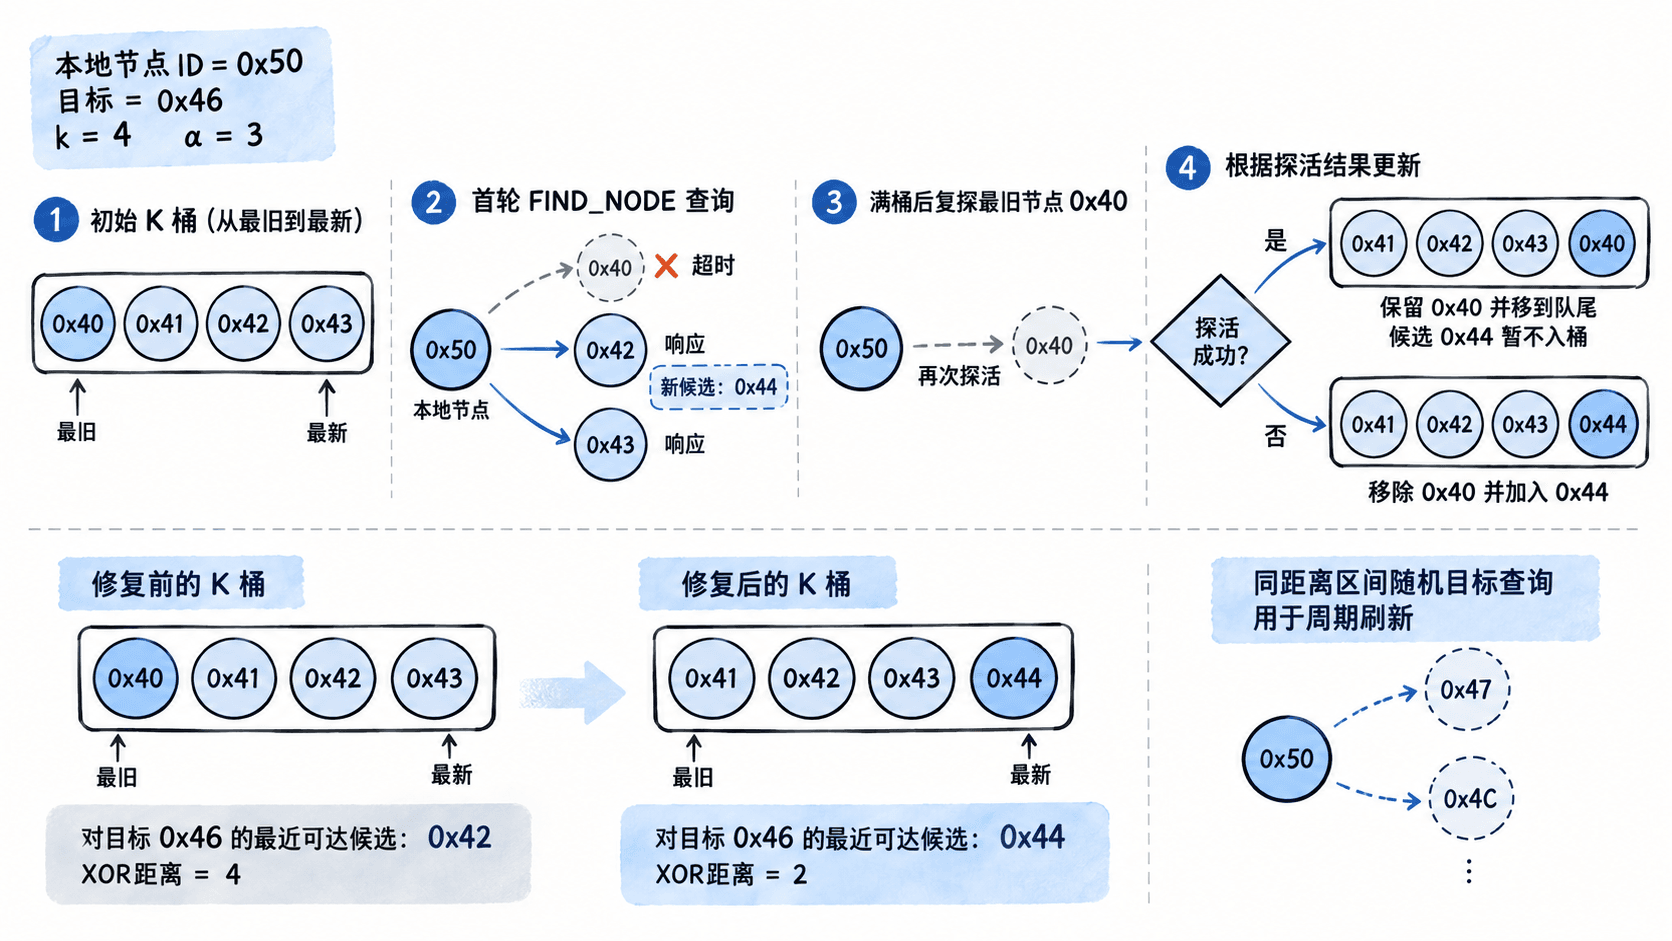
设本地节点 ID 为 0x50,目标 ID 为 0x46,桶容量 k=4,并发查询数 α=3。路由桶按最近成功交互时间从旧到新保存 0x40、0x41、0x42、0x43。这些节点与本地节点的 XOR 距离均在 16~31 之间,属于同一个距离区间。
查找目标 0x46 时,四个候选按 XOR 距离排序为 0x42(4)→0x43(5)→0x40(6)→0x41(7)。首轮向前三个节点查询;假设 0x40 已离线,它占据一个并发位置直到超时,而 0x42 的有效响应又带回新候选 0x44。
一次 FIND_NODE 超时只能说明本次请求未成功,不能立即证明远端永久离线。查询器应继续尝试未访问的候选;路由维护器则记录失败并安排独立探活。网络拥塞、地址过期或短暂断连都可能造成相同现象。
满桶时怎样淘汰旧记录
经典 Kademlia 的满桶处理可按以下分支理解:新候选 0x44 先通过基本可达性检查,再探测桶中最久未成功交互的 0x40。
- 如果
0x40应答,保留它并更新最近成功交互顺序;满桶中的新候选暂不替换现有记录。 - 如果
0x40经探测策略确认不可达,移除它,把已验证的0x44加入桶尾。 - 如果新候选本身不可达,也不应为了凑满
k强行收录。
这里的“最旧”不是 ID 最小,而是最长时间没有成功交互。具体 libp2p 实现可能使用不同的入表过滤、失败判定和替换缓存策略;下图与脚本演示的是便于理解的经典桶淘汰规则。
用 Python 复现失败与替换
以下示例适用于 Python 3.10 及以上版本,只使用标准库。online 集合模拟哪些节点能够应答,不会实际打开网络连接;第一轮中 0x42 返回 0x44 是预设的有效响应。脚本刻意区分“查询超时”和“最旧节点再次探测失败”。
from collections import deque

LOCAL, TARGET, K, ALPHA = 0x50, 0x46, 4, 3
bucket = deque([0x40, 0x41, 0x42, 0x43])  # 左端是最久未成功交互的节点
online = {0x41, 0x42, 0x43, 0x44}

def fmt(peers):
    return " ".join(f"0x{p:02X}" for p in peers)

def closest(peers):
    return sorted(peers, key=lambda p: p ^ TARGET)

# 模拟 FIND_NODE 首轮,0x42 的响应提供新候选 0x44
wave = closest(bucket)[:ALPHA]
timeouts = [p for p in wave if p not in online]
print("初始桶:", fmt(bucket))
print("首轮查询:", fmt(wave))
print("超时节点:", fmt(timeouts))
candidate = 0x44
print("新候选:", fmt([candidate]))

# 满桶复探最旧项,决定是否允许新候选补位
oldest = bucket[0]
if oldest in online:
    bucket.rotate(-1)
    print("最旧节点应答,保留")
else:
    bucket.popleft()
    bucket.append(candidate)
    print("最旧节点复探失败,替换:", f"0x{oldest:02X}")
print("修复后:", fmt(bucket))
print("目标候选:", fmt(closest(bucket)))
print("目标距离:", " ".join(str(p ^ TARGET) for p in closest(bucket)))
预期输出:
初始桶: 0x40 0x41 0x42 0x43
首轮查询: 0x42 0x43 0x40
超时节点: 0x40
新候选: 0x44
最旧节点复探失败,替换: 0x40
修复后: 0x41 0x42 0x43 0x44
目标候选: 0x44 0x42 0x43 0x41
目标距离: 2 4 5 7
把 0x40 加入 online 后重跑,预期会走“最旧节点应答,保留”分支,桶中不会出现 0x44。这能检查维护逻辑是否错误地把所有超时节点立即删除。
怎样刷新桶并评估查找效率
替换一个离线节点不代表整张路由表已经恢复。周期刷新通常在某个距离区间选取随机目标,执行一次类似 FIND_NODE 的查找,把过程中发现且符合入表条件的可达节点纳入候选。示例目标 0x46 与本地 0x50 的 XOR 距离是 22,恰好落在上述桶的 16~31 区间;实际刷新应使用该区间的随机目标,而非永远查询 0x46。
可以用以下数据核对这次模拟修复的收益:
| 检查项 | 修复前 | 修复后 |
|---|---|---|
| 桶中记录数 | 4 | 4 |
| 已知可达记录数 | 3 | 4 |
到 0x46 最近的可达节点 |
0x42,距离 4 |
0x44,距离 2 |
首轮遇到 0x40 超时 |
是 | 否 |
这些数值说明本次演示减少了无效查询候选,并发现更近的节点,不代表任意一次刷新都必然降低端到端延迟。真实网络中可记录每百次查找的超时请求数、成功查找比例和延迟分位数,对比修复前后效果。刷新间隔可先用 10 分钟作为实验值,再依据网络变化速度与请求负载调整;离线频繁时应限制并发刷新,防止额外查询放大拥塞。