
P2P 与分布式存储 / 系统课时
如何用消息 ID 去重避免循环传播
如何用消息 ID 去重避免循环传播
当发布者的消息沿多条邻居路径扩散时,同一节点可能接连收到相同消息的多个副本。如果每次收到都重新转发,环状拓扑就会产生大量重复流量。本篇设计稳定的消息 ID 和限时已见缓存,并通过四节点实验验证每个节点只处理和转发首份消息。
学习目标
- 解释多路径传播产生重复消息的原因,区分消息身份与传输路径。
- 设计包含发布者、主题和序号的消息 ID,避免不同消息被错误合并。
- 实现带过期时间和容量限制的已见缓存,验证重复消息不会继续传播。
多条传播路径为什么会产生重复
考虑四个节点 A、B、C、D。A 同时连接 B 和 C,B、C 又分别连接 D。A 发布消息 M 后,B 和 C 都会把它转发给 D。D 先从 B 收到 M,又从 C 收到相同的 M。
如果 D 不记录已经处理过的消息,它就可能把两个副本再次转发给邻居。消息沿环路重复出现,消耗连接带宽、CPU 和接收队列容量。在节点更多、连接更密集时,重复传播会更加明显。
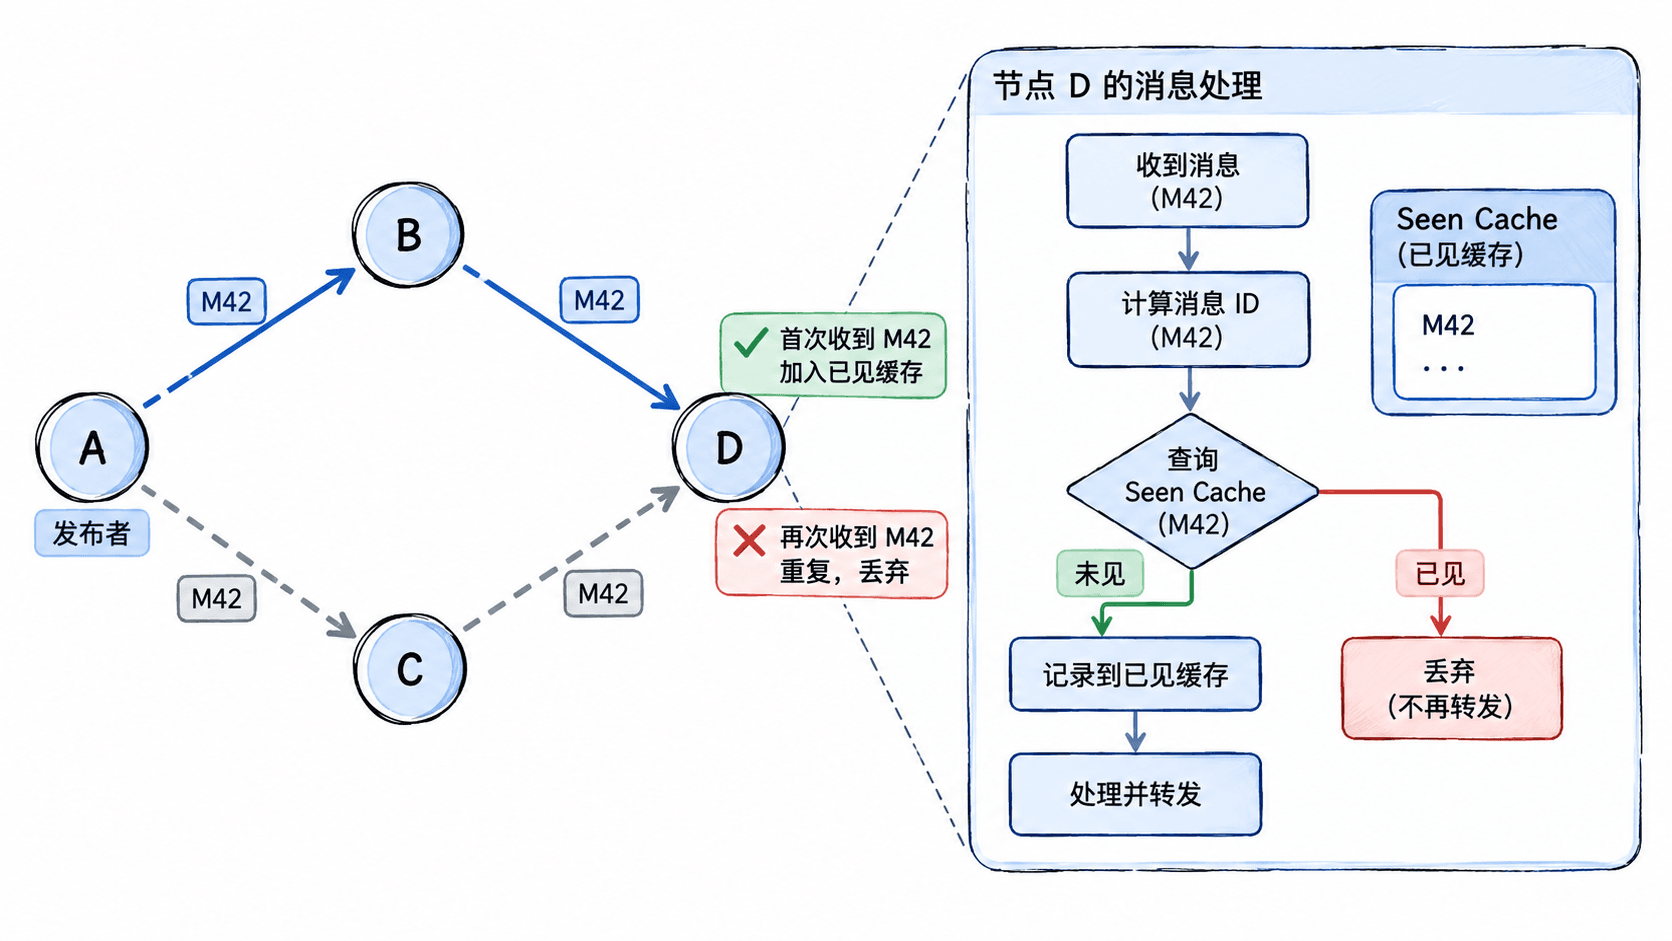
这里的重复判断依据是消息身份,而不是消息从哪个邻居到达。B 和 C 虽然是不同的上一跳,但它们携带的是 A 发出的同一条消息。D 必须将其识别为同一个消息 ID。
实际 GossipSub 使用消息网格与控制消息协调传播,并不要求节点向所有邻居广播。即使采用网格拓扑,多路径重复到达仍然可能发生,因此每个节点都需要独立去重。
消息 ID 应如何定义
消息 ID 必须满足两个条件:同一条消息经过不同节点转发时 ID 不变;不同的有效发布事件不能轻易产生相同 ID。
可以为应用层消息定义以下字段:
| 字段 | 示例 | 用途 |
|---|---|---|
topic |
news |
区分传播主题 |
source |
PeerA |
标识原始发布者 |
seq |
42 |
标识该发布者的一次发布事件 |
payload |
hello |
实际消息内容 |
本课采用 SHA-256(规范化编码(topic, source, seq)) 生成消息 ID。三个身份字段需要采用确定性编码,避免简单拼接时出现字段边界歧义。转发节点保持原始身份字段不变,仅改变传输路径。
例如 A 在 news 主题发布序号 42 的消息,经 B 和 C 转发后仍具有相同 ID。A 下一次发布时将序号改为 43,即使正文仍是 hello,也应当被视为新的发布事件。
以 rust-libp2p Gossipsub 配置文档 为例,其默认消息 ID 使用来源 PeerId 与消息序号,也允许通过 message_id_fn 自定义规则。本文包含主题字段的 SHA-256 方案是教学示例,不是所有 libp2p 实现统一使用的默认算法。
用已见缓存截断重复传播
每个节点维护本地 Seen Cache,键为消息 ID,值为该记录的过期时间。收到消息时,先计算 ID,再查缓存:
- 如果 ID 尚未出现,则记录 ID,处理消息,并转发给符合条件的其他邻居。
- 如果 ID 已存在且未过期,则丢弃当前副本,不重复执行业务回调,也不再次转发。
- 如果记录已过期,则允许重新判断该消息;是否还应执行历史业务事件,需要业务层另行决定。
下面使用 Python 3 标准库模拟四个节点。代码不依赖真实网络连接,而是通过队列按照传播顺序传递消息,重点验证消息 ID 与去重缓存的行为。
将代码保存为 dedup_demo.py,使用 Python 3.8 或更新版本运行。
from collections import OrderedDict, deque
import hashlib
import json
import time


def message_id(message):
    # 只取发布身份字段,转发路径不会影响消息 ID
    identity = {k: message[k] for k in ("topic", "source", "seq")}
    encoded = json.dumps(
        identity, sort_keys=True, separators=(",", ":")
    ).encode("utf-8")
    return hashlib.sha256(encoded).hexdigest()


class SeenCache:
    def __init__(self, ttl=60, limit=20000):
        self.ttl = ttl
        self.limit = limit
        self.entries = OrderedDict()

    def is_new(self, mid, now):
        # 使用单调时钟;按插入顺序移除到期记录
        while self.entries and next(iter(self.entries.values())) <= now:
            self.entries.popitem(last=False)
        if mid in self.entries:
            return False
        if len(self.entries) >= self.limit:
            self.entries.popitem(last=False)
        self.entries[mid] = now + self.ttl
        return True


def main():
    neighbors = {
        "A": ["B", "C"],
        "B": ["A", "D"],
        "C": ["A", "D"],
        "D": ["B", "C"],
    }
    seen = {node: SeenCache() for node in neighbors}
    message = {
        "topic": "news", "source": "A",
        "seq": 42, "payload": "hello",
    }
    queue = deque([("A", None, message)])

    while queue:
        node, sender, current = queue.popleft()
        mid = message_id(current)
        if not seen[node].is_new(mid, time.monotonic()):
            print(f"{node}: 重复,丢弃(来自 {sender})")
            continue

        print(f"{node}: 首次接收,处理一次")
        # 不回发给上一跳;其他路径的重复交给缓存处理
        for peer in neighbors[node]:
            if peer != sender:
                queue.append((peer, node, current))


if __name__ == "__main__":
    main()
预期输出:
A: 首次接收,处理一次
B: 首次接收,处理一次
C: 首次接收,处理一次
D: 首次接收,处理一次
D: 重复,丢弃(来自 C)
C: 重复,丢弃(来自 D)
D 先通过 B 收到消息并缓存 ID,随后通过 C 收到相同 ID 时直接丢弃。D 首次接收后还会尝试转发给 C,但 C 已从 A 收到该消息,所以同样丢弃。最终四个节点各处理一次,队列自然清空。
这段程序模拟的是简化的邻居洪泛传播,不是完整的 GossipSub 实现。真实 GossipSub 还涉及网格维护、IHAVE/IWANT 控制消息和消息验证等机制,但已见消息去重的判断原则相同。
缓存过期、容量与安全边界
已见缓存不能无限增长。假设某节点平均每秒接收 200 条不同消息,希望在 60 秒内阻止重复传播,那么正常情况下需要保存约 200 × 60 = 12000 个消息 ID。
本例设置 ttl=60 秒、limit=20000 条,给短时流量波动留出空间。这里的 60 秒是教学配置值,也与部分 rust-libp2p Gossipsub 版本的默认重复缓存时间一致;实际部署应根据重复到达延迟、吞吐量和内存预算调整。
需要关注三个边界:
| 情况 | 处理行为 | 主要风险 |
|---|---|---|
| ID 在有效期内重复 | 丢弃,不再转发 | 正常去重 |
| ID 已过期 | 可能再次被接受 | 旧消息重新传播 |
| 缓存达到容量上限 | 提前淘汰最旧记录 | 尚未到期的重复消息可能被接受 |
OrderedDict 保存了插入顺序,示例先删除到期条目,再在容量满时淘汰最早插入的记录。由于记录只在插入时设置过期时间,并假设单调时钟持续前进,按插入顺序清理是成立的。真实服务还应限制消息大小和来源速率,避免攻击者用大量不同 ID 挤掉正常缓存。
还要区分网络去重与业务幂等。例如一笔支付事件即使超过 60 秒才重新到达,也不应该重新扣款。这需要持久化业务事件 ID、唯一约束或事务机制,不能依赖短期 GossipSub 缓存。
如何验证去重真正生效
在本地运行示例后,可以按以下顺序检查:
- 确认 A、B、C、D 各自只有一行“首次接收,处理一次”,说明单条消息没有被重复交付。
- 确认 D 出现“来自 C”的重复丢弃记录,说明不同路径传来的消息被识别为同一个 ID。
- 确认 C 收到 D 的回传副本后也会丢弃,并且程序正常结束,说明传播环路已经被截断。
- 将
seq改为43再运行,确认新发布事件仍能正常到达全部节点。两次独立运行会重建缓存;若要验证同一进程内的新旧 ID 并存,应在同一批缓存中连续注入两条消息。
接入真实 P2P 网络后,应分别统计首次接受数、重复丢弃数、无效消息数和实际转发数,并用唯一消息 ID 关联日志。若同一 ID 在同一节点反复执行业务逻辑,应优先检查缓存是否被提前淘汰、各节点是否采用一致的 ID 规则,以及发布和转发过程中是否意外修改了身份字段。
当消息身份稳定、已见缓存有效且所有转发节点遵守首次处理规则时,多条传播路径仍可提供可达性冗余,却不会让同一条消息沿环路无限重复传播。