
P2P 与分布式存储 / 系统课时
Kademlia 如何计算异或距离
Kademlia 如何计算异或距离
Kademlia 需要在大量节点中判断谁更接近查询目标,但这种远近不是地理距离,也不是网络延迟,而是节点标识之间的异或距离。我们将用 8 位二进制标识完成手工计算,再编写 Python 程序验证候选节点排序,并理解这一距离如何服务于 DHT 路由。
学习目标
- 掌握 XOR 距离的逐位计算规则,能够手算两个节点标识的距离。
- 根据指定目标对多个候选节点排序,理解共同前缀与距离大小的关系。
- 区分逻辑距离、地理距离和网络延迟,避免在路由设计中混用指标。
异或距离的计算规则
Kademlia 将节点或查询目标映射到固定长度的二进制标识空间。对于两个等长标识 和 ,异或距离定义为:
其中 表示逐位异或:两个对应位相同得到 0,不同得到 1。将所得二进制结果视为无符号整数,数值越小,逻辑距离越近。
例如使用 8 位标识:
- 节点 X:
10110000,十进制为 176。 - 节点 Y:
10110011,十进制为 179。 - XOR 结果:
00000011,距离为 3。
注意这里不是计算十进制差值的绝对值。虽然本例中两个结果碰巧同为 3,但一般情况下并不相同。例如 01111111 XOR 10000000 等于 11111111,距离是 255,而两个整数的绝对差值只有 1。
XOR 距离有三个有用性质:相同标识距离为 0;交换两个标识不改变距离;越靠左的高位差异对距离数值的影响越大。因此,共同前缀较长的标识通常更接近,准确地说,在共同前缀长度不同的情况下,前缀较长者一定更近。
对四个候选节点进行排序
假设当前要查找的目标标识 T 为 10110000,已知候选节点 A、B、C、D。逐位异或后得到:
| 节点 | 节点标识 | XOR 结果 | 十进制距离 | 共同前缀位数 |
|---|---|---|---|---|
| A | 10110011 |
00000011 |
3 | 6 |
| D | 10110100 |
00000100 |
4 | 5 |
| B | 10100000 |
00010000 |
16 | 3 |
| C | 00110000 |
10000000 |
128 | 0 |
因此,距离目标 T 从近到远的顺序是 A、D、B、C。A 与目标的前 6 位相同,而 C 的第一位已经不同,后面即使有较多相同位,也无法抵消最高位差异造成的距离。
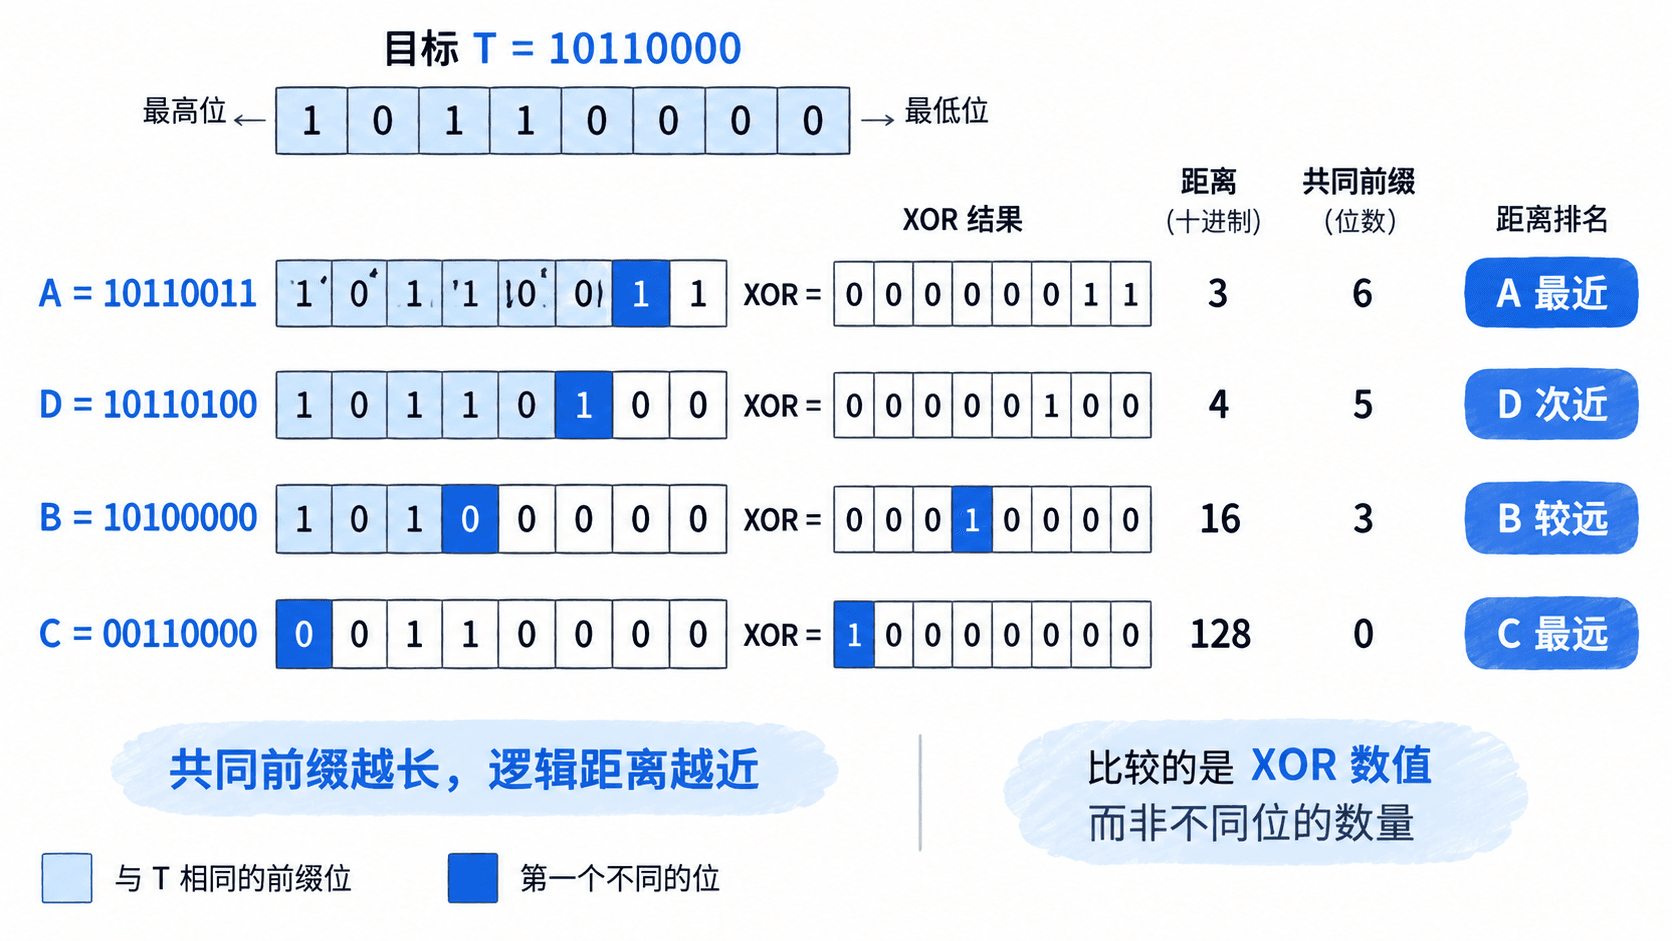
还有一个容易混淆的细节:距离不是不同位的数量。A 的 XOR 结果 00000011 有两个 1,D 的结果 00000100 只有一个 1,但 A 的距离 3 仍然小于 D 的距离 4。统计不同位数量得到的是汉明距离,不能代替 Kademlia 的 XOR 数值距离。
使用 Python 验证距离排序
下面的程序适用于 Python 3.8 及以上版本,不依赖第三方库。使用整数保存模拟节点标识,直接通过 ^ 运算符计算 XOR 距离,再使用 sorted 从小到大排序。
def main():
    # 教学示例使用8位标识,便于逐位核对。
    target = 0b10110000
    peers = {
        "A": 0b10110011,
        "B": 0b10100000,
        "C": 0b00110000,
        "D": 0b10110100,
    }

    # 排序依据是相对于查询目标的XOR整数值。
    ranking = sorted(
        peers.items(),
        key=lambda pair: pair[1] ^ target,
    )

    print(f"target={target:08b}")
    for name, peer_id in ranking:
        distance = peer_id ^ target
        print(
            f"{name}: id={peer_id:08b} "
            f"xor={distance:08b} distance={distance}"
        )


if __name__ == "__main__":
    main()
将程序保存为 xor_distance.py,在安装 Python 3 的环境中执行:
python xor_distance.py预期输出:
target=10110000
A: id=10110011 xor=00000011 distance=3
D: id=10110100 xor=00000100 distance=4
B: id=10100000 xor=00010000 distance=16
C: id=00110000 xor=10000000 distance=128
输出应与手算表格完全一致。可以将 target 改为 0b10100000 再运行:此时 B 与目标完全相同,距离为 0;其他三个候选节点会按照相对于新目标的 XOR 值重新排序。
这种排序方式适合生成一次查找的候选优先级,但排序结果并不保证候选节点在线、可拨通,或响应速度最快。实际 DHT 查询还必须处理节点可达性、请求失败和超时。
XOR 近不代表网络延迟低
XOR 距离描述的是标识空间中的逻辑位置,不包含 IP 地址、物理机房、传输路径或 RTT 信息。即使两个节点的 XOR 距离只有 1,也可能分别位于不同大洲;两个地理位置相邻的节点,标识反而可能相距很远。
考虑一次查询中测得的示例数据:
| 节点 | XOR 距离 | 实测 RTT | 地理位置(示例) |
|---|---|---|---|
| A | 3 | 180 ms | 远程区域 |
| D | 4 | 15 ms | 本地区域 |
| B | 16 | 40 ms | 邻近区域 |
根据 XOR 距离,A 比 D 更接近目标;根据 RTT,D 的往返延迟更低。这两种判断都成立,因为衡量的是不同属性。表中 RTT 只是用于对比的假设测量值,不是 XOR 距离推导出的结果。
在 Kademlia 中,目标距离通常决定候选节点的逻辑接近程度。实际请求调度可以结合超时、并发限制和可达性信息,但不能直接用 RTT 排序替代 XOR 距离排序,否则可能失去朝目标标识空间推进的依据。
对接 libp2p 时如何处理真实 Peer ID
前面的 8 位整数只是教学模型。真实的 libp2p Kad-DHT 使用 256 位标识空间,其距离计算针对规范化后的 DHT Key 进行,而不是直接对 Peer ID 的可读字符串逐字符异或。
按照 libp2p Kad-DHT 规范,距离计算采用 XOR(sha256(key1), sha256(key2))。对于节点路由,参与计算的是 Peer ID 的二进制表示经 SHA-256 映射得到的 DHT 标识;不要把 Base58 或 CID 文本表示直接作为整数进行比较。
实际实现中还应注意三个边界:
- 距离必须相对于同一个查询目标计算。相对于本地节点的最近邻顺序,可能不同于相对于目标记录 Key 的顺序。
- 标识长度必须一致。真实 DHT 的 SHA-256 结果为 32 字节,不能将截断后的不同长度字节数组直接进行距离排序。
- 距离为 0 表示两个 DHT 标识相同。对于同一个目标标识,这是最小可能距离;是否应连接或查询对应节点仍取决于实际节点身份与查询上下文。
可以用一次检查确认自己是否掌握了规则:目标为 10110000 时,候选 10110001 的距离为 1,比 A 的距离 3 更近;而候选 00110000 的距离为 128,即使它与目标的后七位完全相同,也属于逻辑上较远的区域。
实际 Kademlia 路由正是利用这种可重复计算的逻辑距离选择更接近目标的候选节点。只要明确目标标识、统一 DHT Key 的编码与哈希规则,并按 XOR 数值排序,就能为后续的 k-bucket 组织和迭代节点查找提供正确的距离基础。