
P2P 与分布式存储 / 系统课时
K 桶怎样保存远近不同的节点
K 桶怎样保存远近不同的节点
节点发现的新邻居越来越多时,路由表不能无限增长。本课用 8 位节点 ID 和每桶 2 个位置,亲手计算 XOR 距离、观察 K 桶的远近分布,并模拟新节点加入、旧节点应答和离线淘汰后的表项变化。
学习目标
- 按 XOR 距离将节点放入对应 K 桶,理解桶号与共同前缀的关系。
- 模拟桶满时的活跃性探测、节点保留和失效替换。
- 根据模拟输出检查各桶占用,并辨别路由表与地址缓存的职责。
XOR 距离怎样划分远近
Kademlia 把节点标识映射到固定长度的键空间,距离定义为 selfId XOR peerId,不是 IP 延迟或物理距离。对于非零距离 d,教学模型中的桶号为 d.bit_length() - 1:最高不同位越靠左,距离越远;d=0 表示自身,不加入路由表。
设本地 8 位 ID 为 0x50(二进制 01010000),每个桶覆盖一个不重叠的距离区间:
| 桶号 | XOR 距离范围 | 示例节点 | XOR 结果 |
|---|---|---|---|
| 0 | 1 | 0x51 |
1 |
| 1 | 2~3 | 0x53 |
3 |
| 2 | 4~7 | 0x54 |
4 |
| 3 | 8~15 | 0x58 |
8 |
| 4 | 16~31 | 0x40 |
16 |
| 5 | 32~63 | 0x70 |
32 |
| 6 | 64~127 | 0x10 |
64 |
| 7 | 128~255 | 0xD0 |
128 |
例如 0x50 XOR 0x40 = 0x10,最高置位在第 4 位,所以 0x40 进入桶 4;0xD0 与本地最高位不同,进入桶 7。相反,桶 0 仅包含一个可能的 8 位 ID,远处的桶 7 对应 128 个可能的 ID,桶数相同不等于节点数相同。
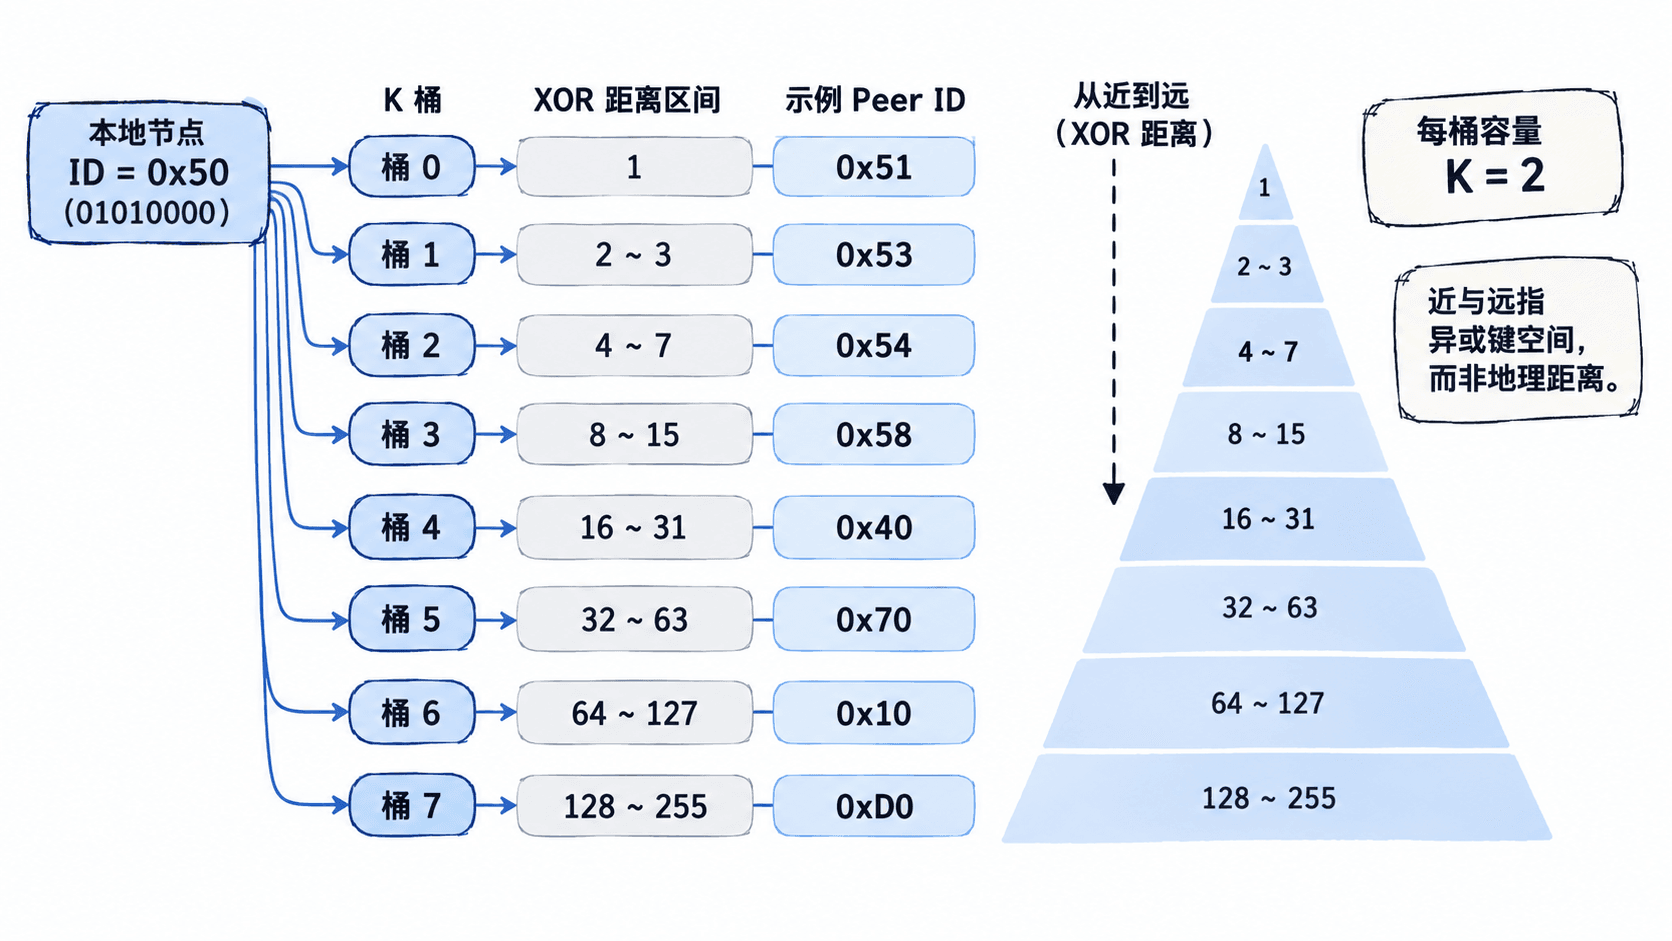
真实 libp2p Kad-DHT 使用更长的哈希路由键,通常按共同前缀长度管理邻居;某些实现采用可分裂的前缀树。这里的 8 位桶号只是把相同的 XOR 分组原理缩小,不能当作某个 SDK 的内部数组下标。
桶满后怎样决定留谁
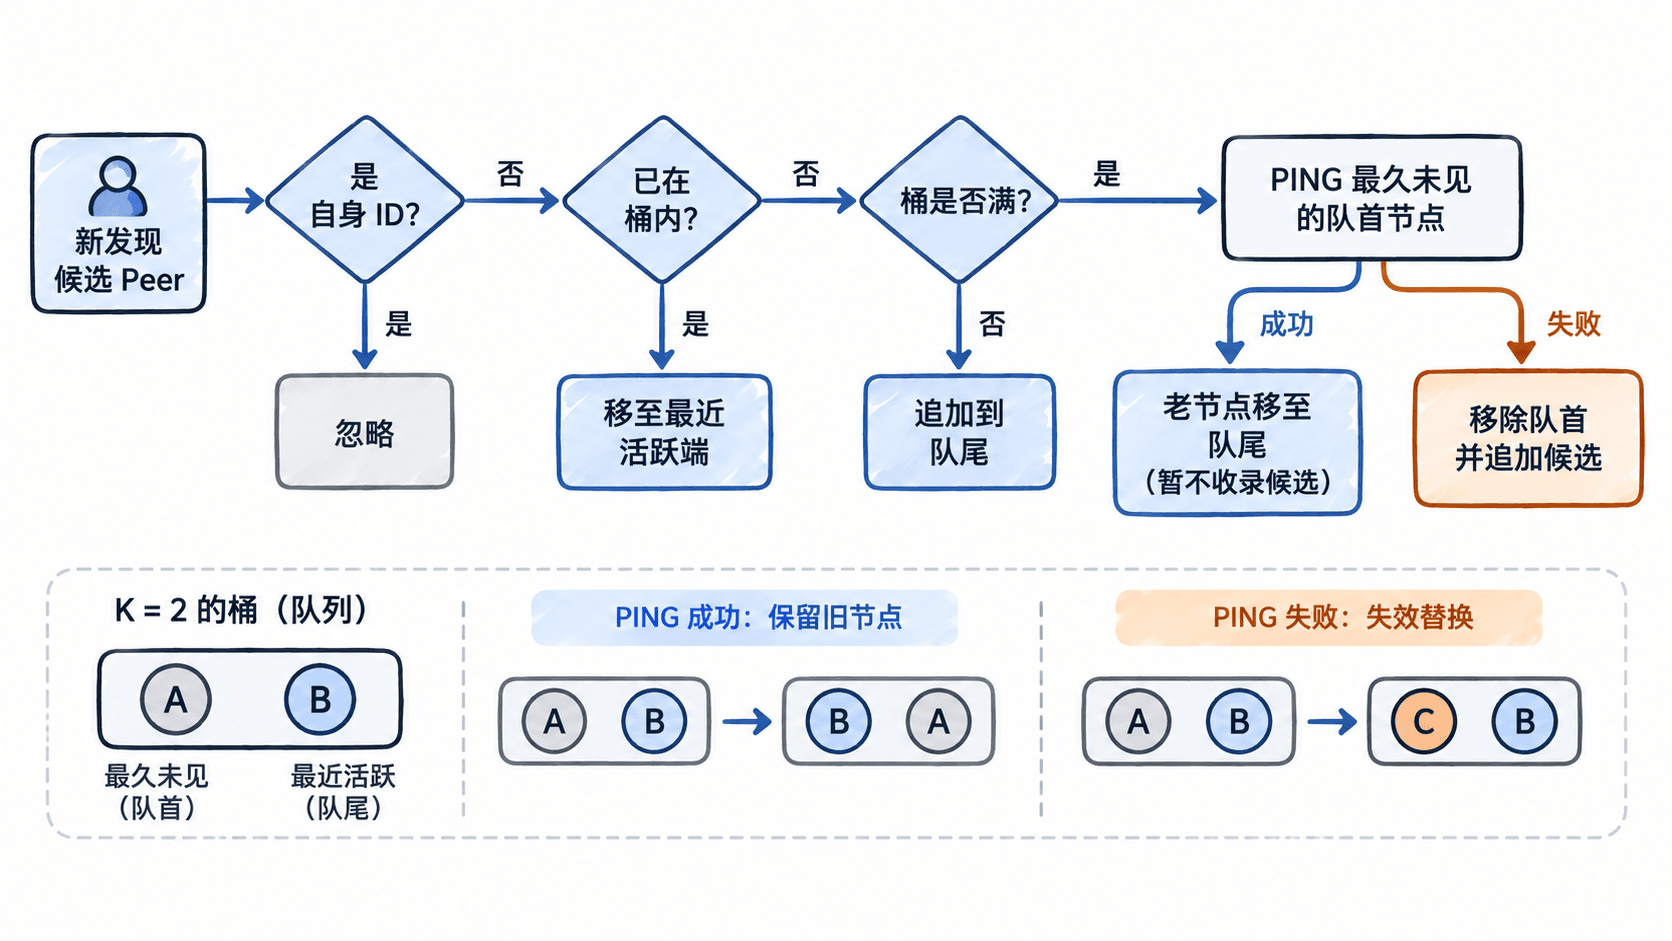
经典 Kademlia 的每个桶最多保存 K 个联系人,顺序从最久未见到最近确认活跃。已有节点再次被有效通信确认后移到队尾;新节点进入未满的桶时直接排在队尾。
当桶已经装满,不是直接踢掉最老的节点,而是先探测队首联系人:
- 如果队首能响应 PING,就把它移到队尾,原候选暂不写入这个桶。
- 如果探测判定队首失效,就删除该联系人,把候选追加到队尾。
- 如果候选已在桶中,只更新其最近活跃位置,不重复占用名额。
用 Python 重放节点加入与离线
以下代码在 Python 3.10 及以上版本可直接运行,不依赖第三方库。K=2 是便于观察的教学值;online 是预设的探测结果,不执行真实 libp2p PING。先让桶 4 收录 0x40、0x41,再用新候选 0x42 检查两种分支。
from collections import defaultdict

SELF_ID = 0x50
K = 2
buckets = defaultdict(list)
online = {0x40: True, 0x41: True}

def bucket_index(peer_id):
    distance = SELF_ID ^ peer_id
    if distance == 0:
        return None
    return distance.bit_length() - 1

def show(peers):
    return "[" + ", ".join(f"0x{peer:02X}" for peer in peers) + "]"

def observe(peer_id):
    index = bucket_index(peer_id)
    if index is None:
        return "跳过自身"
    bucket = buckets[index]
    # 桶内按最久未见到最近活跃排列。
    if peer_id in bucket:
        bucket.remove(peer_id)
        bucket.append(peer_id)
        return f"刷新 0x{peer_id:02X}"
    if len(bucket) == K:
        oldest = bucket.pop(0)
        # 以测试状态模拟 PING 响应;这里不发网络请求。
        if online.get(oldest, True):
            bucket.append(oldest)
            return f"保留 0x{oldest:02X},拒绝 0x{peer_id:02X}"
        bucket.append(peer_id)
        return f"淘汰 0x{oldest:02X},加入 0x{peer_id:02X}"
    bucket.append(peer_id)
    return f"加入 0x{peer_id:02X},桶{index}"

# 先让各距离段有节点,并使桶 4 装满。
for peer in (0x51, 0x53, 0x54, 0x58, 0x40, 0x41, 0x70, 0x10, 0xD0):
    observe(peer)

print("非空桶号:", sorted(buckets))
print("桶4初始:", show(buckets[4]))
print("在线检测:", observe(0x42))
print("桶4更新:", show(buckets[4]))
online[0x41] = False
print("离线检测:", observe(0x42))
print("桶4更新:", show(buckets[4]))
print("重复发现:", observe(0x40))
print("桶4最终:", show(buckets[4]))
预期输出:
非空桶号: [0, 1, 2, 3, 4, 5, 6, 7]
桶4初始: [0x40, 0x41]
在线检测: 保留 0x40,拒绝 0x42
桶4更新: [0x41, 0x40]
离线检测: 淘汰 0x41,加入 0x42
桶4更新: [0x40, 0x42]
重复发现: 刷新 0x40
桶4最终: [0x42, 0x40]
第一次桶满时,探测 0x40 成功,所以它留在表中并移到队尾,队首变成 0x41。之后将 0x41 的模拟状态改为离线,再次提交 0x42,才会发生替换。最后重新观察 0x40,只改变顺序,不增加桶内节点数。
用桶占用检查分布和边界
执行完代码后,桶 0、1、2、3、5、6、7 各有 1 个节点,桶 4 有 2 个,总计 9 个;所有桶都没有超出 K=2。这说明容量限制是按桶执行的,不是整张表最多只能放 2 个节点。即使桶 7 的距离范围比桶 0 大 128 倍,也不代表它能存放更多条目。
真实部署时还要区分三类状态:Peerstore 中保存的地址未必可拨通;传输层连接成功未必意味着节点已进入 DHT 路由表;路由表中曾经活跃的联系人也可能随后离线。路由表应根据 DHT 的验证和探测结果更新,而不是仅凭发现事件或缓存地址批量写入。
可以把示例中的 0x42 改为 0x43 再运行:它与 0x50 的 XOR 距离为 19,仍进入桶 4,替换逻辑不变。工程中的 K 常取 20,例如 libp2p Kad-DHT 规范 推荐此值;具体桶结构、候补缓存和失效判断仍以所用实现为准。